Parte VIII: Evaluación empírica
Presentamos las mediciones de Sibuna, registradas por programas de medición incluidos en el repositorio: latencias de primitivas, productos completos bajo un generador de carga externo con contabilidad de CPU y memoria, latencia con la misma carga ofrecida desde un generador en lazo abierto, y una comparación con Anubis, un control de admisión por prueba de trabajo ampliamente desplegado. Una ejecución de la consola con ocho paneles en vivo completa el registro. Cada número de esta parte procede de un archivo de resultados incluido en el repositorio, que cada tabla nombra junto con su hora de generación, o de un registro de diseño. Una prueba funcional superada y una medición de rendimiento responden a preguntas distintas, y una medición en un host no es una clasificación en otro.
Metodología
Los programas de medición son comandos de una sola herramienta en Rust, tools/bench (el binario sibuna-bench), que se ejecuta mediante cargo xtask bench. Otra herramienta registra la ejecución de la consola.
| Programa | Qué mide | Archivo de resultados |
|---|---|---|
cargo xtask bench primitives |
Dieciséis cargas de trabajo de primitivas, más dos filas para la ruta del limitador de tasa con cliente en hash, en una CPU: siete lotes, mediana por operación con la dispersión mín-máx | primitives-latest.json, primitives-latest.md |
cargo xtask bench product |
Daemons completos bajo wrk: rendimiento, percentiles de latencia, tiempo de CPU por petición y memoria residente máxima de Gate y Shield, en los modos forward-auth y proxy inverso |
product-latest.json, product-latest.md |
cargo xtask bench latency |
Percentiles de latencia de las peticiones admitidas a tasas ofrecidas fijas, desde un generador en lazo abierto | latency-latest.json, latency-latest.md |
cargo xtask bench product --anubis |
Las cargas de trabajo de producto completo con Anubis como producto adicional, detrás de caddy respond |
comparison-latest.json, comparison-latest.md |
cargo xtask bench admission --anubis |
Operaciones de admisión por segundo de Sibuna y Anubis en modo forward-auth, desde dos clientes keep-alive | admission-latest.json, admission-latest.md |
sibuna-browser dashboards (tools/browser) |
Una ejecución funcional de la consola: ocho paneles en vivo en Chromium sin interfaz gráfica mientras un generador envía tráfico | console-8-dashboards-2026-10-15.md |
Los archivos .md son resúmenes. Los archivos .json contienen cada repetición, la máquina, la revisión y la ruta, el tamaño y el SHA-256 de cada binario medido. Git conserva el historial, así que el directorio guarda solo los archivos más recientes. Algunos archivos los registró una versión anterior del programa de medición y contienen además filas de una segunda compilación del daemon medida en la misma ejecución; esta parte presenta las filas de Sibuna.
Primitivas
Cada carga de trabajo se ejecuta en siete lotes cronometrados tras un calentamiento sin cronometrar de como máximo 1.000 operaciones. El estado mutable (el conjunto de desafíos gastados, el limitador de tasa) se reconstruye antes de cada lote, fuera del cronómetro. Los cronómetros rodean lotes completos, nunca operaciones sueltas: leer el reloj en cada operación costaría tanto como el trabajo de menos de 100 ns que mide. Por eso no damos percentiles por operación, y la dispersión se mide entre lotes. Damos el lote mediano por operación, con el lote más rápido y el más lento a su lado.
El conjunto de pruebas se ejecuta en un proceso hijo (sibuna-bench primitives-run) fijado a una CPU. En un host compartido, un hilo hermano SMT ocupado o un reloj más bajo ralentiza una ejecución completa, así que la herramienta ejecuta el conjunto tres veces (--rounds) y conserva, por fila, la ronda con la mediana más baja. Dentro de una ronda, las estadísticas son las descritas arriba.
Productos completos
Para cada modo (forward-auth, proxy inverso) y cada modo de protección (Gate, Shield), el programa de medición arranca el daemon en memoria con --algorithm hashcash --difficulty 8 --rate-limit 100000000 --idle-timeout 5 y cuatro workers, uno por CPU de su conjunto. Obtiene una sesión resolviendo el desafío Hashcash del daemon con sibuna-pow, como lo haría un navegador. Después ejecuta cuatro cargas de trabajo con wrk sobre conexiones keep-alive: 2 hilos, 64 conexiones, 5 segundos, 3 repeticiones.
admitted:GET /privatecon una cookie de sesión válida. En modo proxy inverso la petición llega al origen y su respuesta se retransmite; en modo forward-auth el daemon responde200por sí mismo.challenged: la misma petición sin cookie, desde un User-Agent de navegador. El daemon sirve su desafío:200con HTML en modo proxy inverso,401en modo forward-auth.allowed_static:GET /robots.txtdesdecurl/8.0, que ambos modos de protección admiten sin desafío.attack: una sesión válida másq=' OR 1=1--. Solo Shield la rechaza (403). Gate la admite y, en modo proxy inverso, la retransmite al origen.
El origen es un sustituto (sibuna-bench origin): solo biblioteca estándar, un hilo por conexión, keep-alive y una página de 41 bytes. El tiempo de CPU por petición es el tiempo de usuario más el de sistema del daemon, tomado de /proc/<pid>/stat durante la ejecución (ticks de 10 ms), dividido entre las peticiones que contó wrk; la CPU del origen no se incluye. La memoria máxima es VmHWM de /proc/<pid>/status, reiniciada mediante /proc/<pid>/clear_refs antes de cada ejecución, para que cada ejecución informe de su propio máximo. Cada cifra es la mediana de las repeticiones, con el mínimo y el máximo guardados a su lado en el archivo JSON.
wrk es un generador en lazo cerrado: mantiene 64 peticiones en curso. Por tanto, un daemon más rápido recibe más peticiones, y los percentiles de wrk omiten las peticiones que no envió mientras esperaba una respuesta lenta (omisión coordinada). Su p99 muestra cómo se comporta el daemon bajo su propia saturación, no su latencia con una carga dada. El programa de medición de latencia responde a esa pregunta.
Latencia con la misma carga
El generador en lazo abierto (sibuna-bench generate) ejecuta un hilo bloqueante por conexión. Cada una de las 64 conexiones envía GET /private con una sesión según un calendario fijo: la petición \(k\) de una conexión vence en \(t_0 + o + kT\), donde \(o\) es el desfase de la conexión y \(T\) su intervalo, con independencia de las respuestas anteriores. Cuando una respuesta llega después de que venciera la siguiente petición, esa petición sale de inmediato y su latencia cuenta desde su hora de vencimiento, como en wrk2. Cuando la conexión estaba inactiva a la hora de vencimiento, la latencia cuenta desde el envío real, de modo que el exceso de espera del propio generador no se carga al daemon.
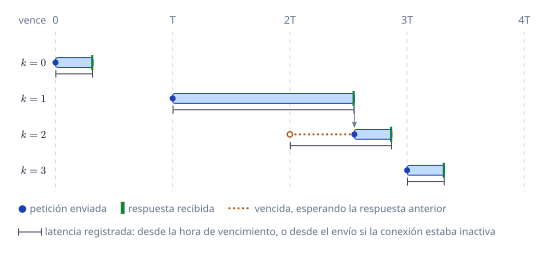
El programa de medición ejecuta el modo de protección Shield y la carga admitida a cinco tasas ofrecidas: 10.000, 25.000, 50.000, 100.000 y 150.000 peticiones por segundo, cada una con 2 segundos de calentamiento, 10 segundos medidos y 3 ejecuciones. El programa puede medir dos compilaciones del daemon en una ejecución: entonces arranca ambas en el mismo conjunto de CPU y alterna entre ellas en cada tasa y repetición, sin que la inactiva use CPU, para que la deriva lenta de la máquina afecte a ambas por igual. La ejecución registrada lo hizo así. Los percentiles son de rango más cercano sobre todas las peticiones medidas de una ejecución; cada cifra es la mediana de las tres ejecuciones, con el mín-máx del p99 a su lado.
Conjuntos de CPU
Los conjuntos de CPU importan más que cualquier otro ajuste. Los daemons se ejecutan en las CPU 0 a 3 (--cpus; --workers es el tamaño de ese conjunto). wrk, el generador de latencia y el origen se ejecutan en las CPU 8 a 15 (--load-cpus). El conjunto de primitivas se ejecuta en la CPU 4 (--cpu). Cada proceso se fija con taskset -c antes de arrancar, de modo que cada hilo que crea hereda el conjunto. El programa de medición de admisión usa dos CPU, 0 y 1, para el producto, y las CPU 8 a 15 para sus clientes.
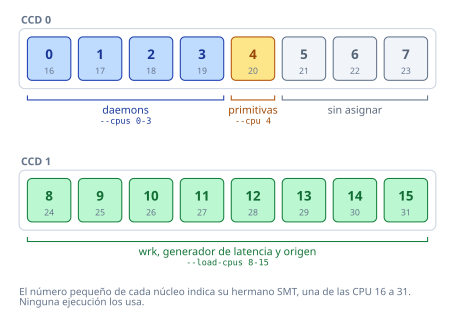
En otras máquinas elegimos conjuntos que no compartan núcleos (lscpu -e muestra la topología).
Máquina y condiciones
Los archivos se registraron en paxos-zig: un AMD Ryzen 9 5950X 16-Core Processor (32 CPU lógicas), Linux 7.0.0-28-generic x86_64, el gobernador powersave con boost activado, rustc 1.99.0. Los archivos de primitivas, producto y latencia se registraron el 15 de octubre de 2026, y la comparación con Anubis el 16 de octubre de 2026. El daemon es cargo build --release -p sibuna, la compilación por defecto con almacenamiento SQLite y la consola incluida (SID 0010); los archivos de producto y latencia nombran un binario de 49.113.856 bytes. Cada archivo registra su revisión (efce14d para las primitivas, 249d913 para las ejecuciones de producto y latencia) con dirty: true; el árbol de trabajo de esta última ya contenía los hilos de conexión reutilizados que registra el SID 0002, y el SID 0002 cita latency-latest.md para su efecto. Los archivos de comparación y admisión nombran la revisión 54e4ec5 con dirty: true, porque el árbol de trabajo contenía las adiciones al programa de medición en tools/bench; su daemon es una compilación release de esa revisión (37.450.232 bytes). Sus cargas medias de un minuto fueron 3,53 antes de la ejecución de comparación y 0,56 al terminar la ejecución de admisión.
Los archivos registran cargas medias de un minuto de 2,46 en la ejecución de primitivas, 1,30 antes y 52,31 después de la ejecución de latencia, y 52,31 antes y 33,39 después de la ejecución de producto. Las cifras altas se deben a los 64 hilos del generador de latencia, a los que siguió directamente la ejecución de producto.
Cómo reproducirlas
Necesitamos Linux, taskset (util-linux) y wrk en PATH.
cargo xtask bench primitives
cargo xtask bench product
cargo xtask bench latency
cargo xtask bench help
cargo xtask bench compila primero el daemon con cargo build --release -p sibuna y después ejecuta sibuna-bench en modo release. La herramienta encuentra el daemon junto a su propio binario; --rust <path> lo sustituye. cargo xtask bench help enumera las opciones, entre ellas --cpus, --load-cpus, --cpu, --rounds, --repetitions, --seconds, --rates y --warmup. La sección sobre Anubis, más abajo, da los comandos que registraron esa comparación.
Latencias de primitivas
La tabla da cada fila de la ejecución de primitivas. El archivo JSON nombra cada fila por subsistema y carga de trabajo (pow_verify y hashcash_16_bits, por ejemplo).
| Carga de trabajo | ns/op | mín-máx |
|---|---|---|
| Verificación Hashcash (16 bits) | 70,2 | 69,9-71,0 |
| Verificación PoSW (profundidad 13, t = 16) | 22.272,4 | 22.257,0-22.316,4 |
| Firmas de bots (40, Aho-Corasick) | 55,7 | 55,3-57,2 |
| Firmas de bots (40, búsqueda secuencial) | 763,0 | 762,2-763,5 |
| Búsqueda CIDR IPv4 | 32,0 | 31,8-32,2 |
| Búsqueda CIDR IPv6 | 79,3 | 78,5-79,6 |
| Token de sesión (BLAKE3 con clave) | 155,8 | 155,3-156,4 |
| Token de sesión (Ed25519) | 40.587,5 | 40.544,6-40.631,1 |
| Conjunto de desafíos gastados (Robin Hood), gastar y consultar | 21,0 | 20,8-21,3 |
| Limitador de tasa (GCRA), bytes del cliente | 12,8 | 12,7-12,8 |
| Limitador de tasa, cuatro ámbitos de regla, bytes del cliente | 13,1 | 13,0-13,2 |
| Limitador de tasa (GCRA), cliente en hash | 6,2 | 6,1-6,3 |
| Limitador de tasa, cuatro ámbitos de regla, cliente en hash | 6,3 | 6,2-6,4 |
| Análisis HTTP y cookie | 132,5 | 132,3-133,2 |
| Clasificación, perfil Shield | 790,8 | 787,2-793,1 |
| Clasificación, perfil Gate | 75,9 | 75,6-76,1 |
| Exploración WAF del cuerpo (8 KiB) | 12.784,3 | 12.771,5-12.809,2 |
| Exploración WAF del cuerpo (8 KiB), inyección SQL en auditoría | 15.485,4 | 15.460,9-15.530,1 |
Las dispersiones son estrechas: ningún lote de ninguna fila se aleja más de un 2,8% de la mediana de su fila. La figura muestra las mismas filas en escala logarítmica, que permite leer una junto a otra filas de 6 ns y de 40 us.
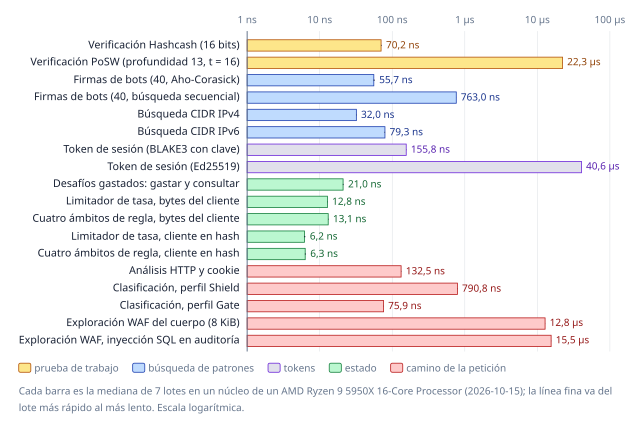
benchmarks/results/primitives-latest.json.¶Verificación de la prueba de trabajo
La verificación Hashcash calcula el hash de un desafío, un separador y un nonce decimal: 70,2 ns. El verificador de trabajo secuencial comprueba aperturas del grafo: 22.272,4 ns. Sus invocaciones de hash y sus recuentos de compresiones SHA-256 difieren de los de Hashcash porque las entradas tienen longitudes distintas. Ambas filas están limitadas por SHA-256, y sibuna-crypto usa las instrucciones SHA-NI cuando la CPU las tiene, detectadas en tiempo de ejecución (SID 0010).
Búsqueda de patrones
El autómata Aho-Corasick denso y la búsqueda secuencial de subcadenas usan patrones idénticos y la semántica de cualquier coincidencia. El autómata es 13,7 veces más rápido que la búsqueda secuencial con las mismas 40 firmas (55,7 frente a 763,0 ns). Sus tablas usan clases de bytes en lugar de 256 columnas por estado (SID 0006, parte F), lo que mantiene la tabla de firmas de bots en 42.244 bytes (véase la tabla de consumo de recursos más abajo). Los clasificadores CIDR tardan 32,0 ns (IPv4) y 79,3 ns (IPv6).
Tokens
El token MAC BLAKE3 se verifica en 155,8 ns. sibuna-crypto implementa BLAKE3 de forma portable, sin variantes SIMD, que compensan con entradas grandes; pero Sibuna aplica BLAKE3 a entradas de menos de 100 bytes, donde el código portable es rápido. Los tokens compactos Ed25519 se verifican en 40.587,5 ns: el verificador usa dígitos NAF de anchura 5 y 8 y conserva la clave pública decodificada. Una verificación Ed25519 cuesta aproximadamente lo mismo que 260 verificaciones MAC; el MAC es el esquema de tokens por defecto de Sibuna.
Estado
La fila del conjunto de desafíos gastados inserta una etiqueta nueva y la vuelve a consultar: 21,0 ns. La tabla de esta fila tiene 16 particiones de 4.096 posiciones (65.536 etiquetas; el valor por defecto del daemon es 1.048.576), y se vacía en el sitio antes de cada lote, fuera del cronómetro. Por tanto, cada lote sondea memoria residente. Una versión anterior del conjunto de pruebas construía para cada lote una tabla nueva puesta a cero del tamaño por defecto del daemon; medía el tiempo que tarda el núcleo del sistema en mapear las páginas de la tabla en la primera escritura, un coste que un daemon en marcha paga una sola vez, y no es la fila que presentamos.
Las filas del limitador de tasa requieren cuidado. Las dos filas con bytes del cliente (gcra_check y gcra_four_rule_scopes) llaman a la API de bytes: cada comprobación toma la dirección del cliente como bytes y calcula primero un SipHash-1-3 con clave de ella, bajo un secreto obtenido de la aleatoriedad del sistema operativo. La clave secreta impide que nadie calcule direcciones que compartan la ventana de sondeo de una víctima (SID 0010 y la documentación de sibuna-store). Estas filas tardan 12,8 y 13,1 ns.
El daemon no usa la API de bytes en el camino de la petición. Calcula el hash del cliente una vez por petición (ClientHasher) y pasa el hash a cada tabla que consulta. Las dos filas con cliente en hash (gcra_check_hashed y gcra_four_rule_scopes_hashed) miden ese camino, con los hashes calculados antes del bucle: 6,2 y 6,3 ns por comprobación. La diferencia entre las medianas de las filas de bytes y en hash, 6,6 ns, es aproximadamente el precio del hash con clave sobre estas entradas, que el daemon paga una vez por petición y no una vez por tabla.
Analizador HTTP
La fila del analizador analiza una petición de navegador de 400 bytes y busca una cookie: 132,5 ns. La propia prueba de tiempos del crate coincide (crates/http: unos 135 a 180 ns en la misma máquina). El analizador no copia datos; cada campo es un slice del búfer de la conexión.
Motor de políticas
Una clasificación completa de una petición de navegador tarda 790,8 ns, y el perfil Gate 75,9 ns. Las filas dejan vacía la dirección del cliente ya analizada de la petición, así que el motor analiza el texto de la dirección del cliente dentro de la evaluación. El daemon analiza la dirección una vez por petición, antes de la evaluación, de modo que estas filas incluyen un coste pequeño que el daemon paga fuera del motor. Las tablas del motor en el heap suman 209.052 bytes (SID 0002).
Inspección WAF
La exploración semántica de un cuerpo de 8 KiB tarda 12.784,3 ns, es decir, \(12784.3 / 8192 \approx 1.56\) ns por byte. La segunda fila explora el mismo cuerpo con la categoría de inyección SQL en auditoría y las demás aplicadas: 15.485,4 ns. Cuando alguna categoría está en auditoría en lugar de aplicada, cada campo se inspecciona por categoría (SID 0004, "inspection modes"). El motor explora el campo con el autómata de firmas una sola vez, para el conjunto de categorías cuyas firmas aparecen, y después busca solo las categorías deseadas entre ellas; así, auditar una categoría cuesta aproximadamente una quinta parte más que aplicarlas todas, no una exploración por categoría.
Comparación de productos completos
Las tablas dan las medianas de tres ejecuciones de wrk de cinco segundos para cada modo de protección y carga de trabajo. El estado junto a cada carga de trabajo es la respuesta que el programa de medición esperaba y recibió.
Modo forward-auth
El proxy de entrada pregunta al daemon si debe admitir una petición; no hay origen ni retransmisión del cuerpo, así que esta es la medida más pura del coste de admisión.
| Modo de protección | Carga de trabajo (estado) | req/s | p50 | p90 | p99 | CPU us/req | RSS máx. KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
211.345 | 151 | 175 | 305 | 11,84 | 15.912 |
| Gate | challenged (401) |
198.315 | 160 | 180 | 326 | 13,15 | 16.176 |
| Gate | allowed_static (200) |
211.053 | 152 | 175 | 305 | 11,73 | 16.176 |
| Gate | attack (200) |
211.618 | 151 | 176 | 305 | 11,84 | 16.176 |
| Shield | admitted (200) |
208.101 | 152 | 178 | 308 | 12,87 | 15.928 |
| Shield | challenged (401) |
197.532 | 161 | 183 | 327 | 13,77 | 16.192 |
| Shield | allowed_static (200) |
211.636 | 151 | 175 | 305 | 11,78 | 16.192 |
| Shield | attack (403) |
210.549 | 152 | 175 | 307 | 12,32 | 16.192 |
En modo forward-auth el daemon no es el cuello de botella. Sus núcleos ocupados (tiempo de CPU dividido entre tiempo real, cores_busy_median en el archivo JSON) se mantienen entre 2,47 y 2,72 de las cuatro CPU del daemon, y todas las filas quedan entre 197.532 y 211.636 peticiones por segundo. Eso indica que el techo lo pone el generador de carga. Cerca de ese techo, una diferencia de un pequeño porcentaje entre filas cambia de una ejecución a otra: solo la fila admitted de Gate abarca de 205.151 a 211.513 peticiones por segundo en sus tres ejecuciones. La cifra más útil en este modo es el tiempo de CPU por petición: de 11,73 a 13,77 us, algo más para Shield que para Gate, y aún más para las filas challenged, que generan la respuesta de desafío.
Modo proxy inverso
El daemon se sitúa delante del origen sustituto y retransmite las peticiones admitidas y las respuestas. Por tanto, las filas retransmitidas incluyen el propio coste del origen y un salto loopback adicional.
| Modo de protección | Carga de trabajo (estado) | req/s | p50 | p90 | p99 | CPU us/req | RSS máx. KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
142.498 | 427 | 548 | 768 | 27,68 | 15.896 |
| Gate | challenged (200) |
199.465 | 160 | 181 | 324 | 12,98 | 16.160 |
| Gate | allowed_static (200) |
147.303 | 411 | 541 | 759 | 26,88 | 16.324 |
| Gate | attack (200) |
143.900 | 422 | 555 | 745 | 27,67 | 16.348 |
| Shield | admitted (200) |
138.965 | 438 | 571 | 857 | 28,57 | 16.064 |
| Shield | challenged (200) |
195.188 | 162 | 185 | 328 | 13,73 | 16.328 |
| Shield | allowed_static (200) |
145.673 | 415 | 551 | 746 | 27,27 | 16.328 |
| Shield | attack (403) |
209.507 | 151 | 177 | 306 | 12,17 | 16.328 |
Aquí las filas retransmitidas (admitted, allowed_static y la fila attack de Gate, que Gate retransmite) están limitadas por la CPU: los núcleos ocupados son de 3,96 a 3,98 de cuatro. Sirven de 138.965 a 147.303 peticiones por segundo con 26,88 a 28,57 us de CPU por petición, aproximadamente el doble del coste de una respuesta que da el propio daemon. Las filas challenged y la fila attack de Shield las responde el propio daemon, y se parecen a las filas de forward-auth. En saturación, el p99 de wrk es la cola del planificador a la tasa propia del daemon, así que leemos en su lugar las colas del capítulo siguiente.
En tres filas de proxy inverso, wrk contó respuestas fuera de las clases 2xx y 3xx donde no se esperaba ninguna: 3 de 2.162.579 peticiones (attack de Gate), 1 de 2.082.640 (admitted de Shield) y 1 de 2.204.358 (allowed_static de Shield), sumadas sobre las tres ejecuciones. Los archivos no registran qué estado tenían. Al reproducir la ejecución con las métricas del daemon aparecieron respuestas 503 contadas en sibuna_overloaded_total: wrk abre sus 64 conexiones desde una sola dirección, exactamente el valor por defecto de --max-connections-per-ip, y cuando una conexión se cerraba tras su petición número 4.096, wrk volvía a conectar antes de que la conexión antigua hubiera devuelto su plaza. Ahora el daemon devuelve la plaza antes de escribir la respuesta de cierre (SID 0002, "bug fix"); las tablas son anteriores a esa corrección.
Consumo de recursos
| Medida | Valor |
|---|---|
| Binario del daemon | 49.113.856 bytes |
| Memoria residente en reposo, ejecuciones de producto | 5.592 a 5.788 KiB |
| Memoria residente máxima durante una carga de trabajo | 15.896 a 16.348 KiB |
| Memoria residente después de las cargas de trabajo | 16.176 a 16.348 KiB |
| Memoria residente en reposo, ejecución de primitivas | 6.052 KiB |
| Tablas del motor de políticas | 209.052 bytes (heap) |
| Tabla de firmas de bots | 42.244 bytes (heap) |
| Tabla WAF | 164.908 bytes (heap) |
| Módulo del solucionador de navegador (WebAssembly) | 14.744 bytes |
Los rangos abarcan las cuatro ejecuciones de producto (dos modos, dos modos de protección) y, para el máximo, sus dieciséis cargas de trabajo. Los tamaños de las tablas son los tamaños en el heap que comunica el motor. El registro no desglosa el tamaño del binario.
Latencia con la misma carga ofrecida
Ambas tablas proceden de una ejecución de cargo xtask bench latency. La columna de errores cuenta los errores de conexión, de E/S y de encuadre del generador.
| req/s ofrecidas | req/s logradas | p50 | p90 | p99 (mín-máx) | p99.9 | máx | Errores | CPU us/req |
|---|---|---|---|---|---|---|---|---|
| 10.000 | 10.000 | 30 | 32 | 37 (36-39) | 58 | 355 | 0 | 16,92 |
| 25.000 | 25.000 | 28 | 31 | 34 (32-34) | 45 | 1.035 | 0 | 15,83 |
| 50.000 | 50.000 | 25 | 27 | 30 (30-30) | 40 | 3.029 | 0 | 13,83 |
| 100.000 | 99.998 | 24 | 26 | 41 (40-42) | 62 | 2.358 | 0 | 13,48 |
| 150.000 | 149.996 | 25 | 36 | 51 (51-52) | 74 | 1.753 | 0 | 14,16 |
| req/s ofrecidas | req/s logradas | p50 | p90 | p99 (mín-máx) | p99.9 | máx | Errores | CPU us/req |
|---|---|---|---|---|---|---|---|---|
| 10.000 | 10.000 | 56 | 61 | 65 (65-66) | 76 | 555 | 0 | 32,25 |
| 25.000 | 25.000 | 51 | 54 | 58 (58-60) | 72 | 1.105 | 0 | 28,63 |
| 50.000 | 50.000 | 47 | 50 | 60 (58-66) | 74 | 3.066 | 0 | 27,45 |
| 100.000 | 99.996 | 55 | 75 | 100 (100-104) | 150 | 2.239 | 0 | 28,42 |
| 150.000 | 134.344 | 583.934 | 1.544.160 | 1.906.273 (1.631.234-2.218.760) | 1.967.134 | 1.989.964 | 4 | 29,22 |
En modo forward-auth, el p50 se mantiene entre 24 y 30 us a todas las tasas. El p99 se mantiene en 51 us o menos hasta 150.000 peticiones por segundo, y el p99.9 en 74 us o menos. El daemon gasta de 13,48 a 16,92 us de CPU por petición.
En modo proxy inverso, el p50 es de 47 a 56 us hasta 100.000 peticiones por segundo, y a 100.000 el p99 es de 100 us y el p99.9 de 150 us. A 150.000 peticiones por segundo el daemon se satura: completa 134.344 peticiones por segundo y la latencia crece hasta segundos, como debe mostrar una prueba en lazo abierto por encima de la capacidad. Esa tasa es cercana al rendimiento del proxy en lazo cerrado del capítulo anterior (138.965 peticiones por segundo para admitted de Shield). Los cuatro errores de esa fila se produjeron en la sobrecarga.
Las dispersiones del p99 son estrechas por debajo de la saturación; la más amplia es la del p99 de proxy inverso a 50.000 peticiones por segundo, de 58 a 66 us. La columna máx es una sola petición de hasta 1,5 millones en una ejecución. En un host compartido la interpretamos como el peor momento del host, no como una propiedad del daemon.
Qué cambió la medición
La carga externa ha cambiado el diseño de Sibuna. El daemon atiende cada conexión en un hilo propio (SID 0002, SID 0010), y sus primeras ejecuciones de latencia encontraron una cola que wrk no había mostrado. Con 64 conexiones, cada una cerrada por el daemon tras 4.096 peticiones, el percentil 99,9 a 100.000 peticiones admitidas por segundo era de 0,3 a 2 ms.
El diagnóstico, registrado en el SID 0002 y en la documentación de cmd/sibuna/src/tasks.rs, es la rotación de hilos. Crear y terminar un hilo mapea y desmapea su pila de señales y devuelve las páginas de su pila, y esos cambios del espacio de direcciones detenían los demás hilos del daemon. Un experimento lo zanjó: una compilación que nunca cerraba conexiones, de modo que no se creaba ningún hilo durante la ejecución, dio de 54 a 60 us a la misma tasa. La corrección reutiliza los hilos de conexión: un hilo que termina su conexión queda aparcado y toma la siguiente, así que un flujo constante de conexiones nuevas no crea hilos. Un hilo aparcado durante 10 segundos termina y lo recoge (join) el siguiente lanzamiento o el siguiente hilo que acabe una tarea, de modo que una ráfaga no deja sus pilas residentes. Un hilo cuya conexión entra en pánico termina en lugar de aparcarse. Como antes, se atienden a la vez como máximo --max-connections conexiones.
Las tablas anteriores proceden de la ejecución posterior a la corrección: un p99.9 de 62 us en modo forward-auth y de 150 us en modo proxy inverso a 100.000 peticiones por segundo. Las ejecuciones anteriores a la corrección no se conservan como archivos de resultados, por lo que sus cifras aparecen solo en el SID 0002 y en esta sección.
Sibuna y Anubis
Anubis, de Techaro, es un control de admisión por prueba de trabajo ampliamente desplegado que se sitúa delante de los sitios web, de forma muy parecida a Gate de Sibuna. Medimos el binario oficial de la versión v1.27.0 de Anubis (anubis-1.27.0-linux-amd64, 40.001.698 bytes) junto a Sibuna en el mismo host, en las mismas CPU y con las mismas cargas de trabajo. Los dos archivos de resultados se registraron con:
cargo xtask bench product --anubis <path/to/anubis>
cargo xtask bench admission --anubis <path/to/anubis>
Anubis se arrancó como lo arrancaban los scripts de Python anteriores de este proyecto: --bind, --metrics-bind, --target= (vacío en modo forward-auth, el origen en modo proxy inverso), --difficulty 2, --slog-level ERROR, --cookie-secure=false y una política que desafía a todo User-Agent Mozilla con DNSBL y el honeypot desactivados. GOMAXPROCS es igual al número de workers de Sibuna, y cada hilo de ambos productos se fija al mismo conjunto de CPU. El trabajo de Hashcash está igualado: 8 bits a cero para Sibuna, 2 dígitos hexadecimales a cero para Anubis, los mismos 256 hashes esperados. El programa de medición obtiene la sesión de cada producto como lo haría un navegador. Para Anubis, descarga la página de desafío, lee el desafío de <script id="anubis_challenge">, encuentra el nonce cuyo SHA-256(randomData || nonce) empieza por 00 y lo pasa a pass-challenge con la cookie de verificación de la página. En modo forward-auth, las cargas admitted y challenged consultan el endpoint de comprobación de Anubis (/.within.website/x/cmd/anubis/api/check).
Cargas de trabajo de producto completo
Las cuatro cargas de trabajo, la carga y las estadísticas son las del programa de medición de producto completo, con un cambio: el origen es caddy respond, fijado a las CPU de carga, como hacían los scripts anteriores. Antes de cada ejecución, el programa espera hasta que queden menos de 3.000 sockets en TIME_WAIT, porque las ejecuciones de Anubis en proxy inverso dejan decenas de miles.
| Carga de trabajo | Cifra | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s (estado) | 210.682 (200) | 208.635 (200) | 36.509 (200) |
| p99 us | 305 | 308 | 7.477 | |
| CPU us/req | 12,09 | 13,21 | 106,30 | |
| RSS máx. KiB | 16.228 | 16.316 | 32.624 | |
challenged |
req/s (estado) | 198.251 (401) | 193.087 (401) | 113.170 (401) |
| p99 us | 326 | 342 | 3.781 | |
| CPU us/req | 13,49 | 15,02 | 32,96 | |
| RSS máx. KiB | 16.240 | 16.328 | 32.696 | |
allowed_static |
req/s (estado) | 212.569 (200) | 212.444 (200) | 89.904 (200) |
| p99 us | 304 | 304 | 4.547 | |
| CPU us/req | 11,73 | 11,95 | 41,63 | |
| RSS máx. KiB | 16.240 | 16.328 | 33.396 | |
attack |
req/s (estado) | 212.086 (200) | 211.347 (403) | 36.853 (200) |
| p99 us | 305 | 306 | 7.283 | |
| CPU us/req | 12,07 | 12,56 | 104,88 | |
| RSS máx. KiB | 16.240 | 16.328 | 33.764 |
| Carga de trabajo | Cifra | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s (estado) | 106.376 (200) | 103.298 (200) | 19.398 (200) |
| p99 us | 3.331 | 3.321 | 11.062 | |
| CPU us/req | 27,02 | 27,92 | 190,40 | |
| RSS máx. KiB | 16.528 | 16.444 | 39.980 | |
challenged |
req/s (estado) | 198.402 (200) | 197.327 (200) | 28.842 (200) |
| p99 us | 325 | 328 | 9.546 | |
| CPU us/req | 13,05 | 13,78 | 137,73 | |
| RSS máx. KiB | 16.544 | 16.464 | 516.872 | |
allowed_static |
req/s (estado) | 105.427 (200) | 106.819 (200) | 28.862 (200) |
| p99 us | 3.320 | 3.316 | 30.124 | |
| CPU us/req | 26,24 | 26,52 | 135,41 | |
| RSS máx. KiB | 16.544 | 16.464 | 616.548 | |
attack |
req/s (estado) | 105.616 (200) | 210.483 (403) | 23.399 (200) |
| p99 us | 3.327 | 306 | 14.124 | |
| CPU us/req | 26,98 | 12,28 | 169,04 | |
| RSS máx. KiB | 16.544 | 16.464 | 599.516 |
En modo forward-auth, Sibuna sirvió de 193.087 a 212.569 peticiones por segundo con un p99 de 304 a 342 us, y Anubis de 36.509 (admitted) a 113.170 (challenged) con un p99 de 3.781 a 7.477 us. Los núcleos ocupados de Sibuna se mantuvieron entre 2,49 y 2,90 de cuatro, así que el límite lo puso el generador de carga; los de Anubis fueron de 3,73 a 3,88, así que Anubis estaba limitado por la CPU. La cifra más clara es el tiempo de CPU por petición: una petición admitida costó 12,09 us a Sibuna Gate y 106,30 us a Anubis. Una parte probable de esa diferencia es el token de sesión. Anubis firma las sesiones con Ed25519 por defecto, y Sibuna comprueba un MAC BLAKE3 con clave (155,8 ns en la tabla de primitivas); las mediciones de admisión de más abajo, en las que los tokens HS512 aumentan en más de la mitad las comprobaciones de sesión de Anubis, respaldan esa interpretación.
En modo proxy inverso, las filas retransmitidas de Sibuna sirvieron de 103.298 a 106.819 peticiones por segundo con 2,77 a 2,98 núcleos ocupados. Quedan por debajo de las 138.965 a 147.303 del origen sustituto en product-latest.json, y el daemon no está limitado por la CPU, así que el límite está fuera de él: el origen, caddy respond, comparte las CPU de carga con wrk. Su cola se ve en el p90 de 2,1 a 2,4 ms. Anubis sirvió de 19.398 a 28.862 peticiones por segundo con 3,68 a 3,97 núcleos ocupados y de 135 a 190 us de CPU por petición. Su memoria residente subió de 39.980 KiB en la carga admitted a 516.872 KiB en challenged y 616.548 KiB en allowed_static, y retenía 589.276 KiB después de las cargas, frente a 21.552 KiB en reposo. La subida empezó en challenged, donde cada petición recibe un desafío nuevo con su propio id; esto sugiere un registro guardado por cada desafío emitido, pero el programa de medición no confirmó la causa. El máximo de Sibuna se mantuvo entre 16.228 y 16.544 KiB en todas las filas de ambos modos.
Varias filas tampoco son comparables de forma directa:
- En modo forward-auth, Anubis responde por sí mismo
/robots.txty la rutaattackcon200, sin origen; Sibuna las responde como responde a cualquier petición en ese modo. - Anubis no inspecciona las peticiones, así que admite la inyección SQL de la carga
attack. Shield la rechaza con403, tras más trabajo; Gate la admite, como hace Anubis. - Los productos firman las sesiones de forma distinta (Ed25519 por defecto en Anubis, un MAC BLAKE3 con clave en Sibuna) y generan páginas de desafío distintas.
Operaciones de admisión
El programa de medición de admisión cronometra las cuatro operaciones de las que se compone la admisión, en modo forward-auth, con cada producto en dos CPU (dos workers de Sibuna, GOMAXPROCS=2). Dos hilos cliente en las CPU de carga, cada uno con una conexión keep-alive, se reparten cada lote: 200 operaciones, o 64 pruebas para la verificación, preparadas antes del lote. Damos la mediana de siete lotes.
- Comprobación de sesión: el endpoint de comprobación con una sesión válida (
200). - Comprobación sin autenticar: lo mismo sin cookie (
401). - Arranque del desafío: lo que descarga un navegador para empezar un desafío. Para Sibuna son dos peticiones, la página intermedia y el registro de desafío; para Anubis una, la página con el desafío integrado.
- Verificación de la prueba: una prueba nueva por operación. Los desafíos de prueba de Sibuna se emiten con 25 ms de separación, por debajo de los 50 por segundo a partir de los cuales su dificultad adaptativa añade bits, de modo que el trabajo igualado se mantiene. Sibuna se ejecuta con
--challenge-rate-limit 100000000, así que su limitador se comprueba pero nunca se agota.
Anubis se ejecutó dos veces, con sus tokens Ed25519 por defecto y con --hs512-secret.
| Producto (token) | Comprobación de sesión | Comprobación sin autenticar | Arranque del desafío | Verificación de la prueba | RSS después, KiB |
|---|---|---|---|---|---|
| Sibuna (BLAKE3 con clave) | 88.104 | 78.997 | 42.664 | 57.924 | 7.792 |
| Anubis 1.27.0 (Ed25519) | 10.951 | 28.619 | 7.893 | 12.668 | 33.400 |
| Anubis 1.27.0 (HS512) | 16.976 | 27.785 | 7.952 | 19.261 | 29.840 |
Los rangos de los siete lotes están en el archivo. Los de Sibuna quedan dentro de un 11% de sus medianas; los de Anubis son más amplios (sus comprobaciones sin autenticar con tokens Ed25519 abarcan de 25.394 a 32.741), y un lote de 200 operaciones dura solo de 2 a 25 ms, así que leemos estas cifras con una precisión de aproximadamente una décima. El tiempo por operación del cliente más lento da el tiempo de ida y vuelta: 22,7 us para una comprobación de sesión de Sibuna, 182,5 us para una comprobación de Anubis con tokens Ed25519 y 117,7 us con HS512.
En ninguna de las filas anteriores Anubis sirvió más peticiones, ni usó menos CPU o memoria, que Sibuna. Esa es una afirmación sobre estas cargas de trabajo en este host, y nada más.
Sobrecarga de la consola
El SID 0007 fija el contrato de aislamiento de la consola. Activar la consola puede costar como máximo un 1% del rendimiento del plano de datos y como máximo un 10% de la latencia p99, medidos sobre una matriz de configuraciones (excluida de la compilación, compilada pero desactivada, en reposo y con ocho paneles activos) y de cargas de trabajo, con ejecuciones repetidas e intercaladas y indicando la incertidumbre. Las ejecuciones no concluyentes o ruidosas no demuestran el cumplimiento, y las referencias de primitivas y las pruebas de humo no pueden sustituir a la prueba de aceptación.
El SID 0010 registra una medición: con la consola compilada, ya sea desactivada, solo con almacenamiento o activada y en reposo, las 16 cargas de trabajo de producto se mantienen a menos de aproximadamente un 1% del daemon compilado sin ella, lo que está dentro del ruido. El registro no nombra ningún archivo de resultados para ella. La configuración con ocho paneles activos bajo carga no se ha medido, así que la prueba de aceptación formal del SID 0007 sigue abierta.
La ejecución con ocho paneles comprueba el funcionamiento, no la sobrecarga. sibuna-browser dashboards arrancó un daemon release en un nodo SQLite con su consola, cuatro workers y una política que permite /static/*, /about, /missing/* y /broken/* y desafía todo lo demás; un origen de prueba responde /missing/* con 404 y /broken/* con 500. Un generador envió 200 peticiones por segundo durante 30 segundos, rotando diez rutas (una de ellas una inyección SQL), tres User-Agents y 500 direcciones reenviadas. Cada panel se ejecutó en su propio Chromium con su propia sesión: los paneles 1 a 3 como sesiones de administrador, y los paneles 4 a 8 como pantallas murales abiertas con códigos que generó el primero, porque la consola permite cinco inicios de sesión por minuto por dirección y por cuenta.
| Medida | Valor |
|---|---|
| Peticiones del plano de datos | 6.000 en 30,0 s (200 por segundo, 4 hilos, una conexión por petición) |
| Respondidas | 6.000: 200 x 1.200, 401 x 3.000, 403 x 600, 404 x 600, 500 x 600 |
| Errores (sin respuesta) | 0 |
| Latencia p50 / p90 / p99 / máx | 246 / 311 / 373 / 552 us (conexión incluida) |
| VmRSS del daemon al inicio | 36.152 KiB |
| VmRSS del daemon con 8 paneles abiertos | 38.028 KiB |
| VmRSS del daemon después del tráfico | 41.496 KiB (VmHWM 41.496 KiB) |
Los indicadores se leyeron cada dos segundos durante el tráfico y 3 segundos después. Todos los paneles terminaron con los mismos totales (Requests 6.000, Admitted 2.400, Challenged 3.000, Policy denied 600, Origin 4xx 600, Origin 5xx 600), recibieron de 134 a 139 deltas stats, mantuvieron abierto su WebSocket y no informaron de ninguna excepción, error de consola ni violación de Content-Security-Policy. Ocho suscriptores de navegador quedan muy por debajo del límite de 64 de la consola. El daemon de esta ejecución tiene almacenamiento SQLite y la consola, a diferencia de los daemons en memoria del programa de medición de producto, así que su memoria residente no es comparable con la de ellos.
Lo que no se mide
| Tema | Por qué no se mide aquí | Qué ocupa su lugar |
|---|---|---|
| SafeLine community edition 9.x | Se distribuye solo como pila de Docker Compose; el host no tenía daemon de Docker, y la imagen del detector no es una compilación de código abierto que pueda compilarse allí | Datos publicados e informados por el fabricante (comprobados en septiembre de 2026): tasa de detección del 71,65% (balance) y del 76,17% (strict), falsos positivos del 0,07% (balance) y del 0,22% (strict); host mínimo Linux x86_64 o arm64 con SSSE3, 1 núcleo de CPU, 1 GB de RAM, 5 GB de disco, Docker 20.10.14+ y Compose 2.0+ |
| Cloudflare WAF | Un servicio alojado; una medición por loopback mediría la ruta de red, no el WAF | Cuotas publicadas de los planes (comprobadas en septiembre de 2026): reglas personalizadas Free 5, Pro 20, Business 100, Enterprise 1.000; reglas de limitación de tasa Free 1, Pro 2, Business 5, Enterprise 100 |
| Un clúster bajo carga | Todavía ningún programa de medición controla varios nodos sobre una base de datos PostgreSQL | Las propiedades del protocolo que especifica el SID 0011 (una semilla compartida, desafíos ligados al emisor) y su prueba funcional con tres nodos (criterio 2); ninguna medición |
| Almacenamiento en el camino de la petición | Ambos daemons se ejecutan en memoria en todos los programas de medición | SID 0011: un solo hilo de almacenamiento es dueño de todo el SQL, y el camino de la petición nunca lo espera |
| TLS, WAN, navegadores reales | Los programas de medición usan loopback y HTTP; sibuna-pow resuelve las sesiones una vez por caso |
Nada; cada despliegue mide su propia ruta de red |
| El tiempo de resolución del solucionador de navegador | El programa de medición resuelve a 8 bits con el solucionador nativo | El tamaño del módulo indicado arriba; la parte VII explica por qué los tiempos nativos no representan los tiempos de resolución en el navegador |
| Recuentos de asignaciones | El programa de medición no instrumenta el asignador | Las pruebas de estado estacionario de la parte V |
| Aislamiento de la consola con ocho paneles activos bajo carga | La prueba de aceptación formal del SID 0007 no se ha ejecutado | La cifra del SID 0010 (a menos de aproximadamente un 1%, con la consola en reposo) y la ejecución funcional anterior |
Una fila de esta tabla no es una afirmación sobre el rendimiento del producto. Las cifras propias de SafeLine tratan de la calidad de detección, no del rendimiento, y Cloudflare publica cuotas de planes en lugar de costes por petición. Cualquiera con un host Docker puede ejecutar SafeLine detrás de las mismas cargas de wrk.