Parte V: Ingeniería sin asignaciones en Rust
Seguimos una conexión desde la aceptación hasta la respuesta a través de un único búfer fijo, y examinamos las estructuras de datos concurrentes que permiten a muchos hilos de conexión compartir estado sin asignaciones en el heap en el camino de la petición. Donde la seguridad de memoria necesitaría de otro modo una maquinaria propia (contadores de lectores, arenas, tablas de descriptores, cadenas de desmontaje), mostramos cómo la aporta, en su lugar, el sistema de propiedad (ownership) de Rust.
El bucle de conexión
Un hilo por conexión, con un límite
Los workers de aceptación (--workers, uno por CPU por defecto, 64 como máximo) comparten el socket de escucha. Cada conexión aceptada se entrega a un hilo propio con una pila de un megabyte, y el bucle de aceptación vuelve directamente a accept. Un hilo que termina su conexión queda en espera y toma la siguiente, porque crear y terminar un hilo para cada conexión frenaba a los demás hilos (parte VIII, SID 0002). La alternativa, servir cada conexión hasta el final en el hilo de aceptación, fue el primer diseño: daba buenas mediciones con un solo cliente y malas con sesenta y cuatro, porque sesenta de ellos esperaban a que un worker agotara su cuota de 256 peticiones, y la latencia de cola crecía con cada cliente en espera. Con un hilo por conexión, el p99 con 64 conexiones se mantiene por debajo de un milisegundo en todas las cargas de trabajo del producto completo, de 305 us a 857 us (benchmarks/results/product-latest.md; parte VIII).
El número de hilos de conexión está acotado por --max-connections (1.024 por defecto, 8.192 como máximo). Por encima del límite, el bucle de aceptación responde 503 Service Unavailable en el nuevo socket, lo cierra sin crear ningún hilo y cuenta el evento en sibuna_overloaded_total.
fn accept_loop(server: &Arc<Server>, listener: &TcpListener) {
    while !server.is_stopping() {
        let stream = match listener.accept() {
            Ok((stream, _)) => stream,
            // ... sin descriptores ni memoria: espera 1 ms en vez de girar
        };
        let limit = server.max_connections.load(Ordering::Relaxed);
        if server.connections.fetch_add(1, Ordering::Relaxed) >= limit {
            server.connections.fetch_sub(1, Ordering::Relaxed);
            server.metrics.overloaded.bump();
            let text = "Service Unavailable: connection limit reached";
            reject(server, &stream, text);
            continue;
        }
        set_no_delay(&stream);
        let task_server = Arc::clone(server);
        let launched = server.tasks.launch(move || {
            let _counted = Counted(&task_server);
            crate::connection::serve(&task_server, &stream);
        });
        // ... un lanzamiento fallido devuelve la plaza y cuenta una sobrecarga
    }
}
Counted es un guardián cuyo Drop devuelve la plaza de la conexión dentro del límite termine como termine el hilo, por retorno o por pánico. El camino del 503 vacía lo que el cliente ya ha enviado antes de cerrar su lado del socket: cerrar un socket con bytes sin leer provoca un reset, y el reset descartaría el 503.
Los hilos proceden de un TaskPool (cmd/sibuna/src/tasks.rs), una tabla fija de posiciones cuyos hilos admiten join. Un hilo terminado conserva su pila hasta que se hace join sobre él, así que el join de una posición se hace cuando vuelve a ocuparse, y una tarea nueva toma la posición terminada más baja en lugar de avanzar un cursor. Un cursor solo volvería a una posición terminada tras dar una vuelta completa a la tabla, lo que dejaría residentes miles de hilos terminados, y la memoria crecería con las conexiones servidas en lugar de con las conexiones abiertas. Un segundo guardián, Finished, marca la posición como libre cuando la tarea termina, así que una conexión que entra en pánico también libera la suya.
La memoria se acota del mismo modo. Un hilo de conexión guarda en su pila su búfer de lectura de 64 KiB y su búfer de escritura de 16 KiB, y en el heap un espacio de trabajo del proxy de 40 KiB, asignado una sola vez al empezar la conexión. El peor caso es, por tanto, un número conocido y no depende de cuántos sockets pueda abrir un cliente. El recolector de conexiones inactivas (más adelante) cierra las conexiones que dejan de enviar, así que un cliente lento no puede retener un hilo más allá de --idle-timeout.
Selección del asignador
Rust 1.100 estabiliza el núcleo de la API Allocator y los parámetros de asignador de Vec y Box (notas de la versión). Podemos elegir un asignador para una colección sin sustituir el asignador del proceso. Esta API no nos ahorra asignaciones en el recorrido de las peticiones: las peticiones en conexiones ya preparadas no asignan memoria, como comprueban cmd/sibuna/tests/steady_state.rs y crates/net/tests/steady_state.rs. El proxy asigna sus tres búferes una vez por conexión y los reutiliza. El limitador y el conjunto de pruebas usadas también asignan sus tablas una sola vez; las asignaciones inicializadas a cero permiten que las páginas sin tocar sigan sin ocupar memoria residente, como comprueba crates/store/tests/resident.rs.
Antes de cambiar el asignador mediríamos la construcción de instantáneas de políticas y el análisis JSON de la consola. Sus colecciones temporales asignan memoria fuera del recorrido de las peticiones, pero el asignador de una colección no controla automáticamente las asignaciones de sus elementos. Nuestro árbol JSON también conserva cadenas con escapes mediante Cow<str>, cuya forma propia es String; String no tiene un parámetro de asignador en Rust 1.100. Arc::new_in sigue siendo inestable en esta versión (documentación de la API). Los motores publicados se comparten mediante Arc hasta que su último lector los libera, por lo que una reconstrucción no puede restablecer la memoria que aún usa un motor anterior. Una arena tendría que conservar esos tiempos de vida y los límites de entrada del analizador.
Conservamos el asignador global WipeOnFree del módulo WebAssembly de la consola en cmd/console-ui/src/abi.rs. Borra los bloques liberados, incluido el bloque anterior tras una reasignación. Elegir System directamente para una colección omitiría ese borrado. El módulo WebAssembly de prueba de trabajo no tiene asignador de montón, y Argon2 ya usa un espacio de trabajo reutilizado que pertenece al llamador. Por tanto, conservamos los asignadores actuales y la compatibilidad con Rust 1.94 hasta que una carga medida justifique un cambio. Un candidato debe mejorar la latencia o la memoria residente y conservar el borrado, el procesamiento acotado de la entrada y el recorrido de peticiones sin asignaciones.
Un búfer por conexión
Cada asignación dinámica en el camino de una petición es una palanca de denegación de servicio: fragmentación a lo largo de los días, contención del cerrojo del asignador entre hilos y amplificación por atacantes que fabrican peticiones para maximizar las asignaciones. La regla de Sibuna es absoluta: la clasificación, la verificación y la entrega al proxy se ejecutan con cero asignaciones en el heap. El manejador de la conexión posee un búfer de lectura de 64 KiB y un búfer de escritura de 16 KiB durante toda la vida del socket; todo lo demás son slices de ellos.
pub fn serve(server: &Server, stream: &TcpStream) {
    let Some(lease) = server.idle.register(stream) else { return };
    // ...
    let mut read_buffer = [0u8; MAX_REQUEST_BYTES]; // 64 KiB
    let mut write_buffer = [0u8; WRITE_BUFFER]; // 16 KiB
    let mut reader = Reader::new(stream, &mut read_buffer[..]);
    let mut peer = PeerText::default();
    peer.format(stream.peer_addr().ok());
    let mut link = Link {
        server,
        stream,
        writer: Writer::new(stream, &mut write_buffer[..]),
        workspace: Workspace::new(),
        cache: EngineCache::new(),
        activity: lease.activity(),
        last: false,
    };
    for served in 0..MAX_REQUESTS_PER_CONNECTION {
        link.last = served + 1 == MAX_REQUESTS_PER_CONNECTION;
        if !serve_one(&mut reader, &mut link, peer.as_bytes()) {
            break;
        }
        lease.touch();
    }
}
read_head llena el búfer hasta que aparece la línea en blanco, buscando solo en los bytes llegados desde la última búsqueda, y rechaza con 431 los encabezados de más de 16 KiB. parse_request (crate sibuna-http) produce un Request<'a> cuyos método, ruta, consulta, cabeceras y cookies son slices del búfer. El cuerpo declarado se llena hasta donde cabe y se toma como slice a continuación del encabezado. Después, reader.consume(head_len + body_len) hace avanzar el lector, de modo que la siguiente petición keep-alive empieza limpia; el lector solo mueve los bytes no leídos al principio cuando necesita espacio. Un cuerpo chunked se decodifica in situ detrás del encabezado (SID 0009): la delimitación de cada paso se elimina del búfer, de modo que el prefijo decodificado sigue siendo contiguo para la inspección. Las rutas internas están delimitadas por longitud y mantienen abierta la conexión. Las peticiones a través del proxy también la mantienen abierta, siempre que la respuesta del origen esté delimitada y el cuerpo se haya almacenado entero en el búfer; las secciones siguientes muestran cómo decide el proxy.
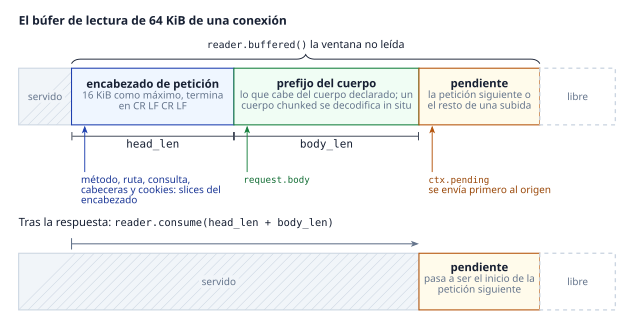
fn serve_one<W: Write>(
    reader: &mut Reader<'_, &TcpStream>,
    link: &mut Link<'_, W>,
    peer: &[u8],
) -> bool {
    let head_len = match read_head(reader) {
        Head::Complete(length) => length,
        Head::TooLarge => { /* 431 "Request head exceeds 16 KB" */ return false; }
        Head::Closed | Head::Failed => return false,
    };
    let framing = {
        let bytes = reader.buffered();
        let head = bytes.get(..head_len).unwrap_or_default();
        let request = match parse_request(head) {
            Ok(request) => request,
            Err(error) => return reject_head(link, error),
        };
        let declared = request.content_length().unwrap_or(0);
        // ... Expect: 100-continue
        if declared == 0 && !request.chunked {
            let upload = Upload::declared(&request);
            let pending = bytes.get(head_len..).unwrap_or_default();
            let keep = dispatch(link, request, pending, upload, 0, peer);
            reader.consume(head_len);
            return keep;
        }
        (declared, request.chunked)
    };
    serve_with_body(reader, link, peer, head_len, framing)
}
La reescritura del encabezado en el proxy
El encabezado no se reenvía literalmente. write_request_head (crates/net/src/request.rs, crate sibuna-net) vuelve a emitir la línea de petición y cada cabecera hacia el escritor del origen, y descarta los campos salto a salto (Connection, Keep-Alive, Proxy-Connection, Transfer-Encoding, TE, Trailer, Upgrade, los campos de autorización del proxy), cualquier campo de reenvío o de auditoría entrante (X-Forwarded-For, X-Real-IP, Forwarded, X-Forwarded-Proto, X-Forwarded-Host, X-Forwarded-Port, X-Sibuna-Status, X-Sibuna-Rule), Expect, Content-Length y cada campo que nombre la cabecera Connection de la petición. Después añade el conjunto de auditoría. La delimitación del cuerpo se genera, nunca se copia:
for header in request.headers() {
    if is_hop_by_hop(header.name) || nominated(request, header.name) {
        continue;
    }
    out.write_all(header.name)?;
    out.write_all(b": ")?;
    out.write_all(header.value)?;
    out.write_all(b"\r\n")?;
}
match upload {
    Upload::None => {}
    Upload::Length(length) => {
        out.write_all(b"Content-Length: ")?;
        write_decimal(out, *length)?;
        out.write_all(b"\r\n")?;
    }
    Upload::Chunked(_) => out.write_all(b"Transfer-Encoding: chunked\r\n")?,
}
Un Content-Length se vuelve a emitir. Un cuerpo chunked que terminó dentro del búfer de la conexión se decodifica in situ y se envía con su longitud. Uno más largo se anuncia como Transfer-Encoding: chunked y se vuelve a dividir en chunks lectura a lectura (SID 0009): cada lectura llega al búfer de subida de 16 KiB del proxy, se decodifica allí in situ y sale como un chunk canónico, de modo que el origen nunca ve los tamaños de chunk, las extensiones ni los trailers del cliente. El conjunto de auditoría:
Connection: keep-alive
X-Forwarded-For: <client>
X-Forwarded-Proto: <scheme>
X-Real-IP: <client>
X-Sibuna-Status: PASS
X-Sibuna-Rule: session | robots-txt | ip/cidr-trie | ...
Los cuerpos mayores que el búfer se retransmiten en trozos de 16 KiB del cliente al escritor del origen (relay_body) antes de devolver la respuesta en streaming. La prueba unitaria proxy_head_rewrite_drops_hop_by_hop_headers_and_injects_audit_fields de crates/net/src/request.rs comprueba que la reescritura descarta un X-Forwarded-For falsificado e inyecta los campos de auditoría.
Los tres búferes del proxy, el búfer de lectura del origen (un encabezado de respuesta, 16 KiB), el búfer de escritura del origen (8 KiB) y el búfer de subida (16 KiB), residen en un Workspace que la conexión asigna una sola vez y reutiliza en cada petición. El espacio de trabajo hace que su vida útil sea la de la conexión, no la del intercambio, y el lector y el escritor del origen los toman prestados para un intercambio cada vez.
Retransmisión de la respuesta del origen
El primer proxy transmitía los bytes del origen hasta que este cerraba y después cerraba la conexión del cliente: una delimitación correcta sin análisis, al precio de una conexión TCP nueva por cada petición a través del proxy. Bajo un generador de carga, ese precio se veía como decenas de miles de sockets en TIME_WAIT y, en loopback, como puertos efímeros agotados. Ahora el proxy lee el encabezado del origen (16 KiB como máximo) y clasifica el cuerpo según las reglas de RFC 9112:
pub enum Framing { None, Length(u64), Chunked, UntilClose }

pub fn parse_response_head(
    head: &[u8],
    head_request: bool,
) -> Option<ResponseHead> {
    let status = status_code(head)?;
    let mut fields = FramingFields {
        keep_alive: head.get(7) == Some(&b'1'),
        ..Default::default()
    };
    for line in crlf_lines(head).skip(1) {
        if line.is_empty() {
            break;
        }
        fields.read_line(line)?; // Transfer-Encoding, Content-Length, Connection
    }
    let mut framing = fields.length.map_or(Framing::UntilClose, Framing::Length);
    if head_request || status / 100 == 1 || status == 204 || status == 304 {
        framing = Framing::None;
    } else if fields.encoded {
        framing =
            if fields.chunked { Framing::Chunked } else { Framing::UntilClose };
    }
    let mut keep_alive = fields.keep_alive;
    if framing == Framing::UntilClose || fields.closing {
        keep_alive = false;
    }
    if fields.nominates_framing {
        return None;
    }
    Some(ResponseHead { status, framing, keep_alive })
}
El analizador rechaza lo que el proxy no debe retransmitir: una línea de estado incorrecta, un nombre de campo que no es un token, un byte de control en un valor, longitudes contradictorias, una codificación chunked repetida o que no es la última, y un campo Connection que nombra Content-Length o Transfer-Encoding. Su trabajo es lineal en el encabezado y nunca entra en pánico.
El encabezado se vuelve a emitir hacia el cliente con las cabeceras Connection del origen sustituidas por la decisión propia de Sibuna, y el cuerpo se retransmite con exactitud: copy_exact para una longitud, chunk a chunk (línea de tamaño, datos, trailers) para la codificación chunked, copy_remaining para el caso heredado. Solo el caso heredado cierra la conexión del cliente. Toda retransmisión se basa en un único paso de copia: reenviar lo que la fuente ya tenga y, solo cuando no tenga nada, vaciar el destino y después leer una vez. Así, un flujo de escrituras pequeñas se entrega a medida que se produce, mientras que una transferencia masiva sigue moviendo un búfer completo por lectura y escritura.
let keep = client_keep_alive && parsed.framing != Framing::UntilClose;
write_client_head(client, head, keep).map_err(client_head_error)?;
origin.consume(head_length);
match parsed.framing {
    Framing::None => {}
    Framing::Length(length) => copy_exact(origin, client, length, progress)?,
    Framing::Chunked => relay_chunked(origin, client, progress)?,
    Framing::UntilClose => copy_remaining(origin, client, progress)?,
}
client.flush().map_err(|_| ProxyError::ClientFailed)?;
Ok(Relayed { client_keep: keep, origin_reusable: parsed.keep_alive })
Analizar un encabezado de origen de ocho campos tarda 322 ns, y un GET keep-alive con una respuesta de 1 KiB a través del proxy por loopback tarda 29,8 us (medido en octubre de 2026; crates/net/src/lib.rs documenta la medición).
El conjunto de conexiones al origen
Analizar la delimitación también le dice al proxy si el socket del origen puede volver a usarse: una respuesta HTTP/1.1 sin Connection: close (o una HTTP/1.0 con keep-alive) cuyo cuerpo se consumió entero deja el socket en una frontera limpia entre peticiones. Esos sockets van a un conjunto fijo de 256 conexiones inactivas al origen, y la siguiente petición a través del proxy toma una en lugar de abrir una conexión. Sin el conjunto, cada petición a través del proxy abre una conexión nueva al origen, y cada conexión cerrada retiene su puerto local en TIME_WAIT; bajo carga, un proxy en loopback se queda pronto sin puertos efímeros y su rendimiento se desploma.
Un conjunto bajo un único cerrojo haría que todas las peticiones a través del proxy compitieran por ese cerrojo. Por eso el conjunto (crates/net/src/pool.rs) está dividido en franjas: 16 franjas de 16 sockets, cada una un Mutex<Vec<Arc<TcpStream>>> en su propia línea de caché. A cada hilo se le asigna una franja propia por turno rotatorio en su primer uso; deposita en ella y toma de ella en primer lugar, y mira en las demás franjas, sin esperar a un cerrojo ocupado, antes de abrir una conexión nueva.
pub fn take(&self) -> Option<Arc<TcpStream>> {
    if self.is_stopping() {
        return None;
    }
    let home = home_stripe();
    if let Some(socket) =
        self.stripe(home).and_then(|stripe| lock(&stripe.sockets).pop())
    {
        return Some(socket);
    }
    (1..STRIPES).find_map(|offset| {
        let stripe = self.stripe((home + offset) % STRIPES)?;
        try_lock(&stripe.sockets)?.pop()
    })
}
Puede que el origen haya cerrado un socket del conjunto mientras estaba inactivo. El proxy lo detecta de una de dos maneras, una escritura fallida o un fin de flujo antes del primer byte de la respuesta, y en ambos casos todavía no ha llegado nada al cliente, así que cierra el socket y reintenta una vez con una conexión nueva, nunca con otra del conjunto: tras un periodo de inactividad todos los sockets del conjunto pueden estar caducados, y la primera versión de este reintento, que tomaba un segundo socket del conjunto, respondía 502 a la primera petición después de cada periodo de calma. El reintento solo se permite para un método seguro (GET, HEAD, OPTIONS) cuyo cuerpo se almacenó entero en el búfer. La falta de respuesta no demuestra que el origen no haya aplicado ya una modificación, y un cuerpo retransmitido por trozos no puede volver a enviarse; en ambos casos el cliente recibe 502.
let safe = matches!(request.method, Method::Get | Method::Head | Method::Options);
let buffered = exchange.upload.is_buffered(request.body.len());
let retryable = safe && buffered;
for attempt in 0..2 {
    // Un reintento siempre abre una conexión nueva: tras una pausa, todo
    // socket del conjunto puede estar caducado, y un segundo socket
    // caducado haría fallar la petición.
    let pooled = if attempt == 0 { pool.take() } else { None };
    // ... conecta si el conjunto no dio nada, adjunta a Activity, intercambia
    match outcome {
        Ok(relayed) => {
            if relayed.origin_reusable {
                pool.give(origin);
            }
            return Ok(relayed.client_keep && buffered);
        }
        Err(error) => {
            drop(origin);
            let stale = was_pooled
                && retryable
                && matches!(
                    error,
                    ProxyError::UpstreamClosed | ProxyError::UpstreamWriteFailed
                );
            // ... cualquier otro error se notifica de inmediato
        }
    }
}
Las pruebas unitarias retransmiten cadenas de bytes fijas a través de las mismas funciones y comprueban que la salida es idéntica byte a byte salvo la cabecera de conexión (crates/net/src/relay/tests.rs). Una prueba de extremo a extremo del daemon envía dos peticiones a través del proxy por un mismo socket de cliente y comprueba, mediante una cabecera de secuencia que añade el origen simulado, que la segunda reutilizó la conexión al origen del conjunto. Una prueba de vectores en crates/net/tests/ reproduce escenarios de proxy grabados (una petición de cliente en bruto y una respuesta de origen predefinida) y compara cada byte que reciben el origen y el cliente.
Plazos de inactividad
Cada conexión de cliente registra su socket en una IdleTable (crates/net/src/idle.rs) y recibe un Lease. La Activity del lease guarda el momento en que se movieron bytes por última vez en la conexión. El daemon la actualiza tras servir cada petición; el proxy la actualiza en cada lectura del origen y por cada 16 KiB de subida, y adjunta el socket del origen del intercambio en curso. El hilo recolector se despierta cada cuarto del plazo más corto (entre 200 ms y un segundo) y cierra cada conexión que lleve en silencio más tiempo que su plazo, junto con el socket del origen adjunto, de modo que el hilo bloqueado en cualquiera de los dos lados ve el fin del flujo y libera su posición.
Por tanto, los plazos miden el silencio, nunca la duración de una respuesta: una descarga grande que sigue avanzando nunca se corta. Los bytes de subida vienen del lado no fiable y solo renuevan la marca de tiempo cada 16 KiB, lo que exige al cliente al menos 16 KiB por periodo de inactividad: la misma defensa contra cuerpos lentos que dan los plazos de petición con tasa mínima de transferencia.
La tabla tiene un pequeño cerrojo por posición y ningún cerrojo para toda la tabla. Guarda un try_clone de cada socket de cliente y un Arc de cada socket de origen adjunto, por el motivo explicado arriba. Un Lease da de baja su conexión en Drop, y una posición recolectada sigue perteneciendo a su lease hasta entonces, así que una conexión antigua nunca puede liberar una posición que haya tomado una nueva.
Conexiones con cambio de protocolo
Tras un 101 validado, una conexión que cambia a WebSocket se retransmite en ambos sentidos. Cada sentido se ejecuta en un hilo propio con un único búfer fijo: el propio hilo de la conexión lleva los bytes del origen al cliente, y un hilo con ámbito (scoped) con una pila de 128 KiB lleva los bytes del cliente al origen. Un solo hilo podría servir ambos sentidos con poll(2), pero la biblioteca estándar de Rust no lo expone; dos hilos con plazos de socket mantienen la retransmisión libre de unsafe. Una conexión que ha cambiado de protocolo ocupa, por tanto, dos hilos, así que el número de hilos de conexión puede llegar al doble de --max-connections cuando todas las conexiones han cambiado de protocolo.
Ambos sentidos comparten un mismo plazo de inactividad (--websocket-idle-timeout, 300 segundos por defecto): los bytes que se mueven en cualquier sentido renuevan una única marca de tiempo. Cada espera en un socket lleva un plazo igual al tiempo restante; una espera que vence vuelve a leer la marca compartida y espera de nuevo el resto o termina la retransmisión. Cuando un sentido llega al fin del flujo, se cierra el lado de envío del otro socket (un cierre parcial); cuando un sentido falla, se cierran ambos sockets para que el otro sentido también termine. Antes de pasar por el proxy un cambio de protocolo, la conexión libera su motor de políticas en caché, para que una conexión que puede vivir horas no mantenga vivo un motor antiguo.
Parada
Running::stop, e igualmente Drop para Running, detiene el daemon en un orden fijo. Activa el indicador de parada y despierta a cada worker de aceptación conectándose al listener, hace join de los workers, cierra cada socket de cliente registrado y su socket de origen adjunto (IdleTable::shutdown), detiene el conjunto de conexiones al origen, hace join de cada hilo de conexión, hace join del recolector y cierra los sockets del conjunto.
SIGINT y SIGTERM llegan a esa secuencia con Rust corriente. Antes de lanzar ningún hilo, el daemon bloquea ambas señales (todos los hilos posteriores heredan la máscara) y dedica un hilo a sigwait, que registra la orden de parada y despierta de inmediato al hilo principal. No se ejecuta código en un manejador de señales, y ningún hilo consulta un indicador en bucle. El módulo de señales (cmd/sibuna/src/signals.rs) contiene el único código unsafe del daemon: las declaraciones de las pocas funciones de la biblioteca de C que std no envuelve.
Lo que medimos
La tabla muestra Shield en modo proxy inverso en un Ryzen 9 5950X: el daemon fijado a cuatro CPU, wrk con dos hilos y 64 conexiones en otras ocho CPU, ejecuciones de cinco segundos, la mediana de tres. Las filas se copian de benchmarks/results/product-latest.md; la parte VIII contiene el registro completo.
| Carga de trabajo | Estado | req/s | p50 / p99 (us) | CPU por petición (us) |
|---|---|---|---|---|
| admitida con sesión, a través del proxy | 200 | 138.965 | 438 / 857 | 28,57 |
| desafiada (página intermedia) | 200 | 195.188 | 162 / 328 | 13,73 |
| estática permitida, a través del proxy | 200 | 145.673 | 415 / 746 | 27,27 |
| denegada por el WAF (con sesión) | 403 | 209.507 | 151 / 306 | 12,17 |
wrk mantiene 64 peticiones en curso, así que en los caminos limitados por CPU a través del proxy las peticiones hacen cola para las cuatro CPU, y el p99 en ellos es la cola del planificador, no el coste de una petición. Un generador en lazo abierto, que envía a una tasa fija y mide cada petición desde su envío previsto, mide en cambio la latencia con la misma carga ofrecida. Para las peticiones admitidas en modo proxy inverso, el p99 es de 65 us a 10.000 peticiones por segundo y de 100 us a 100.000; con 150.000 ofrecidas, las cuatro CPU se saturan, se alcanzan 134.344 peticiones por segundo y la cola crece hasta segundos (benchmarks/results/latency-latest.md). Una conexión keep-alive ya caliente sirve cada decisión sin una asignación en el heap: cmd/sibuna/tests/steady_state.rs cuenta las asignaciones del daemon, y crates/net/tests/steady_state.rs no encuentra ninguna en 500 peticiones keep-alive a través del proxy.
Estado concurrente sin asignaciones
Cada almacén de sibuna-store asigna su capacidad fija una sola vez, al construirse, y después nunca asigna memoria ni se bloquea en un cerrojo global. Ninguno necesita un barrido en segundo plano: el estado caducado se recupera in situ.
Cerrojos y particiones
Las secciones críticas de las tablas de Sibuna tienen decenas de instrucciones, mucho menos que un viaje de ida y vuelta de un futex del kernel. Las tablas se dividen en 16 particiones según el hash de la clave, de modo que dos operaciones compiten con probabilidad \(1/16\), y cada partición ocupa su propia línea de caché, así que los cerrojos vecinos no sufren falso compartimiento (false sharing).
Las tablas usan std::sync::Mutex: una operación compare-and-swap si no hay contención, una breve espera activa mientras el titular se ejecuta y después una espera en futex. La alternativa es un spin lock atómico de dos estados con la pista de espera activa (spin-loop hint) en el bucle de espera. SID 0010 nos pidió elegir entre ambos a partir de mediciones. Un spin lock ahorra alrededor de un nanosegundo por operación sin contención, pero pierde con contención:
| Carga de trabajo | Mutex |
Spin lock |
|---|---|---|
| conjunto de desafíos gastados, 16 hilos | 10,8 M/s | 8,6 M/s |
| conjunto de desafíos gastados, 64 hilos (más hilos que CPU) | 11,2 M/s | 6,9 M/s |
| GCRA sobre seis direcciones calientes, 16 hilos | 44,9 M/s | 19,3 M/s |
| GCRA sobre seis direcciones calientes, 64 hilos | 37,4 M/s | 6,5 M/s |
Un servidor perimetral ejecuta más hilos de conexión que CPU, y un spin lock cuyo titular es desalojado hace que cada hilo en espera agote su cuanto de tiempo, así que mantenemos el mutex. En un cerrojo envenenado se entra en lugar de propagar el envenenamiento: ninguna operación entra en pánico mientras tiene tomada una partición, y la partición sigue siendo estructuralmente válida aunque alguna lo hiciera.
El conjunto Robin Hood de desafíos gastados
Solo las pruebas aceptadas entran en el conjunto de desafíos gastados (parte III). Tiene 16 particiones, cada una un array de direccionamiento abierto de 4.096 posiciones de Option<Entry>, donde una entrada es { tag: [u8; 16], expires_at: u64, dist: u8 }. La inserción Robin Hood (Celis, 1986) desplaza a cualquier ocupante más cercano a su posición inicial que la clave entrante, lo que mantiene muy agrupadas las longitudes de sondeo; las búsquedas se detienen en cuanto encuentran una entrada más cerca de su posición inicial de lo que ellas están de la suya.
fn insert(
    &mut self,
    tag: &Tag,
    expires_at: u64,
    now: u64,
) -> Result<(), SpendError> {
    if !self.can_insert(tag, now) {
        return Err(SpendError::Full);
    }
    let mut carry = Entry { tag: *tag, expires_at, dist: 0 };
    let mut idx = Self::home(tag);
    while carry.dist < MAX_PROBE {
        let slot = &mut self.entries[idx];
        let Some(e) = slot else {
            *slot = Some(carry);
            return Ok(());
        };
        // Sobrescribir un ocupante caducado solo es seguro si la distancia
        // nueva no es menor; así, las claves que sondean más allá de esta
        // posición siguen superando la prueba de terminación anticipada.
        if e.is_expired(now) && carry.dist >= e.dist {
            *e = carry;
            return Ok(());
        }
        if carry.dist > e.dist {
            std::mem::swap(&mut carry, e);
            // Una entrada caducada desplazada simplemente se descarta.
            if carry.is_expired(now) {
                return Ok(());
            }
        }
        idx = (idx + 1) % SHARD_CAPACITY;
        carry.dist += 1;
    }
    Err(SpendError::Full)
}
La regla de las posiciones caducadas es la parte sutil: una entrada caducada solo puede sobrescribirse in situ con una clave al menos igual de lejos de su posición inicial; de lo contrario, una clave posterior que sondee más allá de esa posición se detendría antes de tiempo y se perdería. Las entradas caducadas que resultan desplazadas simplemente se descartan. No hace falta ningún hilo de barrido. La inserción simula primero el camino de desplazamiento sin cambiar nada (can_insert) y comprueba que el desplazamiento acotado puede tener éxito sin perder una etiqueta vigente.
Una posición es un Option<Entry>. Una posición vacía no tiene etiqueta que leer, así que no hay un indicador occupied que un lector pueda olvidar comprobar, y match no compila hasta que se tratan ambos casos. El tipo de error es igual de exacto: el conjunto de desafíos gastados puede fallar de dos maneras (DoubleSpend y Full), y SpendError nombra exactamente esas dos.
GCRA: limitar la tasa con un entero
El Generic Cell Rate Algorithm (ATM Forum, 1996) es la forma de planificación virtual del cubo con fugas. Para cada cliente guarda un único tiempo teórico de llegada (TAT). Con el intervalo de emisión \(T = \max(1, \lceil W / N \rceil)\) para un límite positivo \(N\) por ventana \(W\), y la tolerancia de ráfaga \(\tau = (N - 1) T\):
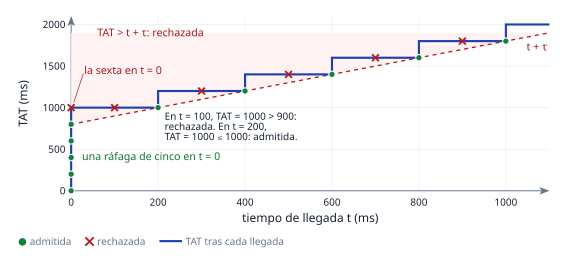
fn arrive(
    cells: &mut [Cell; SLOTS_PER_SHARD],
    key: u64,
    now_ms: u64,
    limits: Limits,
) -> Decision {
    let interval = limits.emission_interval();
    let tau = limits.burst_tolerance();
    let Some(cell) = locate(cells, key, now_ms, tau) else {
        return Decision {
            limited: true,
            capacity_exhausted: true,
            retry_after_ms: interval,
            remaining: 0,
        };
    };
    let tat = cell.tat_ms.max(now_ms);
    let horizon = now_ms.saturating_add(tau);
    if tat > horizon {
        return Decision {
            limited: true,
            capacity_exhausted: false,
            retry_after_ms: tat - tau - now_ms,
            remaining: 0,
        };
    }
    cell.tat_ms = tat.saturating_add(interval);
    // ... remaining = min(rate, floor((t + tau - TAT) / T) + 1)
}
El check de la partición toma el cerrojo y llama a arrive con las celdas protegidas por él; el guardián libera el cerrojo cuando check vuelve. Las celdas ocupan 16 bytes (una clave y un TAT) en 16 particiones de 512 posiciones con una ventana de sondeo de 16 posiciones, unos 128 KiB en total. Una celda cuyo TAT es anterior a \(t - \tau\) se ha vaciado y se recupera en el acto. La cabecera Retry-After se calcula con la misma aritmética. Las ventanas de sondeo saturadas rechazan clientes nuevos en lugar de expulsar estado de cuota activo, y la decisión lo indica (capacity_exhausted), para que quien llama no convierta un rechazo por saturación en un bloqueo. Una tasa configurada a cero rechaza las peticiones. Un único limitador sirve a varias reglas: la clave de la celda es un Wyhash de la dirección del cliente con la semilla del ámbito de la regla, de modo que el mismo cliente tiene presupuestos independientes en ámbitos distintos.
La tabla versionada de bloqueos
Los bloqueos usan 4.096 posiciones con campos atómicos de versión, clave y caducidad, con direccionamiento abierto mediante un hash con clave de la dirección bloqueada y una ventana de sondeo de 8 posiciones. Un escritor, serializado con los demás escritores mediante un mutex, rodea cada actualización con incrementos de versión; los lectores no toman ningún cerrojo, solo aceptan una versión par estable y reintentan si hay cambios concurrentes.
pub fn ban(&self, banned: &[u8], until: u64, now: u64) {
    let key = slot_key(banned);
    let _writers = self.lock_writers();
    let victim = &self.slots[self.victim(key, now)];
    // Una clave y una caducidad forman un solo valor lógico: la sustitución
    // ocurre bajo una versión impar, para que los lectores no puedan combinar
    // una clave antigua con la caducidad de la clave siguiente.
    victim.version.fetch_add(1, Ordering::SeqCst);
    victim.until.store(until, Ordering::SeqCst);
    victim.key.store(key, Ordering::SeqCst);
    victim.version.fetch_add(1, Ordering::SeqCst);
}

fn read_slot(&self, slot: &Slot) -> (u64, u64) {
    loop {
        let before = slot.version.load(Ordering::SeqCst);
        if before & 1 != 0 {
            std::hint::spin_loop();
            continue;
        }
        let key = slot.key.load(Ordering::SeqCst);
        let until = slot.until.load(Ordering::SeqCst);
        if before == slot.version.load(Ordering::SeqCst) {
            return (key, until);
        }
    }
}
La consistencia secuencial impide mezclar una identidad antigua con la caducidad de su sustituta: todo acceso pertenece a un único orden total, lo que mantiene sencillo el razonamiento. Los lectores no toman ningún mutex, pero pueden esperar a un escritor y no son wait-free. Estas operaciones atómicas tienen un coste real, medido indirectamente en el programa de medición HTTP en lugar de suponerlo nulo. Una ventana de sondeo llena sobrescribe una posición que haya caducado o, si no la hay, la que caduque antes. clear levanta todos los bloqueos pero deja las claves en su sitio, porque una posición vaciada podría ocultar una clave en colisión situada más adelante en una cadena de sondeo.
El anillo MPSC de incidentes
Cuando el modo de protección Shield deniega una petición o salta el honeypot, el incidente se copia en un registro fijo de unos 1,3 KB (dirección del cliente, User-Agent, método, ruta, categoría y carga útil, cada uno recortado a su capacidad) y se añade a un anillo acotado de múltiples productores y un solo consumidor (el diseño de Vyukov con números de secuencia, 512 celdas, BoundedQueue<IncidentRecord, 512>). Los productores son los hilos de conexión; el consumidor es el hilo de almacenamiento. Un anillo lleno descarta el registro más reciente en lugar de bloquear una respuesta: una política de pérdida explícita, no una garantía de durabilidad. El contador de descartes hace observable esa pérdida.
/// Copia `incident` en el anillo; si está lleno, lo descarta y lo cuenta.
pub(crate) fn record(&self, incident: &Incident<'_>) {
    if self.queue.push(IncidentRecord::from_incident(incident)).is_err() {
        self.metrics.incidents_dropped.bump();
    }
}
Tras mover un registro a un lote pendiente, el hilo de almacenamiento lo conserva, junto con las filas preparadas, hasta que se confirma la transacción; no lo descarta en silencio ante un error de la base de datos, y un reintento escribe exactamente el mismo lote.
Cada celda lleva un número de secuencia que indica a los productores si la celda está libre y al consumidor si está llena, así que ningún lado toma un cerrojo. Un anillo así no puede escribirse en Rust seguro: los productores y el consumidor tocan a la vez celdas distintas de un mismo array, y solo el protocolo de secuencia, no el sistema de tipos, demuestra qué hilo puede tocar qué celda. Por eso el módulo crates/store/src/ring.rs guarda sus valores en celdas UnsafeCell<MaybeUninit<T>>, y cada bloque unsafe nombra el paso del protocolo que lo justifica:
if diff == 0 {
    // Relaxed: el CAS solo decide qué productor obtiene la posición `pos`.
    match self.tail.0.compare_exchange_weak(
        pos, pos.wrapping_add(1), Ordering::Relaxed, Ordering::Relaxed,
    ) {
        Ok(_) => {
            // SAFETY: el CAS dio a este hilo la posición `pos`, y
            // `sequence == pos` indica que la celda está vacía; ningún otro
            // productor puede reclamar `pos` y el consumidor no la lee antes
            // del store Release de abajo.
            unsafe { (*slot.value.get()).write(value) };
            // Release: publica el valor escrito para el consumidor.
            slot.sequence.store(pos.wrapping_add(1), Ordering::Release);
            return Ok(());
        }
        Err(current) => pos = current,
    }
} else if diff < 0 {
    return Err(value);
}
Dos convenciones del anillo son tipos, no comentarios. Con el anillo lleno, push devuelve Err(value) y entrega de vuelta el registro para que quien llama decida si lo cuenta o lo descarta; un simple false lo perdería. El anillo tiene un único consumidor: pop toma &mut self, y el código compartido debe reclamar primero el Consumer único, de modo que un segundo consumidor no compila o se rechaza en tiempo de ejecución.
Publicación read-copy-update del motor
El motor de políticas se reconstruye fuera de la ruta crítica cuando cambian las políticas. Las peticiones nunca deben observar un motor a medio construir, y un motor nunca debe liberarse mientras una petición lo esté leyendo. Sibuna publica cada motor como un Arc<Engine> en un EngineSlot, y cada conexión lo lee a través de una EngineCache:
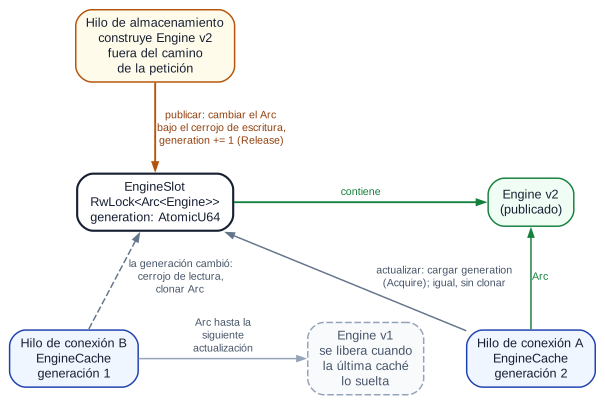
pub struct EngineSlot {
    current: RwLock<Arc<Engine>>,
    generation: AtomicU64,
}

pub fn publish(&self, engine: Engine) {
    let fresh = Arc::new(engine);
    let previous = {
        let mut current =
            self.current.write().unwrap_or_else(PoisonError::into_inner);
        std::mem::replace(&mut *current, fresh)
    };
    self.generation.fetch_add(1, Ordering::Release);
    // El motor antiguo se libera fuera del cerrojo (si era su último titular).
    drop(previous);
}

pub struct EngineCache {
    generation: u64,
    engine: Option<Arc<Engine>>,
}

pub fn refresh(&mut self, slot: &EngineSlot) -> &Engine {
    let generation = slot.generation();
    if self.generation != generation {
        // Una publicación entre la carga de arriba y esta clonación etiqueta un
        // motor más nuevo con una generación más antigua; la siguiente
        // actualización simplemente vuelve a cargar.
        self.generation = generation;
        self.engine = None;
    }
    self.engine.get_or_insert_with(|| slot.load())
}
La generación se almacena con orden release una vez que el motor está en su sitio, y se carga con orden acquire: un lector que ve una generación nueva también ve el motor almacenado antes que ella. La carrera mencionada en el comentario es benigna. Si una publicación ocurre entre la carga de la generación por un lector y su clonación, el lector guarda en caché el motor más nuevo con el número de generación anterior, y su siguiente actualización detecta la discrepancia y vuelve a cargar. Un lector puede ir un motor por detrás durante una petición; nunca puede ver un motor a medio construir, porque en el espacio solo se almacenan motores completos.
¿Por qué una caché y no simplemente un cerrojo? SID 0010 nos pidió medir el coste de lectura con 16 hilos y elegir entre RwLock<Arc<Engine>> y una alternativa sin cerrojos (lock-free) en Rust seguro. Leer a través del cerrojo toca la palabra del cerrojo y el contador de referencias, dos líneas de caché en las que escriben todos los núcleos. La generación, en cambio, se escribe una vez por publicación y por lo demás solo se lee, así que cada núcleo conserva su copia:
| Lector | 1 hilo | 16 hilos |
|---|---|---|
solo el guardián de lectura de RwLock |
4,2 ns | 752 ns |
lectura de RwLock y clonación de Arc |
7,6 ns | 833 ns |
comprobación de generación con un Arc en caché |
0,8 ns | 1,8 ns |
Con contención, la lectura en caché es más de 400 veces más barata que el cerrojo, así que el camino de la petición usa la caché, y el RwLock solo en el camino lento de una actualización. La medición es la prueba ignorada read_cost_under_contention de cmd/sibuna/src/slot.rs. Cada uso en el camino de la petición actualiza la caché, de modo que una petición ve el motor vigente en ese paso. El propio motor es pequeño: 209.052 bytes, unos 204 KiB, de tablas compactas en el heap (engine_bytes en benchmarks/results/primitives-latest.json), con capacidad para 128 reglas, nombres de regla de 128 bytes y 8.192 nodos del trie.