Parte III: Fundamentos de la investigación criptográfica
Deducimos los modelos de coste de los dos niveles de prueba de trabajo de Sibuna, presentamos la prueba de trabajo secuencial (Proof of Sequential Work) de Cohen y Pietrzak con su argumento de seguridad y justificamos la autenticación con hash con clave para desafíos y sesiones. El SID 0006 recoge los supuestos y las referencias.
Hashcash: las matemáticas del primer nivel
Definición y coste
El desafío del primer nivel de Sibuna para la cadena de desafío \(C\) y la dificultad de \(b\) bits es: encontrar \(N \in \mathbb{N}\) tal que \(\text{SHA-256}(C \parallel \text{":"} \parallel \mathrm{dec}(N))\) tenga \(b\) bits iniciales a cero. La representación decimal del nonce es deliberada: mantiene idéntico el formato de transmisión entre el solucionador WebAssembly, la alternativa en JavaScript y el verificador nativo, sin un paso de codificación binaria.
La unidad de dificultad es un intento de hash esperado, no una llamada a la función de compresión. Una entrada puede ocupar varios bloques de SHA-256. El precálculo del prefijo también puede cambiar el trabajo por nonce. La regla de transmisión sigue siendo el predicado sobre el resumen; las implementaciones deben coincidir en el enunciado y en la codificación del nonce, no en un coste de CPU estimado.
Para resúmenes ideales independientes, el número de intentos \(X\) es geométrico con \(p = 2^{-b}\). Su mediana es \(\left\lceil \ln(1/2) / \ln(1-p) \right\rceil\), aproximadamente \(2^b \ln 2\) para \(p\) pequeño, y su varianza es \((1-p)/p^2\). El verificador comprueba un resumen candidato en lugar de realizar la búsqueda. El análisis sintáctico, la autenticación del desafío, las comprobaciones de huella, la inserción en el conjunto de desafíos gastados y la respuesta son trabajo adicional. El tiempo medido de una primitiva no permite deducir la capacidad de un servidor frente a inundaciones.
Dos límites de la búsqueda
El primero es la varianza: una búsqueda larga no indica necesariamente un worker averiado. El segundo es el paralelismo: los intentos de nonce independientes pueden ejecutarse en paralelo. Más núcleos reducen el tiempo transcurrido de la búsqueda aunque el número total de intentos esperado siga siendo el mismo. Por tanto, el rendimiento del hardware importa para la política de admisión. Ni una tasa de hash declarada ni una única prueba de rendimiento pueden acotar la ventaja de cada solicitante.
Prueba de trabajo secuencial: el segundo nivel
Por qué trabajo secuencial
Una construcción de trabajo secuencial introduce dependencias entre cálculos: una etiqueta posterior necesita un valor producido antes. Esto aborda una magnitud distinta del trabajo total, es decir, la profundidad del cálculo. Los desafíos independientes pueden seguir ejecutándose en paralelo, y la latencia del hash en el hardware sigue importando.
Sibuna sigue la construcción basada en hashes descrita por Cohen y Pietrzak. Su grafo tiene \(2^{n+1}-1\) etiquetas a profundidad \(n\), pero un número fijo de etiquetas no es una latencia determinista en el navegador: las etiquetas pueden ocupar varios bloques de compresión, las aperturas pueden recalcular subárboles y la planificación añade variación. Las afirmaciones de seguridad de los análisis en el modelo de oráculo no deben convertirse en una afirmación sin matices sobre cualquier implementación concreta o adversario.
La construcción
Sea \(n\) la profundidad y consideremos el árbol binario completo cuyos nodos se nombran con cadenas binarias de longitud como máximo \(n\) (raíz \(\varepsilon\), hijos \(v0\) y \(v1\), hojas de longitud \(n\)). Cada nodo \(v\) lleva una etiqueta de 32 bytes \(\ell_v = H(\chi, v, \mathrm{parents}(v))\), donde \(\chi\) es el enunciado del desafío y \(H\) es SHA-256 con \(\chi\) absorbido una sola vez (el mismo truco del prefijo que en el solucionador de Hashcash):
- un nodo interno calcula el hash de sus dos hijos: \(\ell_v = H(\chi, v, \ell_{v0}, \ell_{v1})\);
- una hoja \(u = u_1 \dots u_n\) calcula el hash de los hermanos izquierdos de sus antepasados allí donde el camino desde la raíz giró a la derecha: \(\ell_u = H(\chi, u, \{\ell_{u_1 \dots u_{i-1} 0} : u_i = 1\})\).
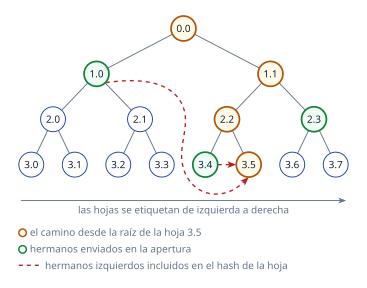
Las aristas de los hermanos izquierdos son lo que hace secuencial el cálculo: la hoja \(u\) no puede etiquetarse hasta que esté completo cada subárbol a su izquierda, así que se impone un recorrido en postorden en profundidad, y la etiqueta raíz \(\varphi = \ell_\varepsilon\) depende de las \(2^{n+1} - 1\) etiquetas en secuencia.
Aperturas. Tras calcular \(\varphi\), el probador deriva \(t\) hojas mediante Fiat-Shamir, \(\gamma_i = H(\chi \parallel \varphi \parallel i) \bmod 2^n\), y para cada una envía la etiqueta de la hoja y las \(n\) etiquetas hermanas a lo largo de su camino hasta la raíz. El verificador recalcula la hoja a partir de las hermanas que son sus padres, calcula los hashes hacia arriba a lo largo del camino y comprueba que llega a \(\varphi\). El coste del verificador es de \(O(tn)\) cálculos de etiquetas con un espacio de trabajo acotado. Un cálculo de etiqueta puede abarcar varios bloques de hash; contar etiquetas no es contar llamadas de compresión.
fn verify_opening(base: &Sha256, n: u8, phi: &Label, gamma: u32, opening: &[Label]) -> bool {
let Some((leaf, siblings)) = opening.split_first() else {
return false;
};
// `siblings` va de la profundidad n a la 1; invertido, se empareja con 1..=n.
let mut hasher = node_hasher(base, n, gamma);
for (d, sibling) in (1..=n).zip(siblings.iter().rev()) {
if turns_right(gamma, n, d) {
hasher.update(sibling);
}
}
if hasher.finalize() != *leaf {
return false;
}
let mut current = *leaf;
for (d, sibling) in (1..=n).rev().zip(siblings) {
let mut parent = node_hasher(base, d - 1, gamma >> (n - d + 1));
if turns_right(gamma, n, d) {
parent.update(sibling);
parent.update(¤t);
} else {
parent.update(¤t);
parent.update(sibling);
}
current = parent.finalize();
}
current == *phi
}
Muestreo, solidez y sus límites
Consideremos un compromiso fijo con una fracción defectuosa \(\alpha\) detectable de forma independiente. Si cada apertura muestrea de manera uniforme e independiente, la probabilidad de no encontrar ninguna posición defectuosa en \(t\) aperturas es \((1-\alpha)^t\). Este cálculo elemental explica por qué ayudan más aperturas. No es, por sí solo, una demostración de seguridad para un protocolo de trabajo secuencial.
La construcción de trabajo secuencial a la que nos referimos tiene un análisis de seguridad en un modelo de oráculo. La separación de dominios, la correspondencia de parámetros, el truncamiento y la implementación de Sibuna deben seguir comprobándose frente a los supuestos de la construcción. El muestreo de Fiat-Shamir hace que las aperturas sean reproducibles a partir de un compromiso; la reproducibilidad por sí sola no demuestra la resistencia a la búsqueda por fuerza bruta. No afirmamos de forma incondicional que hacer trampa nunca sea más barato.
Memoria del probador
Un probador ingenuo guarda todas las etiquetas (\(2^{n+1} - 1\) en total). El probador de Sibuna mantiene una pila con las etiquetas de los hermanos izquierdos del camino actual (\(n + 1\) etiquetas) durante la primera pasada y conserva solo los \(m = \min(n, 10)\) niveles superiores (\(2^{m+1} - 1\) etiquetas, como máximo 64 KB). Para abrir una hoja recalcula el subárbol del antepasado de la hoja a profundidad \(m\), \(2^{n-m+1} - 1\) hashes, inicializando la pila a partir de los niveles conservados. El coste total del probador es de \(2^{n+1} - 1 + t\,(2^{n-m+1} - 1)\) hashes y todo el espacio de trabajo, incluida la prueba de salida, ocupa menos de 100 KB: una pestaña del navegador y una prueba nativa comparten el mismo tipo Workspace (sibuna_pow::posw::Workspace).
Los parámetros no son tiempos
Sibuna hace corresponder los bits de trabajo con la profundidad mediante \(n = b - 3\), limitada al intervalo admitido \([4, 24]\). Es una convención de escala de trabajo, no una garantía de igual tiempo real entre algoritmos. Una hoja puede calcular el hash de varias etiquetas padre, mientras que Hashcash prueba un nonce repetidamente. El compilador, el navegador, el procesador y la elección de parámetros afectan a sus costes relativos. La prueba de rendimiento de primitivas confirmada en el repositorio mide la verificación; no establece la latencia de resolución en el navegador.
El tamaño de la prueba es de \(32(1 + t(n+1))\) bytes. A profundidad 13 con dieciséis aperturas, esto da \(32(1 + 16 \times 14) = 7200\) bytes. Aumentar el número de aperturas incrementa tanto la prueba como el trabajo del verificador, aunque el coste dominante de construir el árbol siga siendo el mismo.
Elegir una construcción
La comparación relevante es un presupuesto de recursos, no la reputación de un algoritmo. Registra la memoria del probador, el trabajo del verificador en el peor caso, los bytes de la prueba y los supuestos necesarios para la propiedad afirmada. La búsqueda con uso intensivo de memoria (memory-hard) puede ser útil, pero un verificador que debe repetir un trabajo costoso da al atacante otro lugar donde gastar los recursos del servidor. Las construcciones de retardo verificables públicamente sirven a un modelo de confianza distinto del de un control de admisión con secreto compartido.
Sibuna conserva la verificación barata por hash y una opción de trabajo secuencial basada en hashes. Esta última requiere más bytes de prueba y un análisis de parámetros más cuidadoso. Ninguna de las dos elecciones elimina la necesidad de rechazar las pruebas mal formadas antes de entrar en una verificación costosa.
Autenticación simétrica: desafíos y sesiones
El emisor es el verificador
Una firma digital permite verificar a cualquiera que tenga la clave pública, lo cual es la herramienta adecuada cuando los verificadores no deben poder emitir. El verificador de Sibuna es el emisor (o un clúster que comparte una semilla). Un código de autenticación de mensajes construido a partir de una función pseudoaleatoria proporciona autenticación dentro de ese dominio de confianza. No proporciona verificación pública: cualquiera que tenga la clave MAC también puede emitir tokens. El capítulo de pruebas de rendimiento compara las operaciones de token implementadas.
Una segunda consecuencia importa a largo plazo: Ed25519 se basa en logaritmos discretos en un grupo de curva elíptica, que el algoritmo de Shor rompe; un hash con clave se basa solo en la función hash, frente a la que los algoritmos cuánticos dan como mucho una aceleración cuadrática. Sibuna mantiene Ed25519 como opción (--token-scheme ed25519) para los despliegues que necesitan verificadores que no puedan emitir tokens.
La derivación de claves
Una semilla maestra de 32 bytes (de --secret-file, de SIBUNA_SECRET o un valor aleatorio nuevo) da lugar, mediante BLAKE3 con clave y una cadena de dominio, a cada clave de uso específico: las claves de token, de desafío, de Ed25519 y de huella, y la clave de requisito que sella los tickets de requisito (parte IV).
pub fn derive(seed: &Seed) -> Keys {
    Keys {
        token: subkey(seed, "sibuna/token/v1"),
        challenge: subkey(seed, "sibuna/challenge/v1"),
        ed25519_seed: subkey(seed, "sibuna/ed25519/v1"),
        fingerprint: subkey(seed, "sibuna/fingerprint/v1"),
        requirement: subkey(seed, "sibuna/requirement/v1"),
    }
}

fn subkey(seed: &Seed, purpose: &str) -> [u8; 32] {
    blake3::keyed_hash(seed.as_bytes(), purpose.as_bytes())
}
En un clúster, Keys::bind_node sustituye la clave de desafío por BLAKE3 con esa clave sobre sibuna/challenge-node/v1 y el identificador del nodo, de modo que un desafío debe volver al nodo que lo emitió, mientras que los tokens de sesión y los tickets de requisito siguen siendo válidos en todos los miembros.
La separación de dominios evita la reutilización accidental entre usos; comprometer la semilla maestra compromete todas las claves derivadas. Un clúster solo tiene que ponerse de acuerdo en una semilla.
Desafíos sin estado
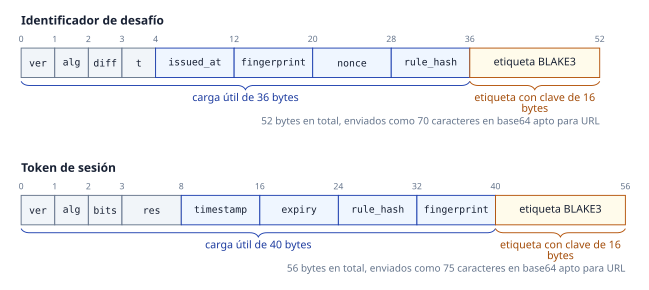
Un identificador de desafío es un registro autoautenticado: versión, algoritmo, dificultad, número de aperturas, hora de emisión, la huella con clave del cliente, un nonce derivado de la PRF y el hash de la regla de política que exigió el desafío, seguidos de una etiqueta de 16 bytes bajo la clave de desafío. Emitir uno no escribe nada. La verificación decodifica el registro, comprueba la etiqueta en tiempo constante, comprueba la antigüedad frente al TTL del desafío, comprueba la huella frente al cliente que lo envía y solo entonces examina la prueba.
El conjunto de desafíos gastados está formado por 16 particiones de direccionamiento abierto Robin Hood sobre las etiquetas de 16 bytes (parte V). La huella es un hash con clave de la dirección del cliente y del User-Agent, con separación de longitudes para que dos entradas no colisionen por concatenación, y con clave para que no puedan calcularse sin conexión las huellas de otros clientes.