03. 心智与硅基:模型、芯片与万卡集群
老面酵种、面包店窗口与铸铁烤炉
在对着手机屏幕敲下一行提问的普通用户眼中,人工智能宛如一场浑然天成的魔术:一个会思考、会答话的对话框。但在系统工程师,以及如今北京与华盛顿的出口管制立法者,眼中,一套人工智能系统却清晰地分为 三层截然不同的数字与物理结构 :
- 面包店的售卖窗口(远程 API 与终端应用): 隔着橱窗递给顾客一片温热的面包,并不会把烤炉的布线图纸或明早自己烤出一万只面包的秘方交到对方手中。
- 老面酵种与母本秘方(权重、检查点与训练代码): 由数十亿乃至数万亿个经训练习得的数值参数(
模型权重)、训练中途保存的快照(关键检查点)、模型架构设计,以及底层源码与性能调优代码(训练优化、推理加速)共同构成。复制了这些文件,就等于完整复刻了那颗训练成型的大脑本身。 - 铸铁烤炉与发电厂(AI 芯片、堆叠存储与超算集群): 由物理硅基处理器、高带宽存储器、芯片架构蓝图与高速光互联集群网络组成,离开了这层底座,无论是前沿模型的预训练,还是医院与高校的本地私有化部署,都将成为无源之水。
商务部问答区分远程API、应用、网页、SaaS及轻量本地服务与草案中的受限大模型技术转移。这只说明该范围,不是所有技术或数据规则的豁免。附件1分别列出模型技术(266504X)、处理器及存储设计(266506X)、超过10,000张加速卡集群的特定技术(266507X)。 CNQA CN-A1
前沿大模型核心技术的三条触发红线( 266504X )
并非高校实验室或创业车库里训练出的每一个神经网络都会落入拟限制出口的 266504X 第 2 点 。只有当某款大模型的核心技术(涵盖模型权重、关键检查点、底层源代码、模型架构、训练优化与推理加速技术)触及以下三条量化指标中的 任意一条 时,才会被纳入管制范围 CN-A1, 266504X(2), note 3 :
- 训练算力规模: 模型累计训练计算量达到或超过 \(10^{26}\) 次浮点运算(FLOPs) ,这一超大规模算力门槛与美国
4E091闭源模型权重管制条款所采用的算力标准完全一致 US25 。 - 参数规模: 模型总参数量达到或超过 2 万亿(20,000 亿) 。
- 出口行为发生时位居全球前十: 即便是一款精悍紧凑的中小参数模型,如果在 出口行为发生时 ,境内外主流权威评测机构或大型行业平台的公开评测结果将其列为 全球前十名 ,无论是综合能力、特定业务场景能力、全球调用规模、安全对齐表现还是训练效率指标,同样会触发管制 CN-A1, 266504X, note 3 。
第三条指标具有鲜明的动态生命力。由于开源研究者不断发明精巧的蒸馏与强化学习方法,将顶尖推理能力浓缩进 300 亿或 700 亿参数的轻量模型之中,一款惊艳问世、首周空降全球第六的“小钢炮”模型在发布当周会 跨入 限制类门槛;而八个月后,当新一代模型纷纷超越其排名时,它又会自然 退回 门槛之外。因此,合规判定永远绑定于“特定模型版本在特定出口时点”的客观状态,而绝不会给“DeepSeek”或“Qwen”之类品牌贴上终身固定的标签 CN-A1 。
数据安全红线( 266501J 与 266504X(1) )及自主智能体( 266505X 与 266502J )
哪怕模型体量再小,一旦喂入了关乎国家主权机密的训练语料,也会撞上不可逾越的红墙。附件 1 直接引入《中华人民共和国数据安全法》的分级概念:利用国家依法认定的 核心数据 训练并对外提供服务的大模型被列入 拟禁止出口 ( 266501J ,连远程提供服务亦在禁止之列);而利用法定 重要数据 训练的大模型则归入 拟限制出口 ( 266504X(1) ),但附有两条极其实用的豁免说明,若相关重要数据源自 合法公开渠道 ,或经脱敏清洗后占比 不超过 0.1% 的微量比例 (既未实质提升特定领域核心研发能力,亦无法在模型输出中被还原泄露),则不纳入该项管制 CN-A1 。
围绕基座大模型外围, 266505X 下设四个限制点,精准覆盖高阶 人工智能智能体(Agent) 技术:长程任务规划引擎(拆解 \(\ge 20\) 个子步骤,且拆解准确率 \(\ge 80\%\) 、子任务平均完成率 \(\ge 90\%\) )、多智能体协同编排系统(支持 \(\ge 60\) 个并发智能体)、大规模工具调用引擎(集成 \(\ge 200\) 种外部软件工具,且多工具串联任务端到端成功率 \(\ge 90\%\) ),以及响应延迟低于 200 毫秒且超越 \(90\%\) 人类选手的实时博弈决策系统。唯有当此类高性能智能体 专门或主要 面向国防军事、关键信息基础设施或党政核心机关场景打造时,才会跨入禁止出口红线( 266502J ) CN-A1 。
中国 AI 清单深处的硬件底座:算力芯片、先进存储与万卡集群
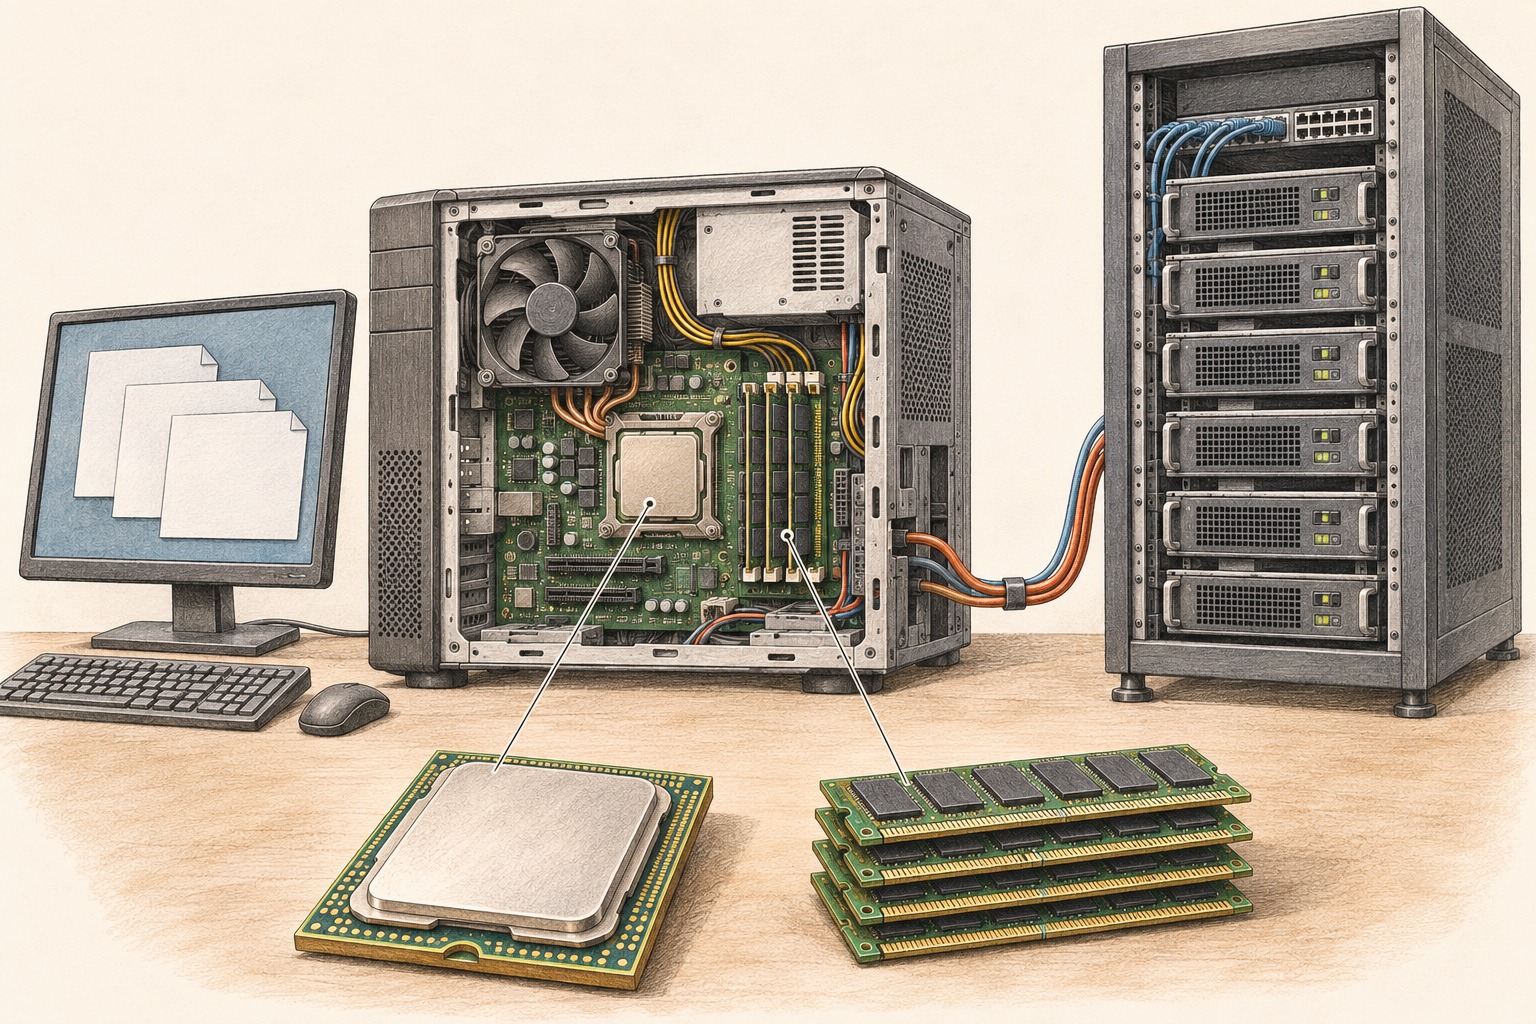
AI部分还包括处理器设计、存储设计及大型集群工程:
- AI 处理器设计蓝图(266506X 第 1 点): 草案拟限制出口满足所列 任一 技术特征的 AI 处理器架构、定制指令集、核心计算 IP 核、基础软件栈及专用设计工具,不仅涵盖需采用 \(\le 14\text{ nm}\) 制程工艺的设计、2.5D/3D 芯粒(Chiplet)先进封装或非冯·诺依曼/存算一体等新型架构,甚至囊括了具备浮点/整型张量运算能力或面向智能语音、计算机视觉、自动驾驶等广泛应用场景的功能特征 CN-A1, 266506X 。不妨想一想这会触及多广的面:开源硬件社区(如基于 RISC-V 的开源 AI 加速器项目)、定制 NPU 初创公司,以及跨国协同研发的芯片设计团队!正因无晶圆厂(Fabless)芯片设计企业必须将完成版图交付境外半导体代工厂才能造出实体晶圆, 注释 2 才专门开辟了一道至关重要的减压阀:对 赴境外开展芯片流片制造 (
赴境外开展芯片流片制造)给予自动许可等便利化安排 CN-A1, note 2 CNQA 。 - 存储设计(266506X第2项): 分为3D闪存和内存两个子项。闪存看密度、速度或键合,内存看18纳米及以下、垂直沟道、键合或多层堆叠。这些是替代条件,不是所有存储统一适用18纳米门槛。 CN-A1, 266506X(2)
- 超万卡集群的系统工程底座(266507X 第 1 至 4 点): 在 超过 10,000 张算力加速卡 上训练前沿开源大模型,不亚于一场精密工业魔法,稍有不慎,单卡故障就会令整座集群每隔一小时停摆一次。四个限制点严密把守着双向带宽 \(\ge 800\text{ GB/s}\) 的芯片/节点高速互联、恢复时间 \(\le 120\text{-second}\) 的自动容错自愈、端到端延迟 \(\le 1\text{-microsecond}\) 的动态集合通信调度,以及 将两家及以上不同硬件厂商算力芯片统一池化混训的异构集群软件栈 CN-A1, 266507X 。当华盛顿严控英伟达高端 GPU(
3A090),而北京拟限制多厂商异构集群混训缝合技术(266507X)时,全球开源分布式训练框架正不偏不倚地站在两大管制体系交汇的断层线上!
这对两支团队意味着什么
A的内存改进与B的测试是可以交换的知识,计算机则是另一项依赖。开放模型许可无法补上缺失芯片,硬件限制也不能独自说明所有模型文件的法律状态。我们同时追踪工作台的这两个部分。
两队的起点见 堡垒陷阱:双方如何一起受损。