第 VIII 部分:实证评估
我们给出由已提交的测量工具记录的 Sibuna 测量结果:原语延迟;在外部负载生成器下运行的完整产品,并统计 CPU 和内存;开环生成器在相同施加负载下测得的延迟;以及与 Anubis(一种广泛部署的工作量证明网关)的比较。一次运行八个实时仪表板的控制台测试补全了这份记录。本部分的每个数字都来自一个已提交的结果文件(每张表都注明了该文件及其生成时间),或者来自一份设计记录。功能性通过与性能测量回答的是不同的问题,在一台主机上测得的结果也不能作为另一台主机上的排名。
方法
这些测量工具是同一个 Rust 工具 tools/bench(可执行文件 sibuna-bench)的若干命令,通过 cargo xtask bench 运行。另一个工具记录控制台的运行。
| 测量工具 | 测量内容 | 结果文件 |
|---|---|---|
cargo xtask bench primitives |
十六个原语工作负载,外加针对哈希速率限制器路径的两行,在一个 CPU 上运行:七个批次,给出每次操作的中位数及最小-最大离散范围 | primitives-latest.json, primitives-latest.md |
cargo xtask bench product |
在 wrk 下运行的完整守护进程:Gate 和 Shield 在 forward-auth 和反向代理模式下的吞吐量、延迟百分位、每请求 CPU 时间和峰值常驻内存 |
product-latest.json, product-latest.md |
cargo xtask bench latency |
开环生成器在固定施加速率下测得的已准入请求的延迟百分位 | latency-latest.json, latency-latest.md |
cargo xtask bench product --anubis |
把 Anubis 作为另一个产品加入的完整产品工作负载,以 caddy respond 为源站 |
comparison-latest.json, comparison-latest.md |
cargo xtask bench admission --anubis |
在 forward-auth 模式下,由两个 keep-alive 客户端测得的 Sibuna 和 Anubis 每秒准入操作数 | admission-latest.json, admission-latest.md |
sibuna-browser dashboards (tools/browser) |
一次功能性的控制台运行:生成器发送流量时,在无头 Chromium 中运行八个实时仪表板 | console-8-dashboards-2026-10-15.md |
.md 文件是摘要。.json 文件保存每次重复、机器、修订版本,以及每个被测可执行文件的路径、大小和 SHA-256。Git 保存了历史,因此该目录只保留最新的文件。有些文件是由较早版本的测量工具记录的,其中还包含同一次运行中测得的另一个守护进程构建的数据行;本部分报告 Sibuna 的数据行。
原语
每个工作负载在一次不计时的预热(最多 1,000 次操作)之后,运行七个计时批次。可变状态(已用集合、速率限制器)在每个批次之前、在计时之外重建。计时器包围整个批次,从不包围单次操作:每次操作读取一次时钟的成本,会与它要测量的不到 100 ns 的工作一样大。因此不报告每次操作的百分位,离散范围是跨批次的。我们报告每次操作的批次中位数,旁边列出最快和最慢的批次。
测试套件在一个绑定到单个 CPU 的子进程(sibuna-bench primitives-run)中运行。在共享主机上,繁忙的 SMT 兄弟线程或较低的时钟频率会拖慢整轮测试,因此工具把套件运行三次(--rounds),并为每一行保留中位数最低的那一轮。每一轮内部的统计方法同上。
完整产品
对于每种模式(forward auth、反向代理)和每种形态(Gate、Shield),测量工具以 --algorithm hashcash --difficulty 8 --rate-limit 100000000 --idle-timeout 5 和四个 worker(其 CPU 集合中每个 CPU 一个)在内存模式下启动守护进程。它像浏览器那样,用 sibuna-pow 求解守护进程的 Hashcash 挑战来获得会话。然后,它用 wrk 通过 keep-alive 连接驱动四种工作负载:2 个线程,64 个连接,5 秒,重复 3 次。
admitted:带有效会话 Cookie 的GET /private。在反向代理模式下,请求到达源站,其应答被中继回来;在 forward-auth 模式下,由守护进程自己回答200。challenged:同样的请求,但没有 Cookie,并使用浏览器 User-Agent。守护进程提供挑战:反向代理模式下是带 HTML 的200,forward-auth 模式下是401。allowed_static:来自curl/8.0的GET /robots.txt,两种形态都会在不挑战的情况下准入它。attack:一个有效会话加上q=' OR 1=1--。只有 Shield 拒绝它(403)。Gate 准入它,并在反向代理模式下把它中继到源站。
源站是一个桩程序(sibuna-bench origin):只使用标准库,每个连接一个线程,keep-alive,返回一个 41 字节的页面。每请求 CPU 时间是守护进程在整个运行期间来自 /proc/<pid>/stat 的用户态加内核态时间(以 10 ms 为一个时钟滴答),除以 wrk 统计的请求数;不包括源站的 CPU。峰值内存是 /proc/<pid>/status 中的 VmHWM,每次运行之前通过 /proc/<pid>/clear_refs 重置,使每次运行报告各自的峰值。每个数字都是各次重复的中位数,最小值和最大值保存在 JSON 文件中与之并列。
wrk 是一个闭环生成器:它始终保持 64 个请求在途。因此,越快的守护进程收到的请求越多,而 wrk 的百分位遗漏了它在等待慢应答期间没有发送的请求(协同遗漏)。它的 p99 反映的是守护进程在自身饱和时的表现,而不是在给定负载下的延迟。延迟测量工具回答的是后一个问题。
相同负载下的延迟
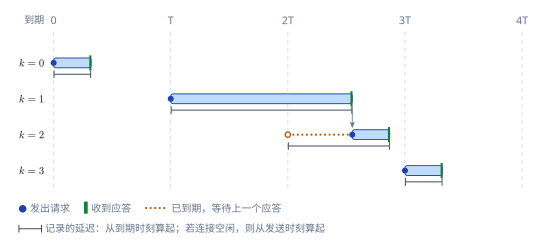
开环生成器(sibuna-bench generate)为每个连接运行一个阻塞线程。64 个连接中的每一个都按固定的时间表发送带会话的 GET /private:一个连接的第 \(k\) 个请求在 \(t_0 + o + kT\) 时刻到期,其中 \(o\) 是该连接的偏移量,\(T\) 是它的间隔,与之前的应答无关。当应答在下一个请求到期之后才到达时,下一个请求立即发出,其延迟从它的到期时刻开始计算,与 wrk2 的做法相同。当连接在到期时刻处于空闲状态时,延迟从实际发送时刻开始计算,因此生成器自身睡眠过头的时间不会算到守护进程头上。
测量工具运行 Shield 形态和已准入工作负载,施加五种速率:每秒 10,000、25,000、50,000、100,000 和 150,000 个请求,每种速率预热 2 秒,测量 10 秒,运行 3 次。测量工具可以在一次运行中测量两个守护进程构建:此时它把两者启动在同一个 CPU 集合上,并在每种速率和每次重复之间交替运行,空闲的那个不占用 CPU,从而让机器的缓慢漂移对两者产生相同的影响。记录的这次运行就是这样做的。百分位按最近秩法在一次运行的所有被测请求上计算;每个数字是三次运行的中位数,旁边列出 p99 的最小-最大范围。
CPU 集合
CPU 集合比任何其他设置都更重要。守护进程运行在 CPU 0 到 3 上(--cpus;--workers 等于该集合的大小)。wrk、延迟生成器和源站运行在 CPU 8 到 15 上(--load-cpus)。原语测试套件运行在 CPU 4 上(--cpu)。每个进程在启动之前用 taskset -c 绑定,因此它创建的每个线程都继承该集合。准入测量工具为产品使用 0 和 1 两个 CPU,为其客户端使用 CPU 8 到 15。
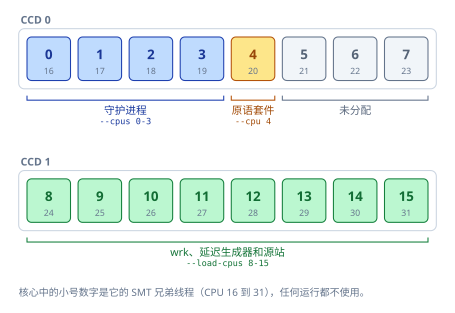
在其他机器上,我们选择不共享核心的集合(lscpu -e 显示拓扑)。
机器与条件
这些文件记录于 paxos-zig:一台 AMD Ryzen 9 5950X 16 核处理器(32 个逻辑 CPU),Linux 7.0.0-28-generic x86_64,powersave 调频策略并启用 boost,rustc 1.99.0。原语、产品和延迟文件记录于 2026 年 10 月 15 日,与 Anubis 的比较记录于 2026 年 10 月 16 日。守护进程是 cargo build --release -p sibuna,即编译了 SQLite 存储和控制台的默认构建(SID 0010);产品和延迟文件注明的可执行文件大小为 49,113,856 字节。每个文件都记录了其修订版本(原语为 efce14d,产品和延迟运行为 249d913),并带有 dirty: true;后者的工作树中已经包含 SID 0002 所记录的连接线程复用,SID 0002 引用 latency-latest.md 说明其效果。比较和准入文件注明修订版本 54e4ec5 并带有 dirty: true,因为工作树中包含 tools/bench 里新增的测量工具代码;它们的守护进程是该修订版本的 release 构建(37,450,232 字节)。比较运行之前的一分钟平均负载为 3.53,准入运行结束时为 0.56。
文件记录的一分钟平均负载为:原语运行时 2.46,延迟运行之前 1.30、之后 52.31,产品运行之前 52.31、之后 33.39。较高的数字来自延迟生成器的 64 个线程,产品运行紧接其后。
如何复现
我们需要 Linux、taskset(util-linux),以及 PATH 中的 wrk。
cargo xtask bench primitives
cargo xtask bench product
cargo xtask bench latency
cargo xtask bench help
cargo xtask bench 先用 cargo build --release -p sibuna 构建守护进程,然后以 release 模式运行 sibuna-bench。工具在它自己的可执行文件旁边寻找守护进程;--rust <path> 可以覆盖这一位置。cargo xtask bench help 列出所有选项,其中包括 --cpus、--load-cpus、--cpu、--rounds、--repetitions、--seconds、--rates 和 --warmup。下面关于 Anubis 的一节给出了记录那次比较所用的命令。
原语延迟
下表给出原语运行的每一行。JSON 文件按子系统和工作负载命名每一行(例如 pow_verify 和 hashcash_16_bits)。
| 工作负载 | ns/op | 最小-最大 |
|---|---|---|
| Hashcash 验证(16 比特) | 70.2 | 69.9-71.0 |
| PoSW 验证(深度 13,t = 16) | 22272.4 | 22257.0-22316.4 |
| 机器人签名(40 个,Aho-Corasick) | 55.7 | 55.3-57.2 |
| 机器人签名(40 个,顺序搜索) | 763.0 | 762.2-763.5 |
| IPv4 CIDR 查找 | 32.0 | 31.8-32.2 |
| IPv6 CIDR 查找 | 79.3 | 78.5-79.6 |
| 会话令牌(带密钥 BLAKE3) | 155.8 | 155.3-156.4 |
| 会话令牌(Ed25519) | 40587.5 | 40544.6-40631.1 |
| 已用集合(Robin Hood),写入并查找 | 21.0 | 20.8-21.3 |
| 速率限制器(GCRA),客户端字节 | 12.8 | 12.7-12.8 |
| 速率限制器,四个规则作用域,客户端字节 | 13.1 | 13.0-13.2 |
| 速率限制器(GCRA),已哈希的客户端 | 6.2 | 6.1-6.3 |
| 速率限制器,四个规则作用域,已哈希的客户端 | 6.3 | 6.2-6.4 |
| HTTP 解析与 Cookie | 132.5 | 132.3-133.2 |
| 分类,Shield 配置 | 790.8 | 787.2-793.1 |
| 分类,Gate 配置 | 75.9 | 75.6-76.1 |
| WAF 请求体扫描(8 KiB) | 12784.3 | 12771.5-12809.2 |
| WAF 请求体扫描(8 KiB),SQL 注入为审计模式 | 15485.4 | 15460.9-15530.1 |
离散范围很窄:任何一行中的任何批次与该行中位数的偏差都不超过 2.8%。图中以对数刻度展示同样的各行,使 6 ns 和 40 us 的行能够并排阅读。
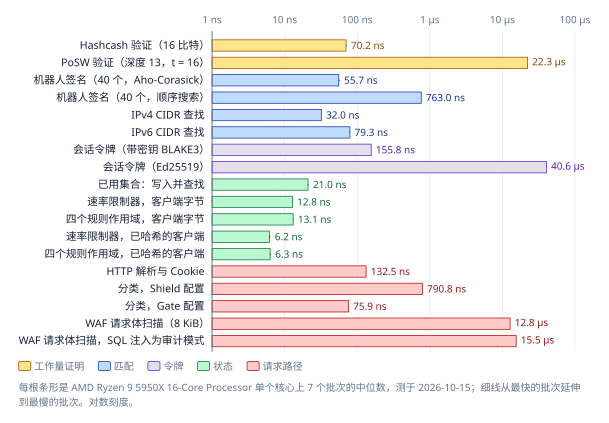
benchmarks/results/primitives-latest.json。¶工作量证明验证
Hashcash 验证对一个挑战、一个分隔符和一个十进制 nonce 做哈希:70.2 ns。顺序工作量验证器检查图的揭示:22,272.4 ns。由于输入长度不同,它的哈希调用次数和 SHA-256 压缩次数与 Hashcash 不同。两行都受 SHA-256 的限制,sibuna-crypto 在 CPU 支持时使用 SHA-NI 指令,在运行时检测(SID 0010)。
匹配
稠密 Aho-Corasick 自动机和顺序子串搜索使用相同的模式和“任一匹配”语义。在同样的 40 个签名上,自动机比顺序搜索快 13.7 倍(55.7 ns 对 763.0 ns)。它的表使用字节类,而不是每个状态 256 列(SID 0006,F 部分),这使机器人签名表保持在 42,244 字节(见下面的占用表)。CIDR 分类器耗时 32.0 ns(IPv4)和 79.3 ns(IPv6)。
令牌
BLAKE3 MAC 令牌的验证耗时 155.8 ns。sibuna-crypto 以可移植的方式实现 BLAKE3,没有 SIMD 路径;SIMD 路径在大输入上占优,但 Sibuna 用 BLAKE3 处理的输入都不到 100 字节,在这种输入上可移植代码已经很快。Ed25519 紧凑令牌的验证耗时 40,587.5 ns:验证器使用宽度为 5 和 8 的 NAF 数字,并保留解码后的公钥。一次 Ed25519 验证的成本约等于 260 次 MAC 验证;MAC 是 Sibuna 的默认令牌方案。
状态
已用集合这一行插入一个新标签并再次查找它:21.0 ns。这一行中的表有 16 个分片,每个分片 4,096 个槽(65,536 个标签;守护进程的默认值是 1,048,576),并在每个批次之前、在计时之外原地清空。因此每个批次探测的都是常驻内存。测试套件的早期版本为每个批次构建一张守护进程默认大小、全新清零的表;它测到的是内核在首次写入时映射表页面的成本,而运行中的守护进程只付出一次这种成本,所以这不是我们报告的那一行。
速率限制器的几行需要仔细解读。客户端字节的两行(gcra_check 和 gcra_four_rule_scopes)调用字节 API:每次检查以字节形式接收客户端地址,先用一个取自操作系统随机源的密钥计算它的带密钥 SipHash-1-3。密钥使任何人都无法计算出与受害者共享探测窗口的地址(见 SID 0010 和 sibuna-store 的文档)。这两行耗时 12.8 ns 和 13.1 ns。
守护进程在请求路径上不使用字节 API。它每个请求只对客户端做一次哈希(ClientHasher),并把哈希值传给它查询的每张表。已哈希客户端的两行(gcra_check_hashed 和 gcra_four_rule_scopes_hashed)测量的就是这条路径,哈希值在循环之前计算:每次检查 6.2 ns 和 6.3 ns。字节行与已哈希行中位数之间 6.6 ns 的差距,大约就是在这些输入上计算带密钥哈希的代价,守护进程每个请求只付一次,而不是每张表付一次。
HTTP 解析器
解析器这一行解析一个 400 字节的浏览器请求并查找一个 Cookie:132.5 ns。该 crate 自己的计时测试结果与之一致(crates/http:在同一台机器上约 135 到 180 ns)。解析器是零拷贝的;每个字段都是连接缓冲区的一个切片。
策略引擎
对一个浏览器请求进行完整分类耗时 790.8 ns,Gate 配置耗时 75.9 ns。这几行没有填入请求中已解析的客户端地址,因此引擎在评估过程中解析客户端地址文本。守护进程在评估之前、每个请求只解析一次地址,因此这几行包含了一小部分守护进程在引擎之外付出的成本。引擎的堆表总计 209,052 字节(SID 0002)。
WAF 检查
对 8 KiB 请求体的语义扫描耗时 12,784.3 ns,即每字节 \(12784.3 / 8192 \approx 1.56\) ns。第二行扫描同一个请求体,但 SQL 注入类别为审计模式,其他类别为强制模式:15,485.4 ns。当某个类别为审计而非强制时,每个字段按类别分别检查(SID 0004,“检查模式”)。引擎用签名自动机扫描字段一次,得到出现了签名的类别集合,然后只在其中搜索需要的类别,因此审计一个类别比强制所有类别大约多花五分之一,而不是每个类别各扫描一次。
完整产品比较
表中给出每种形态和工作负载下三次五秒 wrk 运行的中位数。每个工作负载旁边的状态码是测量工具期望并实际收到的应答。
Forward-auth 模式
入口代理询问守护进程是否准入一个请求;没有源站,也没有请求体中继,因此这是对准入成本最纯粹的测量。
| 形态 | 工作负载(状态码) | req/s | p50 | p90 | p99 | CPU us/请求 | 峰值 RSS KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
211,345 | 151 | 175 | 305 | 11.84 | 15912 |
| Gate | challenged (401) |
198,315 | 160 | 180 | 326 | 13.15 | 16176 |
| Gate | allowed_static (200) |
211,053 | 152 | 175 | 305 | 11.73 | 16176 |
| Gate | attack (200) |
211,618 | 151 | 176 | 305 | 11.84 | 16176 |
| Shield | admitted (200) |
208,101 | 152 | 178 | 308 | 12.87 | 15928 |
| Shield | challenged (401) |
197,532 | 161 | 183 | 327 | 13.77 | 16192 |
| Shield | allowed_static (200) |
211,636 | 151 | 175 | 305 | 11.78 | 16192 |
| Shield | attack (403) |
210,549 | 152 | 175 | 307 | 12.32 | 16192 |
在 forward-auth 模式下,守护进程不是瓶颈。它的忙碌核心数(CPU 时间除以实际时间,即 JSON 文件中的 cores_busy_median)保持在四个守护进程 CPU 中的 2.47 到 2.72 之间,每一行都在每秒 197,532 到 211,636 个请求之间。这表明上限来自负载生成器。在这个上限附近,行与行之间几个百分点的差异会随运行而变化:仅 Gate 的 admitted 这一行,三次运行就从每秒 205,151 到 211,513 个请求不等。在这种模式下更有用的数字是每请求 CPU 时间:11.73 到 13.77 us,Shield 比 Gate 略多,challenged 各行最多,因为它们要渲染挑战应答。
反向代理模式
守护进程位于桩源站之前,中继已准入的请求和响应。因此,经代理的各行包含源站自身的成本和一次额外的回环跳转。
| 形态 | 工作负载(状态码) | req/s | p50 | p90 | p99 | CPU us/请求 | 峰值 RSS KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
142,498 | 427 | 548 | 768 | 27.68 | 15896 |
| Gate | challenged (200) |
199,465 | 160 | 181 | 324 | 12.98 | 16160 |
| Gate | allowed_static (200) |
147,303 | 411 | 541 | 759 | 26.88 | 16324 |
| Gate | attack (200) |
143,900 | 422 | 555 | 745 | 27.67 | 16348 |
| Shield | admitted (200) |
138,965 | 438 | 571 | 857 | 28.57 | 16064 |
| Shield | challenged (200) |
195,188 | 162 | 185 | 328 | 13.73 | 16328 |
| Shield | allowed_static (200) |
145,673 | 415 | 551 | 746 | 27.27 | 16328 |
| Shield | attack (403) |
209,507 | 151 | 177 | 306 | 12.17 | 16328 |
这里经代理的各行(admitted、allowed_static,以及由 Gate 中继的 Gate attack 行)受 CPU 限制:忙碌核心数为四个中的 3.96 到 3.98。它们每秒处理 138,965 到 147,303 个请求,每请求 CPU 时间为 26.88 到 28.57 us,约为守护进程自己作答时的两倍。challenged 各行和 Shield 的 attack 行由守护进程自己作答,看起来与 forward-auth 的各行相似。在饱和状态下,wrk 的 p99 是守护进程以自身速率运行时调度器的尾部,因此我们改为解读下一章的尾延迟。
在三个反向代理行中,wrk 统计到了不应出现的 2xx 和 3xx 以外的响应:三次运行合计,2,162,579 个请求中有 3 个(Gate attack),2,082,640 个中有 1 个(Shield admitted),2,204,358 个中有 1 个(Shield allowed_static)。文件没有记录这些响应的状态码。带守护进程指标复现这次运行后发现,它们是计入 sibuna_overloaded_total 的 503 应答:wrk 从一个地址打开它的 64 个连接,恰好等于默认的 --max-connections-per-ip;当一个连接在第 4,096 个请求之后被关闭时,wrk 在旧连接归还名额之前就重新连接了。守护进程现在会在写出关闭响应之前归还名额(SID 0002,“缺陷修复”);这些表格的数据早于该修复。
资源占用
| 指标 | 数值 |
|---|---|
| 守护进程可执行文件 | 49,113,856 字节 |
| 空闲常驻内存,产品运行 | 5,592 到 5,788 KiB |
| 工作负载期间的峰值常驻内存 | 15,896 到 16,348 KiB |
| 工作负载之后的常驻内存 | 16,176 到 16,348 KiB |
| 空闲常驻内存,原语运行 | 6,052 KiB |
| 策略引擎表 | 209,052 字节(堆) |
| 机器人签名表 | 42,244 字节(堆) |
| WAF 表 | 164,908 字节(堆) |
| 浏览器求解器模块(WebAssembly) | 14,744 字节 |
范围取自四次产品运行(两种模式、两种形态),峰值则取自它们的十六个工作负载。表的大小是引擎报告的堆大小。记录没有细分可执行文件的大小构成。
相同施加负载下的延迟
两张表都来自 cargo xtask bench latency 的同一次运行。错误列统计生成器的连接、I/O 和分帧错误。
| 施加 req/s | 实际 req/s | p50 | p90 | p99(最小-最大) | p99.9 | 最大值 | 错误 | CPU us/请求 |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 10,000 | 30 | 32 | 37 (36-39) | 58 | 355 | 0 | 16.92 |
| 25,000 | 25,000 | 28 | 31 | 34 (32-34) | 45 | 1035 | 0 | 15.83 |
| 50,000 | 50,000 | 25 | 27 | 30 (30-30) | 40 | 3029 | 0 | 13.83 |
| 100,000 | 99,998 | 24 | 26 | 41 (40-42) | 62 | 2358 | 0 | 13.48 |
| 150,000 | 149,996 | 25 | 36 | 51 (51-52) | 74 | 1753 | 0 | 14.16 |
| 施加 req/s | 实际 req/s | p50 | p90 | p99(最小-最大) | p99.9 | 最大值 | 错误 | CPU us/请求 |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 10,000 | 56 | 61 | 65 (65-66) | 76 | 555 | 0 | 32.25 |
| 25,000 | 25,000 | 51 | 54 | 58 (58-60) | 72 | 1105 | 0 | 28.63 |
| 50,000 | 50,000 | 47 | 50 | 60 (58-66) | 74 | 3066 | 0 | 27.45 |
| 100,000 | 99,996 | 55 | 75 | 100 (100-104) | 150 | 2239 | 0 | 28.42 |
| 150,000 | 134,344 | 583934 | 1544160 | 1906273 (1631234-2218760) | 1967134 | 1989964 | 4 | 29.22 |
在 forward-auth 模式下,每种速率的 p50 都保持在 24 到 30 us 之间。直到每秒 150,000 个请求,p99 都不超过 51 us,p99.9 不超过 74 us。守护进程每请求消耗 13.48 到 16.92 us 的 CPU 时间。
在反向代理模式下,直到每秒 100,000 个请求,p50 为 47 到 56 us;在每秒 100,000 个请求时,p99 为 100 us,p99.9 为 150 us。在每秒 150,000 个请求时,守护进程达到饱和:它每秒完成 134,344 个请求,延迟增长到秒级,这正是开环测试在超出容量时应当显示的结果。这一速率接近上一章中闭环测得的代理吞吐量(Shield admitted 为每秒 138,965 个请求)。该行的四个错误发生在过载期间。
在饱和之前,p99 的离散范围很窄;最宽的是每秒 50,000 个请求时反向代理的 p99,为 58 到 66 us。最大值列是一次运行中多达 150 万个请求里的一个。在共享主机上,我们把它解读为主机最糟糕的时刻,而不是守护进程的性质。
测量带来的改变
外部负载改变了 Sibuna 的设计。守护进程在独立的线程上服务每个连接(SID 0002,SID 0010),它最初的几次延迟测量发现了一个 wrk 没有显示出来的尾部。在 64 个连接、每个连接由守护进程在 4,096 个请求后关闭的情况下,每秒 100,000 个已准入请求时的第 99.9 百分位为 0.3 到 2 ms。
SID 0002 和 cmd/sibuna/src/tasks.rs 的文档中记录的诊断结论是线程更替。创建和结束一个线程会映射和解除映射它的信号栈,并归还它的栈页面,而这些地址空间的变化拖住了守护进程的其他线程。一个实验就解决了这个问题:在一个从不关闭连接、因而运行期间不创建任何线程的构建中,相同速率下的结果是 54 到 60 us。修复方法是复用连接线程:完成连接的线程停驻并接手下一个连接,因此持续不断的新连接不会创建线程。停驻 10 秒的线程会结束,并由下一次启动或下一个完成任务的线程 join,因此突发流量不会让它的栈一直驻留。连接发生 panic 的线程会结束,而不是停驻。与之前一样,同时服务的连接最多为 --max-connections 个。
上面的表格来自修复之后的运行:每秒 100,000 个请求时,forward-auth 模式的 p99.9 为 62 us,反向代理模式为 150 us。修复之前的运行没有保留为结果文件,因此它们的数字只出现在 SID 0002 和本节中。
Sibuna 与 Anubis
Techaro 的 Anubis 是一种广泛部署的工作量证明网关,与 Sibuna 的 Gate 一样位于网站之前。我们在同一台主机、同样的 CPU 上,用同样的工作负载,把 Anubis v1.27.0 的官方发布可执行文件(anubis-1.27.0-linux-amd64,40,001,698 字节)与 Sibuna 并列测量。两个结果文件由以下命令记录:
cargo xtask bench product --anubis <path/to/anubis>
cargo xtask bench admission --anubis <path/to/anubis>
Anubis 的启动方式与本项目早期的 Python 驱动程序相同:--bind、--metrics-bind、--target=(forward-auth 模式下为空,反向代理模式下为源站)、--difficulty 2、--slog-level ERROR、--cookie-secure=false,以及一个对每个 Mozilla User-Agent 发起挑战、并停用 DNSBL 和蜜罐的策略。GOMAXPROCS 等于 Sibuna 的 worker 数量,两个产品的每个线程都绑定到同一个 CPU 集合。Hashcash 工作量是对等的:Sibuna 为 8 个零比特,Anubis 为 2 个十六进制零位,期望都是 256 次哈希。测量工具像浏览器那样获取每个产品的会话。对于 Anubis,它获取挑战页面,从 <script id="anubis_challenge"> 中读取挑战,找到使 SHA-256(randomData || nonce) 以 00 开头的 nonce,并连同页面的验证 Cookie 一起把它传给 pass-challenge。在 forward-auth 模式下,admitted 和 challenged 工作负载访问 Anubis 的检查端点(/.within.website/x/cmd/anubis/api/check)。
完整产品工作负载
四种工作负载、负载和统计方法都与完整产品测量工具相同,只有一处改动:源站是绑定到负载 CPU 上的 caddy respond,与早期驱动程序的做法一致。每次运行之前,测量工具都会等待处于 TIME_WAIT 状态的套接字少于 3,000 个,因为 Anubis 的反向代理运行会留下数以万计这样的套接字。
| 工作负载 | 指标 | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s(状态码) | 210,682 (200) | 208,635 (200) | 36,509 (200) |
| p99 us | 305 | 308 | 7,477 | |
| CPU us/请求 | 12.09 | 13.21 | 106.30 | |
| 峰值 RSS KiB | 16,228 | 16,316 | 32,624 | |
challenged |
req/s(状态码) | 198,251 (401) | 193,087 (401) | 113,170 (401) |
| p99 us | 326 | 342 | 3,781 | |
| CPU us/请求 | 13.49 | 15.02 | 32.96 | |
| 峰值 RSS KiB | 16,240 | 16,328 | 32,696 | |
allowed_static |
req/s(状态码) | 212,569 (200) | 212,444 (200) | 89,904 (200) |
| p99 us | 304 | 304 | 4,547 | |
| CPU us/请求 | 11.73 | 11.95 | 41.63 | |
| 峰值 RSS KiB | 16,240 | 16,328 | 33,396 | |
attack |
req/s(状态码) | 212,086 (200) | 211,347 (403) | 36,853 (200) |
| p99 us | 305 | 306 | 7,283 | |
| CPU us/请求 | 12.07 | 12.56 | 104.88 | |
| 峰值 RSS KiB | 16,240 | 16,328 | 33,764 |
| 工作负载 | 指标 | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s(状态码) | 106,376 (200) | 103,298 (200) | 19,398 (200) |
| p99 us | 3,331 | 3,321 | 11,062 | |
| CPU us/请求 | 27.02 | 27.92 | 190.40 | |
| 峰值 RSS KiB | 16,528 | 16,444 | 39,980 | |
challenged |
req/s(状态码) | 198,402 (200) | 197,327 (200) | 28,842 (200) |
| p99 us | 325 | 328 | 9,546 | |
| CPU us/请求 | 13.05 | 13.78 | 137.73 | |
| 峰值 RSS KiB | 16,544 | 16,464 | 516,872 | |
allowed_static |
req/s(状态码) | 105,427 (200) | 106,819 (200) | 28,862 (200) |
| p99 us | 3,320 | 3,316 | 30,124 | |
| CPU us/请求 | 26.24 | 26.52 | 135.41 | |
| 峰值 RSS KiB | 16,544 | 16,464 | 616,548 | |
attack |
req/s(状态码) | 105,616 (200) | 210,483 (403) | 23,399 (200) |
| p99 us | 3,327 | 306 | 14,124 | |
| CPU us/请求 | 26.98 | 12.28 | 169.04 | |
| 峰值 RSS KiB | 16,544 | 16,464 | 599,516 |
在 forward-auth 模式下,Sibuna 每秒处理 193,087 到 212,569 个请求,p99 为 304 到 342 us;Anubis 每秒处理 36,509(admitted)到 113,170(challenged)个请求,p99 为 3,781 到 7,477 us。Sibuna 的忙碌核心数保持在四个中的 2.49 到 2.90 之间,因此上限由负载生成器设定;Anubis 为 3.73 到 3.88,因此 Anubis 受 CPU 限制。最清楚的数字是每请求 CPU 时间:一个已准入请求在 Sibuna Gate 上耗费 12.09 us,在 Anubis 上耗费 106.30 us。这一差异的一部分很可能来自会话令牌。Anubis 默认用 Ed25519 签名会话,而 Sibuna 检查带密钥 BLAKE3 MAC(原语表中为 155.8 ns);下面的准入测量中,HS512 令牌使 Anubis 的会话检查提高了一半以上,这支持了上述解读。
在反向代理模式下,Sibuna 经代理的各行每秒处理 103,298 到 106,819 个请求,忙碌核心数为 2.77 到 2.98。这低于 product-latest.json 中桩源站下的 138,965 到 147,303,而守护进程并未受 CPU 限制,因此上限位于守护进程之外:源站 caddy respond 与 wrk 共享负载 CPU。它的尾部体现在 2.1 到 2.4 ms 的 p90 上。Anubis 每秒处理 19,398 到 28,862 个请求,忙碌核心数为 3.68 到 3.97,每请求 CPU 时间为 135 到 190 us。它的常驻内存从 admitted 工作负载中的 39,980 KiB 增长到 challenged 中的 516,872 KiB 和 allowed_static 中的 616,548 KiB,工作负载结束后仍占用 589,276 KiB,而空闲时为 21,552 KiB。增长始于 challenged,其中每个请求都会收到一个带有自己 ID 的新挑战;这暗示它为每个签发的挑战保存了一条记录,但测量工具没有证实原因。在两种模式的每一行中,Sibuna 的峰值都保持在 16,228 到 16,544 KiB 之间。
还有几行也不是同类比较:
- 在 forward-auth 模式下,Anubis 自己以
200回答/robots.txt和attack路径,不经过源站;Sibuna 则像回答该模式下的任何请求一样回答它们。 - Anubis 没有请求检查,因此它会准入
attack工作负载中的 SQL 注入。Shield 在付出更多工作之后以403拒绝它;Gate 则像 Anubis 一样准入它。 - 两个产品签名会话的方式不同(Anubis 默认使用 Ed25519,Sibuna 使用带密钥 BLAKE3 MAC),渲染的挑战页面也不同。
准入操作
准入测量工具在 forward-auth 模式下,为构成准入的四种操作计时,每个产品使用两个 CPU(两个 Sibuna worker,GOMAXPROCS=2)。负载 CPU 上的两个客户端线程各持有一个 keep-alive 连接,共同完成每个批次:200 次操作,验证则为 64 个证明,都在批次开始之前准备好。我们报告七个批次的中位数。
- 会话检查:带有效会话访问检查端点(
200)。 - 未认证检查:同样的请求,但不带 Cookie(
401)。 - 挑战引导:浏览器为开始一个挑战而获取的内容。对 Sibuna 而言是两个请求,即验证中间页和挑战记录;对 Anubis 而言是一个请求,即内嵌了挑战的页面。
- 证明验证:每次操作一个新证明。Sibuna 的证明挑战以 25 ms 的间隔签发,低于其自适应难度开始增加比特的每秒 50 次,因此对等的工作量保持不变。Sibuna 以
--challenge-rate-limit 100000000运行,因此它的限制器会被检查,但永远不会耗尽。
Anubis 运行了两次,一次使用默认的 Ed25519 令牌,一次使用 --hs512-secret。
| 产品(令牌) | 会话检查 | 未认证检查 | 挑战引导 | 证明验证 | 运行后 RSS,KiB |
|---|---|---|---|---|---|
| Sibuna(带密钥 BLAKE3) | 88,104 | 78,997 | 42,664 | 57,924 | 7,792 |
| Anubis 1.27.0(Ed25519) | 10,951 | 28,619 | 7,893 | 12,668 | 33,400 |
| Anubis 1.27.0(HS512) | 16,976 | 27,785 | 7,952 | 19,261 | 29,840 |
七个批次的范围记录在文件中。Sibuna 的范围在其中位数的 11% 以内;Anubis 的范围更宽(使用 Ed25519 令牌的未认证检查从 25,394 到 32,741 不等),而且一个 200 次操作的批次只持续 2 到 25 ms,因此我们只把这些数字解读到大约十分之一的精度。较慢客户端的每次操作时间给出了往返时间:Sibuna 会话检查为 22.7 us,使用 Ed25519 令牌的 Anubis 检查为 182.5 us,使用 HS512 时为 117.7 us。
在上面任何一行中,Anubis 处理的请求都没有比 Sibuna 多,使用的 CPU 或内存也没有比 Sibuna 少。这只是关于这台主机上这些工作负载的陈述,仅此而已。
控制台开销
SID 0007 规定了控制台的隔离约定。启用控制台最多只能使数据平面的吞吐量降低 1%,使 p99 延迟增加 10%,这需要在一个由配置(编译时排除、编译进来但停用、空闲、八个活动仪表板)和工作负载组成的矩阵上测量,采用多次交错运行并报告不确定度。不确定或噪声过大的运行不能证明达标,原语基线和冒烟测试也不能代替这道门槛。
SID 0010 记录了一次测量:在控制台编译进来但停用、仅启用存储、或启用但空闲的情况下,16 个产品工作负载与不含控制台构建的守护进程相差都在约 1% 以内,处于噪声范围内。该记录没有为此注明结果文件。负载下运行八个活动仪表板的配置尚未测量,因此 SID 0007 的正式门槛仍未完成。
八仪表板运行检验的是功能,而不是开销。sibuna-browser dashboards 在一个 SQLite 节点上启动了一个带控制台的 release 守护进程,配置四个 worker,以及一个放行 /static/*、/about、/missing/* 和 /broken/*、对其他一切发起挑战的策略;一个源站测试桩对 /missing/* 回答 404,对 /broken/* 回答 500。生成器以每秒 200 个请求的速率发送 30 秒,轮流使用十个路径(其中一个是 SQL 注入)、三个 User-Agent 和 500 个转发地址。每个仪表板运行在自己的 Chromium 中,使用自己的会话:仪表板 1 到 3 是管理员会话,仪表板 4 到 8 是用第一个仪表板生成的代码打开的大屏显示,因为控制台对每个地址和每个账户每分钟只允许五次登录。
| 指标 | 数值 |
|---|---|
| 数据平面请求 | 30.0 秒内 6,000 个(每秒 200 个,4 个线程,每个请求一个连接) |
| 已应答 | 6,000: 200 x 1,200, 401 x 3,000, 403 x 600, 404 x 600, 500 x 600 |
| 错误(无回复) | 0 |
| 延迟 p50 / p90 / p99 / 最大值 | 246 / 311 / 373 / 552 us(含建立连接) |
| 启动时守护进程的 VmRSS | 36,152 KiB |
| 打开 8 个仪表板时守护进程的 VmRSS | 38,028 KiB |
| 流量结束后守护进程的 VmRSS | 41,496 KiB(VmHWM 41,496 KiB) |
在流量期间每两秒读取一次各张指标卡片,并在流量结束后 3 秒再读取一次。每个仪表板最终都显示相同的总数(Requests 6,000、Admitted 2,400、Challenged 3,000、Policy denied 600、Origin 4xx 600、Origin 5xx 600),收到 134 到 139 个 stats 增量,保持 WebSocket 打开,并且没有报告任何异常、控制台错误或 Content-Security-Policy 违规。八个浏览器订阅者远低于控制台 64 个的上限。这次运行的守护进程带有 SQLite 存储和控制台,不同于产品测量工具中的内存型守护进程,因此它的常驻内存不能与它们比较。
未测量的内容
| 对象 | 这里为什么没有测量 | 代替的依据 |
|---|---|---|
| SafeLine 社区版 9.x | 只以 Docker Compose 组件栈的形式发布;主机上没有 Docker 守护进程,而检测器镜像也不是可以在那里编译的开源构建 | 公开发布的、由厂商报告的事实(2026 年 9 月核查):检出率 71.65%(平衡)和 76.17%(严格),误报率 0.07%(平衡)和 0.22%(严格);最低主机要求为带 SSSE3 的 Linux x86_64 或 arm64、1 个 CPU 核心、1 GB 内存、5 GB 磁盘、Docker 20.10.14+ 和 Compose 2.0+ |
| Cloudflare WAF | 这是一项托管服务;回环测量测到的将是网络路径,而不是 WAF | 公开发布的套餐配额(2026 年 9 月核查):自定义规则 Free 5、Pro 20、Business 100、Enterprise 1000;速率限制规则 Free 1、Pro 2、Business 5、Enterprise 100 |
| 负载下的集群 | 目前还没有测量工具在同一个 PostgreSQL 数据库上驱动多个节点 | SID 0011 规定的协议性质(一个共享种子,挑战与签发者绑定)及其三节点功能测试(标准 2);没有测量 |
| 请求路径上的存储 | 在每套测量工具中,两个守护进程都在内存模式下运行 | SID 0011:一个存储线程负责所有 SQL,请求路径从不等待它 |
| TLS、广域网、真实浏览器 | 测量工具使用回环接口和 HTTP;每种情形的会话由 sibuna-pow 求解一次 |
没有;部署需要测量自己的路径 |
| 浏览器求解器的求解时间 | 测量工具用原生求解器在 8 比特下求解 | 上面给出的模块大小;第 VII 部分解释了为什么原生耗时不能代表浏览器求解时间 |
| 分配次数 | 测量工具没有对分配器进行插桩 | 第 V 部分的稳态测试 |
| 负载下运行八个活动仪表板时的控制台隔离 | SID 0007 的正式门槛测试尚未进行 | SID 0010 的数字(控制台空闲时在约 1% 以内)以及上面的功能性运行 |
这张表中的一行并不是关于该产品性能的结论。SafeLine 自己的数字关注的是检测质量,而不是吞吐量;Cloudflare 公布的是套餐配额,而不是每请求成本。任何拥有 Docker 主机的人都可以在同样的 wrk 工作负载下运行 SafeLine。