第 III 部分:来自密码学研究的基础
我们推导 Sibuna 两层工作量证明背后的成本模型,介绍 Cohen-Pietrzak 顺序工作量证明及其安全性论证,并说明为什么用带密钥哈希来认证挑战和会话。SID 0006 记录了相关的假设和参考文献。
Hashcash:第一层的数学
定义与成本
对于挑战字符串 \(C\) 和 \(b\) 比特的难度,Sibuna 的第一层谜题是:找到 \(N \in \mathbb{N}\),使 \(\text{SHA-256}(C \parallel \text{":"} \parallel \mathrm{dec}(N))\) 具有 \(b\) 个前导零比特。nonce 采用十进制表示是有意为之;它使 WebAssembly 求解器、JavaScript 后备实现和原生验证器之间的线路格式保持一致,而不需要二进制编码步骤。
难度的单位是一次期望的 哈希尝试,而不是一次压缩函数调用。一个输入可能占用多个 SHA-256 分组。前缀预计算也会改变每个 nonce 的工作量。线路规则始终是摘要谓词;各个实现必须就陈述和 nonce 编码达成一致,而不是就估计的 CPU 成本达成一致。
对于相互独立的理想摘要,尝试次数 \(X\) 服从参数为 \(p = 2^{-b}\) 的几何分布。它的中位数是 \(\left\lceil \ln(1/2) / \ln(1-p) \right\rceil\),当 \(p\) 很小时约为 \(2^b \ln 2\),方差为 \((1-p)/p^2\)。验证者只检查一个候选摘要,而不执行搜索。解析、挑战认证、指纹检查、写入已用状态以及响应都是额外的工作。不能从一个原语的耗时反推出服务器抵御洪泛的能力。
搜索的两个局限
第一个局限是方差:一次很长的搜索并不一定意味着 worker 出了故障。第二个局限是并行性:相互独立的 nonce 尝试可以并发执行。即使期望的总尝试次数不变,更多的核心也会缩短搜索的实际耗时。因此,硬件吞吐量对准入策略很重要。无论是声称的哈希速率还是单次基准测试,都无法给每个请求方的优势划定上界。
顺序工作量证明:第二层
为什么需要顺序工作量
顺序工作量构造在计算之间引入依赖:后面的标签需要前面算出的值。它针对的是与总工作量不同的一个量,即计算的深度。相互独立的谜题仍然可以并行运行,硬件的哈希延迟也仍然重要。
Sibuna 采用 Cohen 和 Pietrzak 描述的基于哈希的构造。深度为 \(n\) 时,它的图有 \(2^{n+1}-1\) 个标签,但固定的标签数并不意味着确定的浏览器延迟:标签可能跨越多个压缩分组,揭示可能需要重新计算子树,调度也会带来波动。不能把预言机模型分析得出的安全性陈述,变成关于每个具体实现或每个对手的无条件结论。
构造
令 \(n\) 为深度,考虑一棵完全二叉树,其节点以长度不超过 \(n\) 的二进制串命名(根为 \(\varepsilon\),子节点为 \(v0\) 和 \(v1\),叶子的长度为 \(n\))。每个节点 \(v\) 带有一个 32 字节的标签 \(\ell_v = H(\chi, v, \mathrm{parents}(v))\),其中 \(\chi\) 是挑战陈述,\(H\) 是只吸收一次 \(\chi\) 的 SHA-256(与 Hashcash 求解器相同的前缀技巧):
- 内部节点对它的两个子节点做哈希:\(\ell_v = H(\chi, v, \ell_{v0}, \ell_{v1})\);
- 叶子 \(u = u_1 \dots u_n\) 在根路径每次向右转的地方,对 其祖先的左兄弟 做哈希:\(\ell_u = H(\chi, u, \{\ell_{u_1 \dots u_{i-1} 0} : u_i = 1\})\)。
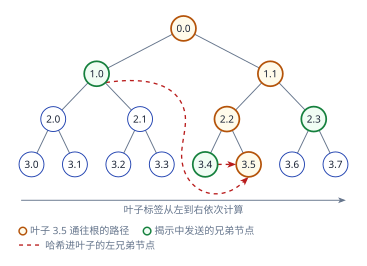
左兄弟边正是使计算成为顺序过程的原因:在叶子 \(u\) 左侧的每棵子树都完成之前,无法计算它的标签,因此只能按深度优先的后序遍历进行,根标签 \(\varphi = \ell_\varepsilon\) 依次依赖于全部 \(2^{n+1} - 1\) 个标签。
揭示。 计算出 \(\varphi\) 之后,证明者通过 Fiat-Shamir 导出 \(t\) 个叶子,\(\gamma_i = H(\chi \parallel \varphi \parallel i) \bmod 2^n\),并为每个叶子发送叶子标签和其根路径上的 \(n\) 个兄弟标签。验证者用作为父节点的兄弟标签重新计算叶子,沿路径向上做哈希,并检查最终是否得到 \(\varphi\)。验证者的成本是 \(O(tn)\) 次标签计算,所需工作空间有界。一次标签计算可能跨越多个哈希分组;统计标签数并不等于统计压缩函数调用次数。
fn verify_opening(base: &Sha256, n: u8, phi: &Label, gamma: u32, opening: &[Label]) -> bool {
let Some((leaf, siblings)) = opening.split_first() else {
return false;
};
// `siblings` 从深度 n 向上排到深度 1;反转之后,它与深度 1..=n 一一配对。
let mut hasher = node_hasher(base, n, gamma);
for (d, sibling) in (1..=n).zip(siblings.iter().rev()) {
if turns_right(gamma, n, d) {
hasher.update(sibling);
}
}
if hasher.finalize() != *leaf {
return false;
}
let mut current = *leaf;
for (d, sibling) in (1..=n).rev().zip(siblings) {
let mut parent = node_hasher(base, d - 1, gamma >> (n - d + 1));
if turns_right(gamma, n, d) {
parent.update(sibling);
parent.update(¤t);
} else {
parent.update(¤t);
parent.update(sibling);
}
current = parent.finalize();
}
current == *phi
}
抽样、可靠性及其局限
考虑一个固定的承诺,其中有比例为 \(\alpha\) 的坏位置,且每个坏位置都可以独立检测出来。如果每次揭示都独立、均匀地抽样,那么 \(t\) 次揭示全部错过坏位置的概率是 \((1-\alpha)^t\)。这个初等计算解释了为什么更多的揭示有帮助。但它本身并不是顺序工作量协议的安全性证明。
所引用的顺序工作量构造在一个预言机模型中有安全性分析。Sibuna 的域分离、参数映射、截断和实现,仍然必须对照该构造的假设进行检查。Fiat-Shamir 抽样使揭示可以从承诺复现;但仅有可复现性并不能证明能够抵御反复尝试(grinding)。我们不作出“作弊永远不会更便宜”这样的无条件声明。
证明者的内存
朴素的证明者会保存每个标签(共 \(2^{n+1} - 1\) 个)。Sibuna 的证明者在第一遍计算时维护一个栈,保存当前路径的左兄弟标签(\(n + 1\) 个标签),并只保留最上面的 \(m = \min(n, 10)\) 层(\(2^{m+1} - 1\) 个标签,最多 64 KB)。为了揭示一个叶子,它重新计算该叶子在深度 \(m\) 处的祖先的子树,共 \(2^{n-m+1} - 1\) 次哈希,并用保留的各层初始化栈。证明者的总成本是 \(2^{n+1} - 1 + t\,(2^{n-m+1} - 1)\) 次哈希,整个工作空间(包括输出的证明)不到 100 KB:浏览器标签页和原生测试共用同一个 Workspace 类型(sibuna_pow::posw::Workspace)。
参数不是耗时
Sibuna 用 \(n = b - 3\) 把工作比特映射为深度,并限制在支持的区间 \([4, 24]\) 内。这是一个工作量尺度上的约定,并不保证不同算法的实际耗时相等。一个叶子可能要对多个父标签做哈希,而 Hashcash 是反复测试 nonce。编译器、浏览器、处理器和参数的选择都会影响它们的相对成本。已提交的原语基准测试测量的是验证;它并不能说明浏览器的求解延迟。
证明的大小是 \(32(1 + t(n+1))\) 字节。在深度 13、十六次揭示时,大小为 \(32(1 + 16 \times 14) = 7200\) 字节。即使构造树这一主要成本保持不变,增加揭示次数也会同时增大证明和验证者的工作量。
选择一种构造
有意义的比较对象是资源预算,而不是算法的名声。记录证明者的内存、验证者的最坏情况工作量、证明的字节数,以及所声称的性质需要的假设。内存困难的搜索可能有用,但如果验证者必须重复昂贵的工作,攻击者就多了一个消耗服务器资源的地方。可公开验证的延迟构造所服务的信任模型,与共享密钥的网关不同。
Sibuna 保留了低成本的哈希验证,以及一个基于哈希的顺序工作量选项。后者需要更多的证明字节和更仔细的参数分析。无论哪种选择,都需要在进入昂贵的验证之前拒绝格式错误的证明。
对称认证:挑战与会话
签发者即验证者
数字签名让 任何 持有公钥的人都能验证;当验证者不应具备签发能力时,它是正确的工具。Sibuna 的验证者 就是 签发者(或共享同一个种子的集群)。由伪随机函数构建的消息认证码在这个信任域内提供认证。它不提供公开验证:任何持有 MAC 密钥的人也都能签发令牌。基准测试一章比较了已实现的令牌操作。
从长远看,还有第二个重要推论:Ed25519 依赖于椭圆曲线群上的离散对数,而 Shor 算法可以攻破它;带密钥哈希只依赖于哈希函数,量子算法对它至多带来平方级加速。对于需要验证者不具备签发能力的部署,Sibuna 保留 Ed25519 作为选项(--token-scheme ed25519)。
密钥派生方案
一个 32 字节的主种子(来自 --secret-file、SIBUNA_SECRET 或一个新生成的随机值)通过带密钥 BLAKE3 和域字符串派生出每个用途的密钥:令牌密钥、挑战密钥、Ed25519 密钥、指纹密钥,以及用于封装要求票据的要求密钥(第 IV 部分)。
pub fn derive(seed: &Seed) -> Keys {
    Keys {
        token: subkey(seed, "sibuna/token/v1"),
        challenge: subkey(seed, "sibuna/challenge/v1"),
        ed25519_seed: subkey(seed, "sibuna/ed25519/v1"),
        fingerprint: subkey(seed, "sibuna/fingerprint/v1"),
        requirement: subkey(seed, "sibuna/requirement/v1"),
    }
}

fn subkey(seed: &Seed, purpose: &str) -> [u8; 32] {
    blake3::keyed_hash(seed.as_bytes(), purpose.as_bytes())
}
在集群中,Keys::bind_node 以挑战密钥为密钥,对 sibuna/challenge-node/v1 和节点 ID 计算带密钥 BLAKE3,并用结果替换挑战密钥。这样,挑战必须回到签发它的节点,而会话令牌和要求票据在每个成员上都保持有效。
域分离可以防止不同用途之间的意外复用;主种子一旦泄露,所有派生密钥都会随之泄露。集群只需要就一个种子达成一致。
无状态挑战
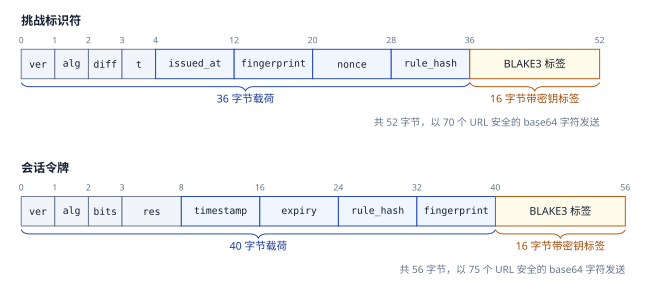
挑战标识符是一个自认证记录:版本、算法、难度、揭示次数、签发时间、客户端的带密钥指纹、由 PRF 派生的 nonce,以及要求该挑战的策略规则的哈希,后面跟着一个用挑战密钥计算的 16 字节标签。签发挑战不写入任何内容。验证时先解码记录,以常量时间检查标签,对照挑战 TTL 检查时效,对照提交方客户端检查指纹,最后才检查证明。
已用集合由 16 个分片组成,每个分片对 16 字节标签使用 Robin Hood 开放寻址(第 V 部分)。指纹是客户端地址和 User-Agent 的带密钥哈希;输入按长度分隔,使任何两个输入都不会因拼接而碰撞;并且带有密钥,使其他客户端的指纹无法离线计算。