第 V 部分:Rust 中的零分配工程
我们通过一个固定的缓冲区,跟随一个连接从接受到响应的全过程,并考察那些让许多连接线程在请求路径上无需堆分配即可共享状态的并发数据结构。在内存安全原本需要专门机制(读者计数、内存区、描述符表、拆除链)的地方,我们展示 Rust 的所有权如何取而代之。
连接循环
每个连接一个线程,并且有界
接受 worker(--workers,默认每个 CPU 一个,最多 64 个)共享监听套接字。每个被接受的连接交给一个拥有 1 MB 栈的独立线程,接受循环随即回到 accept。完成连接的线程会停驻并接手下一个连接,因为为每个连接创建并结束一个线程会拖住其他线程(第 VIII 部分,SID 0002)。另一种做法是在接受线程上把连接一直服务到结束,这也是最初的设计:它在单个客户端时测得很好,在六十四个客户端时却很差,因为其中六十个要等待某个 worker 用完它 256 个请求的配额,尾延迟随每个等待的客户端而增长。采用每连接一个线程后,在每种完整产品工作负载中,64 个连接时的 p99 都保持在一毫秒以下,从 305 us 到 857 us 不等(benchmarks/results/product-latest.md;第 VIII 部分)。
连接线程的数量受 --max-connections 限制(默认 1,024,最多 8,192)。超过上限时,接受循环在新套接字上回答 503 Service Unavailable 并关闭它,不创建任何线程,同时把这一事件计入 sibuna_overloaded_total。
fn accept_loop(server: &Arc<Server>, listener: &TcpListener) {
    while !server.is_stopping() {
        let stream = match listener.accept() {
            Ok((stream, _)) => stream,
            // ... 文件描述符或内存耗尽:退避 1 ms,而不是空转
        };
        let limit = server.max_connections.load(Ordering::Relaxed);
        if server.connections.fetch_add(1, Ordering::Relaxed) >= limit {
            server.connections.fetch_sub(1, Ordering::Relaxed);
            server.metrics.overloaded.bump();
            let text = "Service Unavailable: connection limit reached";
            reject(server, &stream, text);
            continue;
        }
        set_no_delay(&stream);
        let task_server = Arc::clone(server);
        let launched = server.tasks.launch(move || {
            let _counted = Counted(&task_server);
            crate::connection::serve(&task_server, &stream);
        });
        // ... 启动失败时归还名额,并记一次过载
    }
}
Counted 是一个守卫,无论线程以返回还是 panic 结束,它的 Drop 都会把该连接在上限中占用的名额归还。503 路径在关闭自己一侧的套接字之前,会先读完客户端已经发送的内容:关闭一个还有未读字节的套接字会以复位作答,而复位会让 503 被丢弃。
线程来自一个 TaskPool(cmd/sibuna/src/tasks.rs),即一张由可 join 的槽组成的固定表。结束的线程在被 join 之前会保留它的栈,因此一个槽会在被再次占用时 join,并且新任务占用 编号最小 的已结束槽,而不是推进一个游标。游标要绕表一整圈才会再次到达一个已结束的槽,这会让数千个已结束的线程驻留在内存中,内存将随已服务的连接数增长,而不是随打开的连接数增长。第二个守卫 Finished 在任务结束时把槽标记为空闲,因此发生 panic 的连接同样会释放它的槽。
内存也以同样的方式有界。一个连接线程在栈上持有 64 KiB 的读缓冲区和 16 KiB 的写缓冲区,并在堆上持有一个 40 KiB 的代理工作空间,后者在连接开始时一次性分配。因此,最坏情况是一个已知的数字,而不是客户端能打开多少套接字的函数。空闲回收器(见下文)关闭停止发送的连接,使慢速客户端无法占住一个线程超过 --idle-timeout。
分配器的选择
Rust 1.100 稳定了 Allocator API 的核心部分以及 Vec 和 Box 的分配器参数(发行说明)。我们可以为单个集合选择分配器,而不替换整个进程的分配器。这项 API 无法再减少请求路径的分配:预热后的请求已经不分配内存,cmd/sibuna/tests/steady_state.rs 和 crates/net/tests/steady_state.rs 对此进行检查。代理为每个连接分配一次三个缓冲区,并重复使用它们。限流器和已用证明集合也只分配一次表;清零分配使未触及的页面不必驻留内存,crates/store/tests/resident.rs 对此进行检查。
研究分配器变更时,我们会先测量策略快照的构建和控制台的 JSON 解析。它们的临时集合在请求路径之外分配内存,但集合的分配器不会自动控制其元素的分配。我们的 JSON 树还通过 Cow<str> 拥有包含转义的字符串,其拥有形式为 String;Rust 1.100 的 String 没有分配器参数。Arc::new_in 在此版本中仍不稳定(API 文档)。已发布的引擎通过 Arc 共享,直到最后一个读取者释放它们,因此重建不能重置旧引擎仍在使用的内存。内存区域分配器必须保留这些生命周期和解析器的输入边界。
我们保留控制台 WebAssembly 模块在 cmd/console-ui/src/abi.rs 中现有的全局分配器 WipeOnFree。它会擦除释放的内存块,包括重新分配后的旧块。直接为集合选择 System 会绕过这项擦除。工作量证明 WebAssembly 模块没有堆分配器,Argon2 也已经使用调用者拥有且可重复使用的工作区。因此,我们保留现有分配器和 Rust 1.94 兼容性,直到测量到的工作负载能够证明变更合理。候选方案必须改善延迟或驻留内存,同时保留擦除、有界输入处理和不分配内存的请求路径。
每个连接一个缓冲区
请求路径上的每一次动态分配都是拒绝服务的杠杆:经年累月的内存碎片,线程之间对分配器锁的争用,以及攻击者精心构造请求以最大化分配所造成的放大。Sibuna 的规则是绝对的:分类、验证和代理交接都在零堆分配下运行。连接处理器在套接字的整个生命周期中拥有一个 64 KiB 的读缓冲区和一个 16 KiB 的写缓冲区;其他一切都是指向它们的切片。
pub fn serve(server: &Server, stream: &TcpStream) {
    let Some(lease) = server.idle.register(stream) else { return };
    // ...
    let mut read_buffer = [0u8; MAX_REQUEST_BYTES]; // 64 KiB
    let mut write_buffer = [0u8; WRITE_BUFFER]; // 16 KiB
    let mut reader = Reader::new(stream, &mut read_buffer[..]);
    let mut peer = PeerText::default();
    peer.format(stream.peer_addr().ok());
    let mut link = Link {
        server,
        stream,
        writer: Writer::new(stream, &mut write_buffer[..]),
        workspace: Workspace::new(),
        cache: EngineCache::new(),
        activity: lease.activity(),
        last: false,
    };
    for served in 0..MAX_REQUESTS_PER_CONNECTION {
        link.last = served + 1 == MAX_REQUESTS_PER_CONNECTION;
        if !serve_one(&mut reader, &mut link, peer.as_bytes()) {
            break;
        }
        lease.touch();
    }
}
read_head 不断填充缓冲区,直到出现空行为止,每次只搜索上次搜索之后到达的字节,并以 431 拒绝超过 16 KiB 的请求头部。parse_request(crate sibuna-http)产生一个 Request<'a>,其方法、路径、查询、请求头和 Cookie 都是缓冲区的切片。声明的请求体被填充到缓冲区能容纳的程度,并在头部之后切分出来。然后 reader.consume(head_len + body_len) 推进读取器,使下一个 keep-alive 请求干净地开始;读取器只在需要空间时才把未读字节移到前面。分块请求体在头部之后原地解码(SID 0009):每一步的分帧信息都从缓冲区中剪除,使解码后的前缀保持连续,便于检查。内部路由以长度定界,并保持连接打开。被代理的请求也会保持连接打开,前提是源站的响应有明确的分帧,且请求体已被完整缓冲;下面几节说明代理如何作出判断。
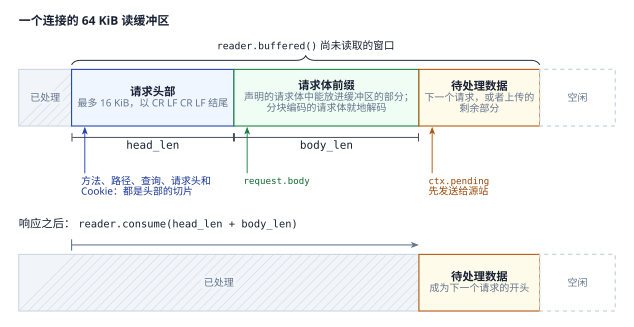
fn serve_one<W: Write>(
    reader: &mut Reader<'_, &TcpStream>,
    link: &mut Link<'_, W>,
    peer: &[u8],
) -> bool {
    let head_len = match read_head(reader) {
        Head::Complete(length) => length,
        Head::TooLarge => { /* 431 "Request head exceeds 16 KB" */ return false; }
        Head::Closed | Head::Failed => return false,
    };
    let framing = {
        let bytes = reader.buffered();
        let head = bytes.get(..head_len).unwrap_or_default();
        let request = match parse_request(head) {
            Ok(request) => request,
            Err(error) => return reject_head(link, error),
        };
        let declared = request.content_length().unwrap_or(0);
        // ... Expect: 100-continue
        if declared == 0 && !request.chunked {
            let upload = Upload::declared(&request);
            let pending = bytes.get(head_len..).unwrap_or_default();
            let keep = dispatch(link, request, pending, upload, 0, peer);
            reader.consume(head_len);
            return keep;
        }
        (declared, request.chunked)
    };
    serve_with_body(reader, link, peer, head_len, framing)
}
代理对请求头部的改写
请求头部不会原样转发。write_request_head(crates/net/src/request.rs,crate sibuna-net)把请求行和每个请求头重新写入源站写入器,同时丢弃逐跳字段(Connection、Keep-Alive、Proxy-Connection、Transfer-Encoding、TE、Trailer、Upgrade、代理授权字段)、任何传入的转发或审计字段(X-Forwarded-For、X-Real-IP、Forwarded、X-Forwarded-Proto、X-Forwarded-Host、X-Forwarded-Port、X-Sibuna-Status、X-Sibuna-Rule)、Expect、Content-Length,以及请求的 Connection 头所指名的每个字段。然后它追加审计字段集合。请求体的分帧由代理生成,从不复制:
for header in request.headers() {
    if is_hop_by_hop(header.name) || nominated(request, header.name) {
        continue;
    }
    out.write_all(header.name)?;
    out.write_all(b": ")?;
    out.write_all(header.value)?;
    out.write_all(b"\r\n")?;
}
match upload {
    Upload::None => {}
    Upload::Length(length) => {
        out.write_all(b"Content-Length: ")?;
        write_decimal(out, *length)?;
        out.write_all(b"\r\n")?;
    }
    Upload::Chunked(_) => out.write_all(b"Transfer-Encoding: chunked\r\n")?,
}
Content-Length 会被重新写出。在连接缓冲区内结束的分块请求体被原地解码,并带着长度发送。更长的请求体以 Transfer-Encoding: chunked 声明,并逐次读取、重新分块(SID 0009):每次读取的数据进入代理的 16 KiB 上传缓冲区,在那里原地解码,然后作为一个规范的块发出,因此源站永远看不到客户端的块大小、扩展或尾部字段。审计字段集合如下:
Connection: keep-alive
X-Forwarded-For: <client>
X-Forwarded-Proto: <scheme>
X-Real-IP: <client>
X-Sibuna-Status: PASS
X-Sibuna-Rule: session | robots-txt | ip/cidr-trie | ...
大于缓冲区的请求体以 16 KiB 为单位从客户端中继到源站写入器(relay_body),然后再把响应流式传回。crates/net/src/request.rs 中的单元测试 proxy_head_rewrite_drops_hop_by_hop_headers_and_injects_audit_fields 断言改写会丢弃伪造的 X-Forwarded-For 并注入审计字段。
代理的三个缓冲区,即源站读缓冲区(一个响应头部,16 KiB)、源站写缓冲区(8 KiB)和上传缓冲区(16 KiB),存放在一个 Workspace 中,由连接一次性分配并在每个请求中复用。工作空间使它们的生命周期与连接一致,而不是与单次交换一致,源站读取器和写入器每次只为一次交换借用它们。
中继源站响应
最初的代理把源站的字节一直流式转发到源站关闭连接为止,然后关闭客户端连接:无需解析就能得到正确的分帧,代价是每个被代理的请求都要新建一个 TCP 连接。在负载生成器下,这一代价表现为数以万计处于 TIME_WAIT 状态的套接字,在回环接口上还会耗尽临时端口。现在,代理读取源站的响应头部(最多 16 KiB),并按 RFC 9112 的规则对响应体分类:
pub enum Framing { None, Length(u64), Chunked, UntilClose }

pub fn parse_response_head(
    head: &[u8],
    head_request: bool,
) -> Option<ResponseHead> {
    let status = status_code(head)?;
    let mut fields = FramingFields {
        keep_alive: head.get(7) == Some(&b'1'),
        ..Default::default()
    };
    for line in crlf_lines(head).skip(1) {
        if line.is_empty() {
            break;
        }
        fields.read_line(line)?; // Transfer-Encoding, Content-Length, Connection
    }
    let mut framing = fields.length.map_or(Framing::UntilClose, Framing::Length);
    if head_request || status / 100 == 1 || status == 204 || status == 304 {
        framing = Framing::None;
    } else if fields.encoded {
        framing =
            if fields.chunked { Framing::Chunked } else { Framing::UntilClose };
    }
    let mut keep_alive = fields.keep_alive;
    if framing == Framing::UntilClose || fields.closing {
        keep_alive = false;
    }
    if fields.nominates_framing {
        return None;
    }
    Some(ResponseHead { status, framing, keep_alive })
}
解析器拒绝代理不得中继的内容:错误的状态行,不是 token 的字段名,值中的控制字节,相互冲突的长度,重复的或不在最后的 chunked 编码,以及指名 Content-Length 或 Transfer-Encoding 的 Connection 字段。它的工作量与头部长度呈线性关系,并且从不 panic。
响应头部被重新写给客户端,源站的 Connection 头被替换为 Sibuna 自己的决定,响应体则被精确中继:有长度时用 copy_exact,分块编码时逐块处理(大小行、数据、尾部字段),旧式情形用 copy_remaining。只有旧式情形会关闭客户端连接。每种中继都建立在同一个复制步骤之上:转发源端已经持有的所有数据,只有当它什么都没有时,才刷新目标端,然后读取一次。因此,一串小的写入会随产生随交付,而大块传输仍然在每次读写中搬运一整个缓冲区。
let keep = client_keep_alive && parsed.framing != Framing::UntilClose;
write_client_head(client, head, keep).map_err(client_head_error)?;
origin.consume(head_length);
match parsed.framing {
    Framing::None => {}
    Framing::Length(length) => copy_exact(origin, client, length, progress)?,
    Framing::Chunked => relay_chunked(origin, client, progress)?,
    Framing::UntilClose => copy_remaining(origin, client, progress)?,
}
client.flush().map_err(|_| ProxyError::ClientFailed)?;
Ok(Relayed { client_keep: keep, origin_reusable: parsed.keep_alive })
解析一个包含八个字段的源站响应头部需要 322 ns,通过回环接口代理一个响应为 1 KiB 的 keep-alive GET 需要 29.8 us(2026 年 10 月测量;crates/net/src/lib.rs 记录了这次测量)。
源站连接池
解析分帧还告诉代理 源站 套接字能否再次使用:一个不带 Connection: close 的 HTTP/1.1 响应(或带 keep-alive 的 HTTP/1.0 响应),如果其响应体已被完整消费,就会让套接字停在一个干净的请求边界上。这样的套接字进入一个容纳 256 个空闲源站连接的固定连接池,下一个被代理的请求从池中取用,而无需重新连接。没有连接池时,每个被代理的请求都会打开一个新的源站连接,每个关闭的连接都会让它的本地端口停留在 TIME_WAIT;在负载下,回环接口上的代理很快就会耗尽临时端口,吞吐量随之崩溃。
如果整个连接池只用一把锁,每个被代理的请求都会争用这把锁。因此连接池(crates/net/src/pool.rs)是条带化的:16 个条带,每个条带 16 个套接字,每个条带是一个独占一条缓存行的 Mutex<Vec<Arc<TcpStream>>>。线程在首次使用时以轮转方式分配到一个主条带,优先向它归还和从它取用;在重新连接之前,它还会查看其他条带,但不会等待已被持有的锁。
pub fn take(&self) -> Option<Arc<TcpStream>> {
    if self.is_stopping() {
        return None;
    }
    let home = home_stripe();
    if let Some(socket) =
        self.stripe(home).and_then(|stripe| lock(&stripe.sockets).pop())
    {
        return Some(socket);
    }
    (1..STRIPES).find_map(|offset| {
        let stripe = self.stripe((home + offset) % STRIPES)?;
        try_lock(&stripe.sockets)?.pop()
    })
}
池中的套接字可能在空闲时已被源站关闭。代理通过两种方式之一发现这一点:写入失败,或者在第一个响应字节之前遇到流结束。两种情况下都还没有任何内容到达客户端,因此代理关闭该套接字,并在一个全新的连接上重试一次,而绝不在另一个池中套接字上重试:经过一段空闲期之后,池中的每个套接字都可能已经失效,而这个重试的第一个版本取的是第二个池中套接字,结果在每段安静期之后都对第一个请求回答 502。只有对请求体已被完整缓冲的安全方法(GET、HEAD、OPTIONS)才允许重试。没有收到回复并不能证明源站没有提交一次修改,而分段中继的请求体也无法再次发送;这两种情况下,客户端都会收到 502。
let safe = matches!(request.method, Method::Get | Method::Head | Method::Options);
let buffered = exchange.upload.is_buffered(request.body.len());
let retryable = safe && buffered;
for attempt in 0..2 {
    // 重试总是新建连接:空闲一段时间之后,池中的每个套接字
    // 都可能已经失效,而再取到一个失效的套接字就会让请求失败。
    let pooled = if attempt == 0 { pool.take() } else { None };
    // ... 池中没有连接时新建连接,挂接到活动跟踪,然后交换
    match outcome {
        Ok(relayed) => {
            if relayed.origin_reusable {
                pool.give(origin);
            }
            return Ok(relayed.client_keep && buffered);
        }
        Err(error) => {
            drop(origin);
            let stale = was_pooled
                && retryable
                && matches!(
                    error,
                    ProxyError::UpstreamClosed | ProxyError::UpstreamWriteFailed
                );
            // ... 其他错误立即报告
        }
    }
}
单元测试让固定的字节串通过同样的函数中继,并断言除连接头之外输出逐字节相同(crates/net/src/relay/tests.rs)。守护进程的一个端到端测试在同一个客户端套接字上发送两个被代理的请求,并通过桩源站添加的序号头检查第二个请求复用了池中的源站连接。crates/net/tests/ 中的一个向量测试重放录制的代理场景(一个原始的客户端请求和一个预制的源站响应),并比较源站和客户端收到的每个字节。
空闲期限
每个客户端连接都把它的套接字登记到一个 IdleTable(crates/net/src/idle.rs)中,并获得一个 Lease。租约的 Activity 保存连接上最后一次有字节传输的时间。守护进程在服务完每个请求后更新它;代理在每次读取源站以及每上传 16 KiB 时更新它,并附上正在进行的交换所用的源站套接字。回收线程每隔最短超时的四分之一(介于 200 ms 和一秒之间)醒来一次,关闭所有静默时间超过其超时的连接以及附带的源站套接字,使阻塞在任一端的线程看到流结束并释放它的槽。
因此,期限衡量的是静默时间,而不是响应的长度:一个持续传输的大型下载永远不会被切断。上传字节来自不可信的一方,只有每 16 KiB 才刷新一次时间戳,这要求客户端在每个空闲期内至少发送 16 KiB,即最低速率请求超时所提供的慢速请求体防御。
这张表每个槽有一把小锁,没有全表锁。出于上面给出的原因,它保存每个客户端套接字的一个 try_clone,以及每个附带源站套接字的一个 Arc。Lease 在 Drop 中注销它的连接,被回收的槽在此之前一直归该租约所有,因此旧连接永远不会释放一个已被新连接占用的槽。
升级后的连接
在一个经过验证的 101 之后,WebSocket 升级连接会被双向中继。每个方向在自己的线程上运行,使用一个固定的缓冲区:连接自己的线程传输从源站到客户端的字节,一个拥有 128 KiB 栈的作用域线程传输从客户端到源站的字节。一个线程可以借助 poll(2) 同时服务两个方向,但 Rust 标准库没有提供它;使用两个带套接字超时的线程可以让中继不含 unsafe。因此,一个升级后的连接占用两个线程,当所有连接都被升级时,连接线程的数量可以达到 --max-connections 的两倍。
两个方向共享一个空闲期限(--websocket-idle-timeout,默认 300 秒):任一方向的字节传输都会刷新同一个时间戳。每次套接字等待都带有一个等于剩余时间的超时;超时的等待会重新读取共享时间戳,然后要么继续等待剩余时间,要么结束中继。当一个方向到达流结束时,另一个套接字的发送端被关闭(半关闭);当一个方向失败时,两个套接字都被关闭,使另一个方向也随之结束。在代理一次升级之前,连接会释放它缓存的策略引擎,使一个可能存活数小时的连接不会让旧引擎一直存活。
停止
Running::stop,以及同样作用的 Running 的 Drop,按固定顺序停止守护进程。它设置停止标志,通过连接监听器唤醒每个接受 worker,join 这些 worker,关闭每个已登记的客户端套接字及其附带的源站套接字(IdleTable::shutdown),停止源站连接池,join 每个连接线程,join 回收线程,最后关闭池中的套接字。
SIGINT 和 SIGTERM 通过普通的 Rust 代码进入这一流程。在创建任何线程之前,守护进程先屏蔽这两个信号(之后的每个线程都会继承这个掩码),并专门用一个线程执行 sigwait,它记录停止请求并立即唤醒主线程。没有任何代码在信号处理函数中运行,也没有线程轮询标志。信号模块(cmd/sibuna/src/signals.rs)包含守护进程中唯一的 unsafe 代码:即 std 没有封装的少数几个 C 库函数的声明。
我们测得了什么
下表给出 Shield 在一台 Ryzen 9 5950X 上以反向代理模式运行的结果:守护进程绑定到四个 CPU,wrk 以两个线程和 64 个连接运行在另外八个 CPU 上,每次运行五秒,取三次的中位数。各行抄自 benchmarks/results/product-latest.md;完整记录见第 VIII 部分。
| 工作负载 | 状态码 | req/s | p50 / p99 (us) | 每请求 CPU 时间 (us) |
|---|---|---|---|---|
| 带会话准入,经代理 | 200 | 138,965 | 438 / 857 | 28.57 |
| 被挑战(验证中间页) | 200 | 195,188 | 162 / 328 | 13.73 |
| 静态资源放行,经代理 | 200 | 145,673 | 415 / 746 | 27.27 |
| 被 WAF 拒绝(带会话) | 403 | 209,507 | 151 / 306 | 12.17 |
wrk 始终保持 64 个请求在途,因此在受 CPU 限制的代理路径上,请求会排队等待四个 CPU,那里的 p99 反映的是调度器的尾部,而不是单个请求的成本。开环生成器以固定速率发送,并从每个请求的预定发送时刻开始计时,它测量的是相同施加负载下的延迟。对于反向代理模式下被准入的请求,每秒 10,000 个请求时 p99 为 65 us,每秒 100,000 个请求时为 100 us;施加每秒 150,000 个请求时,四个 CPU 达到饱和,实际完成每秒 134,344 个请求,队列增长到秒级(benchmarks/results/latency-latest.md)。一个预热过的 keep-alive 连接在处理每个决策时都没有堆分配:cmd/sibuna/tests/steady_state.rs 统计守护进程的分配次数,crates/net/tests/steady_state.rs 在 500 个经代理的 keep-alive 请求中没有发现任何分配。
无分配的并发状态
sibuna-store 中的每个存储都在构建时一次性分配其固定容量,之后从不分配内存,也从不阻塞在全局锁上。它们都不需要后台清扫线程:过期状态在原地回收。
锁与分片
Sibuna 各张表中的临界区只有几十条指令,远短于一次内核 futex 往返。表按键的哈希分成 16 个分片,因此两个操作发生争用的概率为 \(1/16\);每个分片独占一条缓存行,因此相邻的锁不会发生伪共享。
这些表使用 std::sync::Mutex:无争用时一次比较并交换,持有者运行期间短暂自旋,然后进入 futex 等待。另一种选择是双状态的原子自旋锁,在等待循环中使用自旋提示。SID 0010 要求我们通过测量在两者之间作出选择。自旋锁在每次无争用的操作上大约节省一纳秒,但在争用下会落败:
| 工作负载 | Mutex |
自旋锁 |
|---|---|---|
| 已用集合,16 个线程 | 10.8 M/s | 8.6 M/s |
| 已用集合,64 个线程(多于 CPU 数) | 11.2 M/s | 6.9 M/s |
| 在六个热点地址上运行 GCRA,16 个线程 | 44.9 M/s | 19.3 M/s |
| 在六个热点地址上运行 GCRA,64 个线程 | 37.4 M/s | 6.5 M/s |
边缘服务器运行的连接线程多于 CPU 数,而持有者被抢占的自旋锁会让每个等待者白白耗尽自己的时间片,因此我们保留互斥锁。中毒的锁会被直接进入,而不是传播错误:没有任何操作会在持有分片时 panic,即使发生了,分片在结构上也仍然有效。
Robin Hood 已用集合
只有被接受的证明才会进入已用集合(第 III 部分)。它有 16 个分片,每个分片是一个开放寻址数组,包含 4,096 个 Option<Entry> 槽,其中条目为 { tag: [u8; 16], expires_at: u64, dist: u8 }。Robin Hood 插入(Celis,1986)会挤走任何比新来的键更靠近自己初始位置的占用者,从而使探测长度紧密集中;查找一旦遇到一个比自己更靠近其初始位置的条目,就会停止。
fn insert(
    &mut self,
    tag: &Tag,
    expires_at: u64,
    now: u64,
) -> Result<(), SpendError> {
    if !self.can_insert(tag, now) {
        return Err(SpendError::Full);
    }
    let mut carry = Entry { tag: *tag, expires_at, dist: 0 };
    let mut idx = Self::home(tag);
    while carry.dist < MAX_PROBE {
        let slot = &mut self.entries[idx];
        let Some(e) = slot else {
            *slot = Some(carry);
            return Ok(());
        };
        // 只有当新的探测距离不更小时,覆盖已过期的占用者才是安全的,
        // 这样,探测越过此槽的键仍能通过
        // 提前终止检查。
        if e.is_expired(now) && carry.dist >= e.dist {
            *e = carry;
            return Ok(());
        }
        if carry.dist > e.dist {
            std::mem::swap(&mut carry, e);
            // 被挤出的过期条目直接丢弃。
            if carry.is_expired(now) {
                return Ok(());
            }
        }
        idx = (idx + 1) % SHARD_CAPACITY;
        carry.dist += 1;
    }
    Err(SpendError::Full)
}
过期槽的规则是其中微妙的部分:只有距离自己初始位置至少同样远的键,才能原地覆盖一个过期条目,否则一个探测会越过该槽的后来键将提前停止并丢失。被挤走的过期条目直接丢弃。不需要清扫线程。插入时先在不改变任何内容的情况下模拟挤占路径(can_insert),确认有界的挤占可以成功且不会丢失任何存活的标签。
一个槽是 Option<Entry>。空槽中没有可读的标签,因此不存在读者可能忘记检查的 occupied 标志,而且在两种情况都被处理之前,match 无法通过编译。错误类型同样精确:已用集合有两种失败方式(DoubleSpend 和 Full),SpendError 恰好列出这两种。
GCRA:用一个整数实现速率限制
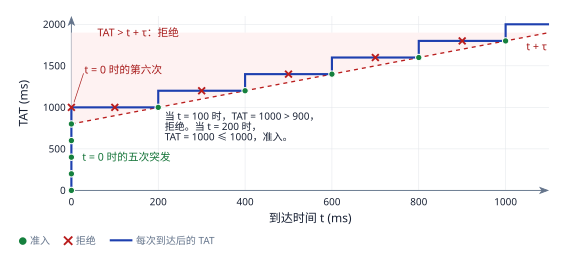
通用信元速率算法(ATM Forum,1996)是漏桶算法的虚拟调度形式。它为每个客户端保存一个 理论到达时间(TAT)。对于每个窗口 \(W\) 内的正限额 \(N\),发射间隔为 \(T = \max(1, \lceil W / N \rceil)\),突发容限为 \(\tau = (N - 1) T\):
fn arrive(
    cells: &mut [Cell; SLOTS_PER_SHARD],
    key: u64,
    now_ms: u64,
    limits: Limits,
) -> Decision {
    let interval = limits.emission_interval();
    let tau = limits.burst_tolerance();
    let Some(cell) = locate(cells, key, now_ms, tau) else {
        return Decision {
            limited: true,
            capacity_exhausted: true,
            retry_after_ms: interval,
            remaining: 0,
        };
    };
    let tat = cell.tat_ms.max(now_ms);
    let horizon = now_ms.saturating_add(tau);
    if tat > horizon {
        return Decision {
            limited: true,
            capacity_exhausted: false,
            retry_after_ms: tat - tau - now_ms,
            remaining: 0,
        };
    }
    cell.tat_ms = tat.saturating_add(interval);
    // ... remaining = min(rate, floor((t + tau - TAT) / T) + 1)
}
分片的 check 获取锁,并用已加锁的单元调用 arrive;check 返回时,守卫释放锁。单元为 16 字节(一个键和一个 TAT),分布在 16 个分片中,每个分片 512 个槽,探测窗口为 16 个槽,总计约 128 KiB。TAT 早于 \(t - \tau\) 的单元已经排空,会被当场回收。Retry-After 响应头由同样的算术计算得出。探测窗口饱和时,会拒绝新客户端,而不是逐出活跃的配额状态,并且决定中会注明这一点(capacity_exhausted),使调用方不会把饱和造成的拒绝升级为封禁。配置的速率为零时拒绝请求。一个限制器可服务多条规则:单元的键是以规则作用域为种子、对客户端地址计算的 Wyhash,因此同一个客户端在不同作用域中拥有相互独立的预算。
带版本号的封禁表
封禁使用 4,096 个槽,每个槽具有原子的版本、键和过期时间字段,按被封禁地址的带密钥哈希进行开放寻址,探测窗口为 8 个槽。写者通过互斥锁与其他写者串行执行,并在每次更新前后各递增一次版本号;读者不加锁,只接受稳定的偶数版本号,遇到并发修改时重试。
pub fn ban(&self, banned: &[u8], until: u64, now: u64) {
    let key = slot_key(banned);
    let _writers = self.lock_writers();
    let victim = &self.slots[self.victim(key, now)];
    // 键和过期时间是一个逻辑值:替换期间让版本号保持为奇数,
    // 使读者无法把旧键与下一个键的过期时间
    // 拼在一起。
    victim.version.fetch_add(1, Ordering::SeqCst);
    victim.until.store(until, Ordering::SeqCst);
    victim.key.store(key, Ordering::SeqCst);
    victim.version.fetch_add(1, Ordering::SeqCst);
}

fn read_slot(&self, slot: &Slot) -> (u64, u64) {
    loop {
        let before = slot.version.load(Ordering::SeqCst);
        if before & 1 != 0 {
            std::hint::spin_loop();
            continue;
        }
        let key = slot.key.load(Ordering::SeqCst);
        let until = slot.until.load(Ordering::SeqCst);
        if before == slot.version.load(Ordering::SeqCst) {
            return (key, until);
        }
    }
}
顺序一致性防止把旧的身份与替换后的过期时间混在一起:每次访问都属于同一个全序,这使论证保持简单。读者不使用互斥锁,但可能需要等待写者,因此不是无等待的。这些原子操作有实际的成本,这一成本在 HTTP 测量工具中间接测得,而不是假定为零。探测窗口已满时,覆盖一个已过期的槽,否则覆盖最先过期的槽。clear 解除所有封禁,但保留键不动,因为一个被清空的槽可能会让探测链中后面一个发生碰撞的键无法被找到。
MPSC 事件环
当 Shield 形态拒绝一个请求或蜜罐被触发时,事件被复制进一条约 1.3 KB 的固定记录(客户端地址、User-Agent、方法、路径、类别和载荷,各自按容量截断),并推入一个有界的多生产者单消费者环(Vyukov 的带序号设计,512 个槽,BoundedQueue<IncidentRecord, 512>)。生产者是连接线程;消费者是存储线程。环满时丢弃最新的记录,而不是阻塞响应,这是一种明确的丢失策略,而不是持久性保证。丢弃计数器使这种丢失可以被观察到。
/// 把 `incident` 复制进环形缓冲区;缓冲区已满时丢弃它,并为丢弃计数。
pub(crate) fn record(&self, incident: &Incident<'_>) {
    if self.queue.push(IncidentRecord::from_incident(incident)).is_err() {
        self.metrics.incidents_dropped.bump();
    }
}
把一条记录移入待处理批次之后,存储线程会连同准备好的行一起保留它,直到提交得到确认;遇到数据库错误时,它不会悄悄丢弃这条记录,重试时写入的是完全相同的批次。
每个槽带有一个序号,它告诉生产者该槽是否空闲,告诉消费者该槽是否已满,因此双方都不需要加锁。这样的环无法用安全的 Rust 编写:生产者和消费者同时访问同一个数组的不同槽,而证明哪个线程可以访问哪个槽的,只有序号协议,而不是类型系统。因此,模块 crates/store/src/ring.rs 把值存放在 UnsafeCell<MaybeUninit<T>> 槽中,每个 unsafe 块都写明了为其提供依据的协议步骤:
if diff == 0 {
    // Relaxed:CAS 只裁定哪个生产者拥有位置 `pos`。
    match self.tail.0.compare_exchange_weak(
        pos, pos.wrapping_add(1), Ordering::Relaxed, Ordering::Relaxed,
    ) {
        Ok(_) => {
            // SAFETY: CAS 把位置 `pos` 分给了本线程,
            // 而 `sequence == pos` 表明该槽为空;其他生产者无法
            // 占用 `pos`,消费者在下面的 Release 存储之前
            // 也不会读取它。
            unsafe { (*slot.value.get()).write(value) };
            // Release:把写入的值发布给消费者。
            slot.sequence.store(pos.wrapping_add(1), Ordering::Release);
            return Ok(());
        }
        Err(current) => pos = current,
    }
} else if diff < 0 {
    return Err(value);
}
这个环的两个约定是用类型而不是注释表达的。环满时,push 返回 Err(value),把记录交还给调用方,由调用方决定计数还是丢弃;单纯返回 false 会让记录丢失。这个环只有一个消费者,pop 接受 &mut self,共享代码必须先取得唯一的 Consumer,因此第二个消费者要么无法编译,要么在运行时被拒绝。
读-复制-更新式的引擎发布
策略变化时,策略引擎在热路径之外重建。请求绝不能看到构建了一半的引擎,引擎也绝不能在仍有请求读取它时被释放。Sibuna 把每个引擎作为 Arc<Engine> 发布到一个 EngineSlot 中,每个连接通过一个 EngineCache 读取它:
pub struct EngineSlot {
    current: RwLock<Arc<Engine>>,
    generation: AtomicU64,
}

pub fn publish(&self, engine: Engine) {
    let fresh = Arc::new(engine);
    let previous = {
        let mut current =
            self.current.write().unwrap_or_else(PoisonError::into_inner);
        std::mem::replace(&mut *current, fresh)
    };
    self.generation.fetch_add(1, Ordering::Release);
    // 旧引擎在锁外释放(如果这里是它的最后一个持有者)。
    drop(previous);
}

pub struct EngineCache {
    generation: u64,
    engine: Option<Arc<Engine>>,
}

pub fn refresh(&mut self, slot: &EngineSlot) -> &Engine {
    let generation = slot.generation();
    if self.generation != generation {
        // 若在上面的加载与这次克隆之间发生一次发布,较新的引擎会被
        // 标上较旧的代次;下一次刷新会再次加载,问题随之消失。
        self.generation = generation;
        self.engine = None;
    }
    self.engine.get_or_insert_with(|| slot.load())
}
代次在引擎就位之后以 release 顺序存储,并以 acquire 顺序加载:看到新代次的读者也能看到在它之前存入的引擎。注释中提到的竞争是良性的。如果一次发布恰好发生在读者加载代次和克隆之间,读者会把较新的引擎缓存在较旧的代次下,下一次刷新时会发现不匹配并重新加载。读者可能在一个请求中晚一个引擎;但它永远看不到构建了一半的引擎,因为存入槽中的只有完整的引擎。
为什么用缓存,而不简单地用锁?SID 0010 要求我们测量 16 个线程下的读取成本,并在 RwLock<Arc<Engine>> 和安全 Rust 中的一种无锁方案之间作出选择。通过锁读取要访问锁字和引用计数,这两条缓存行每个核心都会写入。相比之下,代次每次发布只写一次,其余时间只被读取,因此每个核心都能保留自己的副本:
| 读取方式 | 1 个线程 | 16 个线程 |
|---|---|---|
仅 RwLock 读守卫 |
4.2 ns | 752 ns |
RwLock 读取加 Arc 克隆 |
7.6 ns | 833 ns |
用缓存的 Arc 检查代次 |
0.8 ns | 1.8 ns |
在争用下,缓存读取比锁便宜 400 多倍,因此请求路径使用缓存,只在刷新的慢路径上使用 RwLock。这项测量是 cmd/sibuna/src/slot.rs 中被标记为忽略的测试 read_cost_under_contention。请求路径上的每次使用都会刷新,因此请求在每一步看到的都是当时的引擎。引擎本身很小:209,052 字节,约 204 KiB 的紧凑堆表(benchmarks/results/primitives-latest.json 中的 engine_bytes),可容纳 128 条规则、128 字节的规则名称和 8,192 个字典树节点。