भाग VIII: प्रायोगिक मूल्यांकन
हम कमिट किए गए हार्नेस द्वारा दर्ज Sibuna के मापन प्रस्तुत करते हैं: प्रिमिटिव लेटेंसी, बाहरी लोड जनरेटर के तहत CPU और मेमोरी के हिसाब के साथ पूरे उत्पाद, open-loop जनरेटर से समान प्रस्तावित लोड पर लेटेंसी, और व्यापक रूप से उपयोग होने वाले proof-of-work गेट Anubis से तुलना। आठ लाइव डैशबोर्ड वाला एक कंसोल रन रिकॉर्ड को पूरा करता है। इस भाग की हर संख्या किसी कमिट की गई परिणाम फ़ाइल से आती है, जिसका नाम हर तालिका उसके बनने के समय के साथ देती है, या किसी डिज़ाइन रिकॉर्ड से। कार्यात्मक रूप से पास होना और प्रदर्शन का मापन अलग-अलग प्रश्नों के उत्तर देते हैं, और एक होस्ट पर किया गया मापन दूसरे होस्ट पर रैंकिंग नहीं है।
कार्यप्रणाली
हार्नेस एक Rust टूल tools/bench (बाइनरी sibuna-bench) की कमांड हैं, जो cargo xtask bench के ज़रिए चलती हैं। एक और टूल कंसोल रन दर्ज करता है।
| हार्नेस | यह क्या मापता है | परिणाम फ़ाइल |
|---|---|---|
cargo xtask bench primitives |
एक CPU पर सोलह प्रिमिटिव वर्कलोड, साथ में हैश किए गए रेट लिमिटर पाथ की दो पंक्तियाँ: सात बैच, min-max फैलाव के साथ प्रति ऑपरेशन माध्यिका | primitives-latest.json, primitives-latest.md |
cargo xtask bench product |
wrk के तहत पूरे डेमन: forward-auth और रिवर्स-प्रॉक्सी मोड में Gate और Shield के लिए थ्रूपुट, लेटेंसी पर्सेंटाइल, प्रति अनुरोध CPU समय और पीक resident मेमोरी |
product-latest.json, product-latest.md |
cargo xtask bench latency |
open-loop जनरेटर से, निश्चित प्रस्तावित दरों पर स्वीकृत अनुरोधों के लेटेंसी पर्सेंटाइल | latency-latest.json, latency-latest.md |
cargo xtask bench product --anubis |
एक और उत्पाद के रूप में Anubis के साथ पूरे उत्पाद के वर्कलोड, caddy respond के पीछे |
comparison-latest.json, comparison-latest.md |
cargo xtask bench admission --anubis |
दो keep-alive क्लाइंट से, forward-auth मोड में Sibuna और Anubis के प्रति सेकंड प्रवेश ऑपरेशन | admission-latest.json, admission-latest.md |
sibuna-browser dashboards (tools/browser) |
एक कार्यात्मक कंसोल रन: headless Chromium में आठ लाइव डैशबोर्ड, जबकि एक जनरेटर ट्रैफ़िक भेजता है | console-8-dashboards-2026-10-15.md |
.md फ़ाइलें सारांश हैं। .json फ़ाइलें हर दोहराव, मशीन, revision, और मापी गई हर बाइनरी का पाथ, आकार और SHA-256 रखती हैं। Git इतिहास रखता है, इसलिए डायरेक्टरी केवल सबसे नई फ़ाइलें रखती है। कुछ फ़ाइलें हार्नेस के पुराने संस्करण ने दर्ज की थीं और उनमें उसी रन में मापे गए एक दूसरे डेमन बिल्ड की पंक्तियाँ भी हैं; यह भाग Sibuna की पंक्तियाँ रिपोर्ट करता है।
प्रिमिटिव
हर वर्कलोड अधिकतम 1,000 ऑपरेशन के बिना समय-माप वाले warm-up के बाद सात समय-मापित बैच में चलता है। परिवर्तनशील अवस्था (spent set, रेट लिमिटर) हर बैच से पहले, टाइमर के बाहर, दोबारा बनाई जाती है। टाइमर पूरे बैच को घेरते हैं, कभी अकेले ऑपरेशन को नहीं: प्रति ऑपरेशन घड़ी पढ़ने की लागत उतनी ही होती जितना 100 ns से कम का वह कार्य जिसे वह मापता है। इसलिए प्रति-ऑपरेशन पर्सेंटाइल रिपोर्ट नहीं किए जाते, और फैलाव बैचों के बीच का है। हम प्रति ऑपरेशन माध्यिका बैच रिपोर्ट करते हैं, उसके साथ सबसे तेज़ और सबसे धीमा बैच।
सूट एक CPU पर पिन की गई एक चाइल्ड प्रोसेस (sibuna-bench primitives-run) में चलता है। साझा होस्ट पर व्यस्त SMT sibling या कम क्लॉक पूरे सूट रन को धीमा कर देता है, इसलिए टूल सूट को तीन बार (--rounds) चलाता है और हर पंक्ति के लिए सबसे कम माध्यिका वाला राउंड रखता है। एक राउंड के भीतर आँकड़े ऊपर जैसे ही हैं।
पूरे उत्पाद
हर मोड (forward auth, रिवर्स प्रॉक्सी) और हर सतह (Gate, Shield) के लिए हार्नेस डेमन को मेमोरी में --algorithm hashcash --difficulty 8 --rate-limit 100000000 --idle-timeout 5 और चार वर्कर के साथ शुरू करता है, उसके समुच्चय के प्रति CPU एक। यह sibuna-pow से डेमन का Hashcash चैलेंज हल करके एक सत्र प्राप्त करता है, जैसे कोई ब्राउज़र करता। फिर यह keep-alive कनेक्शनों पर wrk से चार वर्कलोड चलाता है: 2 थ्रेड, 64 कनेक्शन, 5 सेकंड, 3 दोहराव।
admitted: वैध सत्र कुकी के साथGET /private। रिवर्स-प्रॉक्सी मोड में अनुरोध ऑरिजिन तक पहुँचता है और उसका उत्तर रिले होता है; forward-auth मोड में डेमन स्वयं200उत्तर देता है।challenged: वही अनुरोध बिना कुकी के, ब्राउज़र User-Agent से। डेमन अपना चैलेंज देता है: रिवर्स-प्रॉक्सी मोड में HTML के साथ200, forward-auth मोड में401।allowed_static:curl/8.0सेGET /robots.txt, जिसे दोनों सतहें बिना चैलेंज के प्रवेश देती हैं।attack: वैध सत्र और साथ मेंq=' OR 1=1--। केवल Shield इसे अस्वीकार करता है (403)। Gate इसे प्रवेश देता है, और रिवर्स-प्रॉक्सी मोड में इसे ऑरिजिन तक रिले करता है।
ऑरिजिन एक स्टब (sibuna-bench origin) है: केवल standard library, प्रति कनेक्शन एक थ्रेड, keep-alive, और 41-बाइट का पेज। प्रति अनुरोध CPU समय पूरे रन में /proc/<pid>/stat से डेमन का user और system समय (10 ms tick) है, जिसे wrk द्वारा गिने गए अनुरोधों से भाग दिया जाता है; ऑरिजिन का CPU शामिल नहीं है। पीक मेमोरी /proc/<pid>/status से VmHWM है, जिसे हर रन से पहले /proc/<pid>/clear_refs के ज़रिए reset किया जाता है, ताकि हर रन अपना पीक रिपोर्ट करे। हर आँकड़ा दोहरावों की माध्यिका है, और न्यूनतम तथा अधिकतम उसके साथ JSON फ़ाइल में रखे जाते हैं।
wrk एक closed-loop जनरेटर है: यह 64 अनुरोध एक साथ चलते रखता है। इसलिए तेज़ डेमन को अधिक अनुरोध मिलते हैं, और wrk के पर्सेंटाइल उन अनुरोधों को छोड़ देते हैं जो उसने धीमे उत्तर की प्रतीक्षा करते समय नहीं भेजे (coordinated omission)। इसका p99 दिखाता है कि डेमन अपनी संतृप्ति में कैसा व्यवहार करता है, किसी दिए गए लोड पर उसकी लेटेंसी नहीं। लेटेंसी हार्नेस उस प्रश्न का उत्तर देता है।
समान लोड पर लेटेंसी
open-loop जनरेटर (sibuna-bench generate) प्रति कनेक्शन एक blocking थ्रेड चलाता है। 64 कनेक्शनों में से हर एक एक निश्चित समय-सारणी पर सत्र के साथ GET /private भेजता है: किसी कनेक्शन का अनुरोध \(k\) समय \(t_0 + o + kT\) पर देय है, जहाँ \(o\) कनेक्शन का offset है और \(T\) उसका अंतराल, पहले के उत्तरों से स्वतंत्र। जब कोई उत्तर अगले अनुरोध के देय होने के बाद आता है, तो वह अनुरोध तुरंत भेजा जाता है और उसकी लेटेंसी उसके देय समय से गिनी जाती है, जैसे wrk2 में। जब देय समय पर कनेक्शन निष्क्रिय था, तो लेटेंसी वास्तविक भेजने के समय से गिनी जाती है, ताकि जनरेटर की अपनी sleep की देरी डेमन के खाते में न जाए।
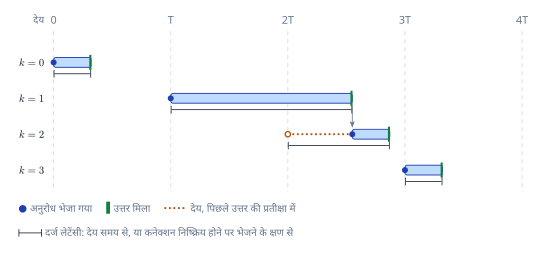
हार्नेस Shield सतह और स्वीकृत वर्कलोड को पाँच प्रस्तावित दरों पर चलाता है: प्रति सेकंड 10,000, 25,000, 50,000, 100,000 और 150,000 अनुरोध, हर एक 2-सेकंड warm-up, 10 मापे गए सेकंड और 3 रन के साथ। हार्नेस एक रन में दो डेमन बिल्ड माप सकता है: तब वह दोनों को एक ही CPU समुच्चय पर शुरू करता है और हर दर और दोहराव पर उनके बीच बारी-बारी करता है, निष्क्रिय वाला कोई CPU उपयोग नहीं करता, ताकि मशीन का धीमा विचलन दोनों को समान रूप से प्रभावित करे। दर्ज रन ने ऐसा ही किया। पर्सेंटाइल एक रन के हर मापे गए अनुरोध पर nearest-rank हैं; हर आँकड़ा तीन रन की माध्यिका है, और उसके साथ p99 का min-max।
CPU समुच्चय
CPU समुच्चय किसी भी अन्य सेटिंग से अधिक मायने रखते हैं। डेमन CPU 0 से 3 पर चलते हैं (--cpus; --workers उस समुच्चय का आकार है)। wrk, लेटेंसी जनरेटर और ऑरिजिन CPU 8 से 15 पर चलते हैं (--load-cpus)। प्रिमिटिव सूट CPU 4 पर चलता है (--cpu)। हर प्रोसेस शुरू होने से पहले taskset -c से पिन की जाती है, इसलिए वह जो भी थ्रेड बनाती है वह समुच्चय विरासत में पाता है। प्रवेश हार्नेस उत्पाद के लिए दो CPU, 0 और 1, और अपने क्लाइंट के लिए CPU 8 से 15 उपयोग करता है।
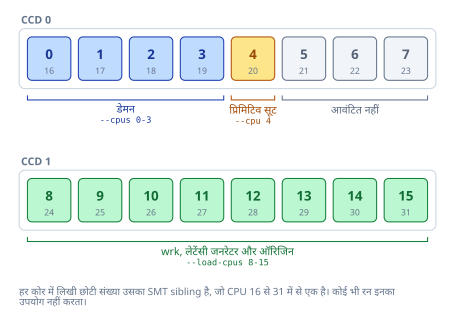
दूसरी मशीनों पर हम ऐसे समुच्चय चुनते हैं जो कोर साझा न करें (lscpu -e टोपोलॉजी दिखाता है)।
मशीन और परिस्थितियाँ
फ़ाइलें paxos-zig पर दर्ज की गईं: एक AMD Ryzen 9 5950X 16-Core Processor (32 लॉजिकल CPU), Linux 7.0.0-28-generic x86_64, boost सक्षम के साथ powersave governor, rustc 1.99.0। प्रिमिटिव, उत्पाद और लेटेंसी फ़ाइलें 15 अक्टूबर 2026 को दर्ज की गईं, और Anubis के साथ तुलना 16 अक्टूबर 2026 को। डेमन cargo build --release -p sibuna है, SQLite स्टोरेज और कंसोल के साथ कंपाइल हुआ डिफ़ॉल्ट बिल्ड (SID 0010); उत्पाद और लेटेंसी फ़ाइलें 49,113,856 बाइट की बाइनरी का नाम देती हैं। हर फ़ाइल अपना revision (प्रिमिटिव के लिए efce14d, उत्पाद और लेटेंसी रन के लिए 249d913) dirty: true के साथ दर्ज करती है; दूसरे वाले के working tree में पहले से वे दोबारा उपयोग होने वाले कनेक्शन थ्रेड थे जिन्हें SID 0002 दर्ज करता है, और SID 0002 उनके प्रभाव के लिए latency-latest.md का हवाला देता है। तुलना और प्रवेश फ़ाइलें dirty: true के साथ revision 54e4ec5 का नाम देती हैं, क्योंकि working tree में tools/bench में हार्नेस के जोड़ थे; उनका डेमन उसी revision का रिलीज़ बिल्ड है (37,450,232 बाइट)। उनके एक-मिनट load average तुलना रन से पहले 3.53 और प्रवेश रन समाप्त होने पर 0.56 थे।
फ़ाइलें प्रिमिटिव रन पर 2.46, लेटेंसी रन से पहले 1.30 और बाद में 52.31, और उत्पाद रन से पहले 52.31 और बाद में 33.39 के एक-मिनट load average दर्ज करती हैं। ऊँचे आँकड़े लेटेंसी जनरेटर के 64 थ्रेड हैं, जिसके तुरंत बाद उत्पाद रन चला।
दोबारा कैसे उत्पन्न करें
हमें Linux, taskset (util-linux) और PATH पर wrk चाहिए।
cargo xtask bench primitives
cargo xtask bench product
cargo xtask bench latency
cargo xtask bench help
cargo xtask bench पहले cargo build --release -p sibuna से डेमन बनाता है, फिर sibuna-bench को रिलीज़ मोड में चलाता है। टूल डेमन को अपनी बाइनरी के पास पाता है; --rust <path> इसे बदलता है। cargo xtask bench help विकल्पों की सूची देता है, जिनमें --cpus, --load-cpus, --cpu, --rounds, --repetitions, --seconds, --rates और --warmup हैं। नीचे Anubis वाला अनुभाग वे कमांड देता है जिनसे वह तुलना दर्ज हुई।
प्रिमिटिव लेटेंसी
तालिका प्रिमिटिव रन की हर पंक्ति देती है। JSON फ़ाइल हर पंक्ति को सबसिस्टम और वर्कलोड से नाम देती है (उदाहरण के लिए pow_verify और hashcash_16_bits)।
| वर्कलोड | ns/op | min-max |
|---|---|---|
| Hashcash सत्यापन (16 बिट) | 70.2 | 69.9-71.0 |
| PoSW सत्यापन (गहराई 13, t = 16) | 22272.4 | 22257.0-22316.4 |
| बॉट सिग्नेचर (40, Aho-Corasick) | 55.7 | 55.3-57.2 |
| बॉट सिग्नेचर (40, अनुक्रमिक खोज) | 763.0 | 762.2-763.5 |
| IPv4 CIDR लुकअप | 32.0 | 31.8-32.2 |
| IPv6 CIDR लुकअप | 79.3 | 78.5-79.6 |
| सत्र टोकन (कुंजी-युक्त BLAKE3) | 155.8 | 155.3-156.4 |
| सत्र टोकन (Ed25519) | 40587.5 | 40544.6-40631.1 |
| spent set (Robin Hood), खर्च और लुकअप | 21.0 | 20.8-21.3 |
| रेट लिमिटर (GCRA), क्लाइंट बाइट | 12.8 | 12.7-12.8 |
| रेट लिमिटर, चार नियम scope, क्लाइंट बाइट | 13.1 | 13.0-13.2 |
| रेट लिमिटर (GCRA), हैश किया गया क्लाइंट | 6.2 | 6.1-6.3 |
| रेट लिमिटर, चार नियम scope, हैश किया गया क्लाइंट | 6.3 | 6.2-6.4 |
| HTTP पार्स और कुकी | 132.5 | 132.3-133.2 |
| वर्गीकरण, Shield प्रोफ़ाइल | 790.8 | 787.2-793.1 |
| वर्गीकरण, Gate प्रोफ़ाइल | 75.9 | 75.6-76.1 |
| WAF बॉडी स्कैन (8 KiB) | 12784.3 | 12771.5-12809.2 |
| WAF बॉडी स्कैन (8 KiB), SQL injection ऑडिट मोड में | 15485.4 | 15460.9-15530.1 |
फैलाव संकरे हैं: किसी भी पंक्ति का कोई बैच अपनी पंक्ति की माध्यिका से 2.8% से अधिक दूर नहीं है। चित्र यही पंक्तियाँ लघुगणकीय पैमाने पर दिखाता है, जिससे 6 ns और 40 us की पंक्तियाँ साथ-साथ पढ़ने योग्य रहती हैं।
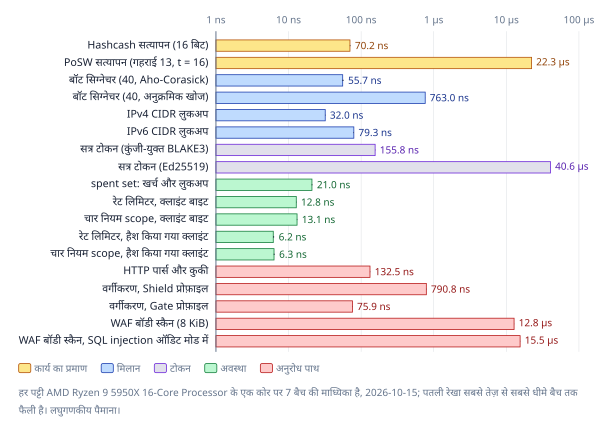
benchmarks/results/primitives-latest.json से बनाए गए।¶Proof-of-work सत्यापन
Hashcash सत्यापन एक चैलेंज, एक separator और एक दशमलव नॉनस का हैश करता है: 70.2 ns। अनुक्रमिक कार्य का सत्यापनकर्ता ग्राफ़ की ओपनिंग जाँचता है: 22,272.4 ns। इसके हैश कॉल और SHA-256 compression की गिनती Hashcash से अलग है, क्योंकि इनपुट की लंबाई अलग है। दोनों पंक्तियाँ SHA-256 से बँधी हैं, और sibuna-crypto CPU में उपलब्ध होने पर SHA-NI निर्देशों का उपयोग करता है, जिनका पता रन टाइम पर लगता है (SID 0010)।
मिलान
सघन Aho-Corasick ऑटोमेटन और अनुक्रमिक सबस्ट्रिंग खोज एक जैसे पैटर्न और any-match अर्थ (semantics) का उपयोग करते हैं। उन्हीं 40 सिग्नेचर पर ऑटोमेटन अनुक्रमिक खोज से 13.7 गुना तेज़ है (55.7 बनाम 763.0 ns)। इसकी टेबल प्रति अवस्था 256 कॉलम के बजाय byte class का उपयोग करती हैं (SID 0006, Part F), जिससे बॉट सिग्नेचर टेबल 42,244 बाइट पर रहती है (नीचे की footprint तालिका)। CIDR वर्गीकारक 32.0 ns (IPv4) और 79.3 ns (IPv6) लेते हैं।
टोकन
BLAKE3 MAC टोकन का सत्यापन 155.8 ns में होता है। sibuna-crypto BLAKE3 को पोर्टेबल रूप में, बिना SIMD पाथ के, लागू करता है; SIMD पाथ बड़े इनपुट पर जीतते हैं, लेकिन Sibuna BLAKE3 से 100 बाइट से छोटे इनपुट का हैश करता है, जहाँ पोर्टेबल कोड तेज़ है। Ed25519 compact टोकन का सत्यापन 40,587.5 ns में होता है: सत्यापनकर्ता width-5 और width-8 NAF अंकों का उपयोग करता है और डिकोड की गई सार्वजनिक कुंजी रखता है। एक Ed25519 सत्यापन की लागत लगभग 260 MAC सत्यापनों के बराबर है; MAC Sibuna की डिफ़ॉल्ट टोकन योजना है।
अवस्था
spent-set पंक्ति एक नया टैग डालती है और उसे फिर से खोजती है: 21.0 ns। इस पंक्ति की टेबल में 4,096 स्लॉट के 16 शार्ड हैं (65,536 टैग; डेमन का डिफ़ॉल्ट 1,048,576 है), और इसे हर बैच से पहले, टाइमर के बाहर, उसी स्थान पर खाली किया जाता है। इसलिए हर बैच resident मेमोरी को probe करता है। सूट का एक पुराना संस्करण हर बैच के लिए डेमन के डिफ़ॉल्ट आकार की एक नई शून्य की गई टेबल बनाता था; वह पहले राइट पर टेबल के पेज को कर्नेल द्वारा मैप करने का समय मापता था, एक ऐसी लागत जो चलता हुआ डेमन एक बार चुकाता है, और वह पंक्ति हम रिपोर्ट नहीं करते।
रेट लिमिटर की पंक्तियों को सावधानी चाहिए। क्लाइंट बाइट वाली दो पंक्तियाँ (gcra_check और gcra_four_rule_scopes) byte API को कॉल करती हैं: हर जाँच क्लाइंट का पता बाइट के रूप में लेती है और पहले ऑपरेटिंग सिस्टम की यादृच्छिकता से लिए गए एक सीक्रेट के तहत उसका कुंजी-युक्त SipHash-1-3 निकालती है। सीक्रेट कुंजी किसी को भी ऐसे पते निकालने से रोकती है जो किसी पीड़ित की probe विंडो साझा करें (SID 0010 और sibuna-store का दस्तावेज़ीकरण)। ये पंक्तियाँ 12.8 और 13.1 ns लेती हैं।
डेमन अनुरोध पाथ पर byte API का उपयोग नहीं करता। यह प्रति अनुरोध क्लाइंट का एक बार हैश करता है (ClientHasher) और वह हैश हर उस टेबल को देता है जिससे वह परामर्श करता है। हैश किए गए क्लाइंट वाली दो पंक्तियाँ (gcra_check_hashed और gcra_four_rule_scopes_hashed) उसी पाथ को मापती हैं, हैश लूप से पहले निकालकर: प्रति जाँच 6.2 और 6.3 ns। byte और hashed पंक्तियों की माध्यिकाओं के बीच का अंतर, 6.6 ns, इन इनपुट पर कुंजी-युक्त हैश की लगभग कीमत है, जिसे डेमन प्रति टेबल नहीं, प्रति अनुरोध एक बार चुकाता है।
HTTP पार्सर
पार्सर पंक्ति 400-बाइट के ब्राउज़र अनुरोध को पार्स करती है और एक कुकी खोजती है: 132.5 ns। क्रेट का अपना समय-परीक्षण इससे सहमत है (crates/http: उसी मशीन पर लगभग 135 से 180 ns)। पार्सर zero-copy है; हर फ़ील्ड कनेक्शन के बफ़र की एक स्लाइस है।
नीति इंजन
ब्राउज़र अनुरोध का पूरा वर्गीकरण 790.8 ns लेता है और Gate प्रोफ़ाइल 75.9 ns। ये पंक्तियाँ अनुरोध के पार्स किए गए क्लाइंट पते को खाली छोड़ती हैं, इसलिए इंजन मूल्यांकन के भीतर क्लाइंट पते के टेक्स्ट को पार्स करता है। डेमन पते को प्रति अनुरोध एक बार, मूल्यांकन से पहले, पार्स करता है, इसलिए इन पंक्तियों में एक छोटी लागत शामिल है जिसे डेमन इंजन के बाहर चुकाता है। इंजन की हीप टेबल कुल 209,052 बाइट हैं (SID 0002)।
WAF निरीक्षण
8 KiB बॉडी का सिमैंटिक स्कैन 12,784.3 ns लेता है, यानी \(12784.3 / 8192 \approx 1.56\) ns प्रति बाइट। दूसरी पंक्ति उसी बॉडी को SQL injection श्रेणी ऑडिट मोड में और बाकी enforce मोड में रखकर स्कैन करती है: 15,485.4 ns। जब कोई श्रेणी enforce के बजाय ऑडिट मोड में हो, तो हर फ़ील्ड का निरीक्षण प्रति श्रेणी होता है (SID 0004, "inspection modes")। इंजन फ़ील्ड को सिग्नेचर ऑटोमेटन से एक बार स्कैन करता है, उन श्रेणियों के समुच्चय के लिए जिनके सिग्नेचर आते हैं, फिर उनमें से केवल वांछित श्रेणियाँ खोजता है, इसलिए एक श्रेणी को ऑडिट करने की लागत सभी को enforce करने से लगभग पाँचवाँ हिस्सा अधिक है, प्रति श्रेणी एक स्कैन नहीं।
पूरे उत्पादों की तुलना
तालिकाएँ हर सतह और वर्कलोड के लिए पाँच-सेकंड के तीन wrk रन की माध्यिकाएँ देती हैं। हर वर्कलोड के पास का स्टेटस वह उत्तर है जिसकी हार्नेस ने अपेक्षा की और जो उसे मिला।
Forward-auth मोड
इनग्रेस डेमन से पूछता है कि किसी अनुरोध को प्रवेश दे या नहीं; कोई ऑरिजिन नहीं और कोई बॉडी रिले नहीं, इसलिए यह प्रवेश की लागत का सबसे शुद्ध माप है।
| सतह | वर्कलोड (स्टेटस) | req/s | p50 | p90 | p99 | CPU us/req | पीक RSS KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
211,345 | 151 | 175 | 305 | 11.84 | 15912 |
| Gate | challenged (401) |
198,315 | 160 | 180 | 326 | 13.15 | 16176 |
| Gate | allowed_static (200) |
211,053 | 152 | 175 | 305 | 11.73 | 16176 |
| Gate | attack (200) |
211,618 | 151 | 176 | 305 | 11.84 | 16176 |
| Shield | admitted (200) |
208,101 | 152 | 178 | 308 | 12.87 | 15928 |
| Shield | challenged (401) |
197,532 | 161 | 183 | 327 | 13.77 | 16192 |
| Shield | allowed_static (200) |
211,636 | 151 | 175 | 305 | 11.78 | 16192 |
| Shield | attack (403) |
210,549 | 152 | 175 | 307 | 12.32 | 16192 |
forward-auth मोड में डेमन बाधा (bottleneck) नहीं है। उसके व्यस्त कोर (वास्तविक समय पर CPU समय, JSON फ़ाइल में cores_busy_median) चार डेमन CPU में से 2.47 और 2.72 के बीच रहते हैं, और हर पंक्ति प्रति सेकंड 197,532 और 211,636 अनुरोधों के बीच है। यह लोड जनरेटर को ऊपरी सीमा के रूप में दिखाता है। उस सीमा के पास पंक्तियों के बीच कुछ प्रतिशत का अंतर रन दर रन बदलता है: अकेली Gate admitted पंक्ति अपने तीन रन में प्रति सेकंड 205,151 से 211,513 अनुरोधों तक फैली है। इस मोड में अधिक उपयोगी आँकड़ा प्रति अनुरोध CPU समय है: 11.73 से 13.77 us, Gate की तुलना में Shield के लिए थोड़ा अधिक, और सबसे अधिक challenged पंक्तियों के लिए, जो चैलेंज उत्तर रेंडर करती हैं।
रिवर्स-प्रॉक्सी मोड
डेमन स्टब ऑरिजिन के सामने रहता है और स्वीकृत अनुरोधों और रिस्पॉन्स को रिले करता है। इसलिए प्रॉक्सी की गई पंक्तियों में ऑरिजिन की अपनी लागत और एक अतिरिक्त loopback hop शामिल है।
| सतह | वर्कलोड (स्टेटस) | req/s | p50 | p90 | p99 | CPU us/req | पीक RSS KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
142,498 | 427 | 548 | 768 | 27.68 | 15896 |
| Gate | challenged (200) |
199,465 | 160 | 181 | 324 | 12.98 | 16160 |
| Gate | allowed_static (200) |
147,303 | 411 | 541 | 759 | 26.88 | 16324 |
| Gate | attack (200) |
143,900 | 422 | 555 | 745 | 27.67 | 16348 |
| Shield | admitted (200) |
138,965 | 438 | 571 | 857 | 28.57 | 16064 |
| Shield | challenged (200) |
195,188 | 162 | 185 | 328 | 13.73 | 16328 |
| Shield | allowed_static (200) |
145,673 | 415 | 551 | 746 | 27.27 | 16328 |
| Shield | attack (403) |
209,507 | 151 | 177 | 306 | 12.17 | 16328 |
यहाँ प्रॉक्सी की गई पंक्तियाँ (admitted, allowed_static, और Gate का attack, जिसे Gate रिले करता है) CPU से बँधी हैं: चार में से 3.96 से 3.98 कोर व्यस्त हैं। वे प्रति अनुरोध 26.88 से 28.57 us CPU पर प्रति सेकंड 138,965 से 147,303 अनुरोध सर्व करती हैं, जो उस उत्तर की लागत का लगभग दोगुना है जिसे डेमन स्वयं देता है। challenged पंक्तियों और Shield की attack पंक्ति का उत्तर डेमन स्वयं देता है, और वे forward-auth पंक्तियों जैसी दिखती हैं। संतृप्ति में wrk का p99 डेमन की अपनी दर पर शेड्यूलर की टेल है, इसलिए हम इसके बजाय अगले अध्याय की टेल पढ़ते हैं।
तीन रिवर्स-प्रॉक्सी पंक्तियों में wrk ने 2xx और 3xx वर्गों से बाहर के रिस्पॉन्स गिने, जहाँ किसी की अपेक्षा नहीं थी: 2,162,579 में से 3 अनुरोध (Gate attack), 2,082,640 में से 1 (Shield admitted) और 2,204,358 में से 1 (Shield allowed_static), तीनों रन का योग। फ़ाइलें यह दर्ज नहीं करतीं कि ये कौन-सा स्टेटस थे। डेमन के मेट्रिक के साथ रन को दोहराने पर sibuna_overloaded_total में गिने गए 503 उत्तर दिखे: wrk अपने 64 कनेक्शन एक पते से खोलता है, जो ठीक डिफ़ॉल्ट --max-connections-per-ip है, और जब कोई कनेक्शन अपने 4,096वें अनुरोध के बाद बंद हुआ, तो पुराने कनेक्शन के अपना स्थान लौटाने से पहले ही wrk दोबारा जुड़ गया। अब डेमन समापन रिस्पॉन्स लिखने से पहले स्थान लौटा देता है (SID 0002, "bug fix"); तालिकाएँ उस सुधार से पहले की हैं।
संसाधन उपयोग (Footprint)
| माप | मान |
|---|---|
| डेमन बाइनरी | 49,113,856 bytes |
| निष्क्रिय resident मेमोरी, उत्पाद रन | 5,592 से 5,788 KiB |
| किसी वर्कलोड के दौरान पीक resident मेमोरी | 15,896 से 16,348 KiB |
| वर्कलोड के बाद resident मेमोरी | 16,176 से 16,348 KiB |
| निष्क्रिय resident मेमोरी, प्रिमिटिव रन | 6,052 KiB |
| नीति इंजन टेबल | 209,052 बाइट (हीप) |
| बॉट सिग्नेचर टेबल | 42,244 बाइट (हीप) |
| WAF टेबल | 164,908 बाइट (हीप) |
| ब्राउज़र सॉल्वर मॉड्यूल (WebAssembly) | 14,744 bytes |
श्रेणियाँ चार उत्पाद रन (दो मोड, दो सतह) पर हैं, और पीक के लिए उनके सोलह वर्कलोड पर। टेबल के आकार इंजन द्वारा रिपोर्ट किए गए हीप आकार हैं। रिकॉर्ड बाइनरी के आकार का विभाजन नहीं देता।
समान प्रस्तावित लोड पर लेटेंसी
दोनों तालिकाएँ cargo xtask bench latency के एक रन से आती हैं। त्रुटियों वाला कॉलम जनरेटर की कनेक्शन, I/O और फ़्रेमिंग त्रुटियाँ गिनता है।
| प्रस्तावित req/s | प्राप्त req/s | p50 | p90 | p99 (min-max) | p99.9 | अधिकतम | त्रुटियाँ | CPU us/req |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 10,000 | 30 | 32 | 37 (36-39) | 58 | 355 | 0 | 16.92 |
| 25,000 | 25,000 | 28 | 31 | 34 (32-34) | 45 | 1035 | 0 | 15.83 |
| 50,000 | 50,000 | 25 | 27 | 30 (30-30) | 40 | 3029 | 0 | 13.83 |
| 100,000 | 99,998 | 24 | 26 | 41 (40-42) | 62 | 2358 | 0 | 13.48 |
| 150,000 | 149,996 | 25 | 36 | 51 (51-52) | 74 | 1753 | 0 | 14.16 |
| प्रस्तावित req/s | प्राप्त req/s | p50 | p90 | p99 (min-max) | p99.9 | अधिकतम | त्रुटियाँ | CPU us/req |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 10,000 | 56 | 61 | 65 (65-66) | 76 | 555 | 0 | 32.25 |
| 25,000 | 25,000 | 51 | 54 | 58 (58-60) | 72 | 1105 | 0 | 28.63 |
| 50,000 | 50,000 | 47 | 50 | 60 (58-66) | 74 | 3066 | 0 | 27.45 |
| 100,000 | 99,996 | 55 | 75 | 100 (100-104) | 150 | 2239 | 0 | 28.42 |
| 150,000 | 134,344 | 583934 | 1544160 | 1906273 (1631234-2218760) | 1967134 | 1989964 | 4 | 29.22 |
forward-auth मोड में p50 हर दर पर 24 और 30 us के बीच रहता है। p99 प्रति सेकंड 150,000 अनुरोधों तक 51 us या उससे कम रहता है, और p99.9 74 us या उससे कम। डेमन प्रति अनुरोध 13.48 से 16.92 us CPU खर्च करता है।
रिवर्स-प्रॉक्सी मोड में p50 प्रति सेकंड 100,000 अनुरोधों तक 47 से 56 us है, और 100,000 पर p99 100 us तथा p99.9 150 us है। प्रति सेकंड 150,000 अनुरोधों पर डेमन संतृप्त हो जाता है: वह प्रति सेकंड 134,344 अनुरोध पूरे करता है, और लेटेंसी सेकंडों तक बढ़ जाती है, जैसा कि क्षमता से ऊपर open-loop परीक्षण को दिखाना चाहिए। वह दर पिछले अध्याय के closed-loop प्रॉक्सी थ्रूपुट के पास है (Shield admitted के लिए प्रति सेकंड 138,965 अनुरोध)। उस पंक्ति की चार त्रुटियाँ ओवरलोड में हुईं।
संतृप्ति से नीचे p99 के फैलाव संकरे हैं; सबसे चौड़ा प्रति सेकंड 50,000 अनुरोधों पर रिवर्स-प्रॉक्सी p99 है, 58 से 66 us। अधिकतम वाला कॉलम एक रन के 15 लाख तक के अनुरोधों में से एक अनुरोध है। साझा होस्ट पर हम इसे डेमन का गुण नहीं, होस्ट का सबसे खराब क्षण मानते हैं।
मापन ने क्या बदला
बाहरी लोड ने Sibuna का डिज़ाइन बदला है। डेमन हर कनेक्शन को उसके अपने थ्रेड पर सर्व करता है (SID 0002, SID 0010), और उसके पहले लेटेंसी रन ने एक ऐसी टेल पाई जो wrk ने नहीं दिखाई थी। 64 कनेक्शन के साथ, जिनमें से हर एक को डेमन 4,096 अनुरोधों के बाद बंद करता है, प्रति सेकंड 100,000 स्वीकृत अनुरोधों पर 99.9वाँ पर्सेंटाइल 0.3 से 2 ms था।
SID 0002 में और cmd/sibuna/src/tasks.rs के दस्तावेज़ीकरण में दर्ज निदान थ्रेड का बदलाव (turnover) है। थ्रेड बनाना और समाप्त करना उसके signal stack को map और unmap करता है और उसके स्टैक पेज लौटाता है, और address-space के इन बदलावों ने डेमन के दूसरे थ्रेड को अटका दिया। एक प्रयोग ने इसे तय कर दिया: एक बिल्ड जो कभी कनेक्शन बंद नहीं करता था, ताकि रन के दौरान कोई थ्रेड न बने, उसने उसी दर पर 54 से 60 us दिए। सुधार कनेक्शन थ्रेड को दोबारा उपयोग करता है: जो थ्रेड अपना कनेक्शन पूरा कर लेता है, वह रुककर अगला ले लेता है, इसलिए नए कनेक्शनों की स्थिर धारा कोई थ्रेड नहीं बनाती। 10 सेकंड तक रुका रहा थ्रेड समाप्त हो जाता है और अगले launch या task पूरा करने वाले अगले थ्रेड द्वारा join किया जाता है, इसलिए कोई बर्स्ट अपने स्टैक मेमोरी में नहीं छोड़ता। जिस थ्रेड का कनेक्शन panic करता है, वह रुकने के बजाय समाप्त हो जाता है। पहले की तरह एक साथ अधिकतम --max-connections कनेक्शन सर्व होते हैं।
ऊपर की तालिकाएँ सुधार के बाद के रन की हैं: प्रति सेकंड 100,000 अनुरोधों पर forward-auth मोड में 62 us और रिवर्स-प्रॉक्सी मोड में 150 us का p99.9। सुधार से पहले के रन परिणाम फ़ाइलों के रूप में नहीं रखे गए, इसीलिए उनके आँकड़े केवल SID 0002 में और इस अनुभाग में दिखते हैं।
Sibuna और Anubis
Techaro का Anubis एक व्यापक रूप से उपयोग होने वाला proof-of-work गेट है जो वेबसाइटों के सामने रहता है, लगभग उसी तरह जैसे Sibuna का Gate। हमने Anubis v1.27.0 की आधिकारिक रिलीज़ बाइनरी (anubis-1.27.0-linux-amd64, 40,001,698 बाइट) को उसी होस्ट पर, उन्हीं CPU पर, उन्हीं वर्कलोड के साथ Sibuna के साथ मापा। दोनों परिणाम फ़ाइलें इनसे दर्ज की गईं:
cargo xtask bench product --anubis <path/to/anubis>
cargo xtask bench admission --anubis <path/to/anubis>
Anubis को वैसे ही शुरू किया गया जैसे इस प्रोजेक्ट के पुराने Python ड्राइवर उसे शुरू करते थे: --bind, --metrics-bind, --target= (forward-auth मोड में खाली, रिवर्स-प्रॉक्सी मोड में ऑरिजिन), --difficulty 2, --slog-level ERROR, --cookie-secure=false, और एक नीति जो हर Mozilla User-Agent को चैलेंज करती है, DNSBL और हनीपॉट अक्षम करके। GOMAXPROCS Sibuna के वर्करों की संख्या के बराबर है, और दोनों उत्पादों का हर थ्रेड उसी CPU समुच्चय पर पिन है। Hashcash कार्य बराबर रखा गया है: Sibuna के लिए 8 शून्य बिट, Anubis के लिए 2 शून्य हेक्साडेसिमल अंक, वही अपेक्षित 256 हैश। हार्नेस हर उत्पाद का सत्र वैसे ही प्राप्त करता है जैसे कोई ब्राउज़र करता। Anubis के लिए वह चैलेंज पेज लाता है, <script id="anubis_challenge"> से चैलेंज पढ़ता है, वह नॉनस खोजता है जिसका SHA-256(randomData || nonce) 00 से शुरू होता है, और उसे पेज की सत्यापन कुकी के साथ pass-challenge को देता है। forward-auth मोड में admitted और challenged वर्कलोड Anubis के check endpoint (/.within.website/x/cmd/anubis/api/check) से पूछते हैं।
पूरे उत्पाद के वर्कलोड
चार वर्कलोड, लोड और आँकड़े पूरे-उत्पाद हार्नेस वाले ही हैं, एक बदलाव के साथ: ऑरिजिन caddy respond है, लोड CPU पर पिन किया गया, जैसे पुराने ड्राइवर उपयोग करते थे। हर रन से पहले हार्नेस तब तक प्रतीक्षा करता है जब तक TIME_WAIT में 3,000 से कम सॉकेट न रह जाएँ, क्योंकि Anubis के रिवर्स-प्रॉक्सी रन दसियों हज़ार सॉकेट पीछे छोड़ते हैं।
| वर्कलोड | आँकड़ा | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s (स्टेटस) | 210,682 (200) | 208,635 (200) | 36,509 (200) |
| p99 us | 305 | 308 | 7,477 | |
| CPU us/req | 12.09 | 13.21 | 106.30 | |
| पीक RSS KiB | 16,228 | 16,316 | 32,624 | |
challenged |
req/s (स्टेटस) | 198,251 (401) | 193,087 (401) | 113,170 (401) |
| p99 us | 326 | 342 | 3,781 | |
| CPU us/req | 13.49 | 15.02 | 32.96 | |
| पीक RSS KiB | 16,240 | 16,328 | 32,696 | |
allowed_static |
req/s (स्टेटस) | 212,569 (200) | 212,444 (200) | 89,904 (200) |
| p99 us | 304 | 304 | 4,547 | |
| CPU us/req | 11.73 | 11.95 | 41.63 | |
| पीक RSS KiB | 16,240 | 16,328 | 33,396 | |
attack |
req/s (स्टेटस) | 212,086 (200) | 211,347 (403) | 36,853 (200) |
| p99 us | 305 | 306 | 7,283 | |
| CPU us/req | 12.07 | 12.56 | 104.88 | |
| पीक RSS KiB | 16,240 | 16,328 | 33,764 |
| वर्कलोड | आँकड़ा | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s (स्टेटस) | 106,376 (200) | 103,298 (200) | 19,398 (200) |
| p99 us | 3,331 | 3,321 | 11,062 | |
| CPU us/req | 27.02 | 27.92 | 190.40 | |
| पीक RSS KiB | 16,528 | 16,444 | 39,980 | |
challenged |
req/s (स्टेटस) | 198,402 (200) | 197,327 (200) | 28,842 (200) |
| p99 us | 325 | 328 | 9,546 | |
| CPU us/req | 13.05 | 13.78 | 137.73 | |
| पीक RSS KiB | 16,544 | 16,464 | 516,872 | |
allowed_static |
req/s (स्टेटस) | 105,427 (200) | 106,819 (200) | 28,862 (200) |
| p99 us | 3,320 | 3,316 | 30,124 | |
| CPU us/req | 26.24 | 26.52 | 135.41 | |
| पीक RSS KiB | 16,544 | 16,464 | 616,548 | |
attack |
req/s (स्टेटस) | 105,616 (200) | 210,483 (403) | 23,399 (200) |
| p99 us | 3,327 | 306 | 14,124 | |
| CPU us/req | 26.98 | 12.28 | 169.04 | |
| पीक RSS KiB | 16,544 | 16,464 | 599,516 |
forward-auth मोड में Sibuna ने प्रति सेकंड 193,087 से 212,569 अनुरोध 304 से 342 us के p99 के साथ सर्व किए, और Anubis ने 36,509 (admitted) से 113,170 (challenged) 3,781 से 7,477 us के p99 के साथ। Sibuna के व्यस्त कोर चार में से 2.49 और 2.90 के बीच रहे, इसलिए सीमा लोड जनरेटर ने तय की; Anubis के 3.73 से 3.88 थे, इसलिए Anubis CPU से बँधा था। सबसे स्पष्ट आँकड़ा प्रति अनुरोध CPU समय है: एक स्वीकृत अनुरोध की लागत Sibuna Gate के लिए 12.09 us और Anubis के लिए 106.30 us थी। इस अंतर का एक संभावित भाग सत्र टोकन है। Anubis डिफ़ॉल्ट रूप से सत्रों पर Ed25519 से हस्ताक्षर करता है, और Sibuna एक कुंजी-युक्त BLAKE3 MAC जाँचता है (प्रिमिटिव तालिका में 155.8 ns); नीचे के प्रवेश मापन, जहाँ HS512 टोकन Anubis की सत्र जाँचों को आधे से अधिक बढ़ा देते हैं, इस व्याख्या का समर्थन करते हैं।
रिवर्स-प्रॉक्सी मोड में Sibuna की प्रॉक्सी की गई पंक्तियों ने 2.77 से 2.98 व्यस्त कोर पर प्रति सेकंड 103,298 से 106,819 अनुरोध सर्व किए। ये product-latest.json के स्टब ऑरिजिन वाले 138,965 से 147,303 से नीचे हैं, और डेमन CPU से बँधा नहीं है, इसलिए सीमा उसके बाहर है: ऑरिजिन, caddy respond, लोड CPU को wrk के साथ साझा करता है। इसकी टेल 2.1 से 2.4 ms के p90 में दिखती है। Anubis ने 3.68 से 3.97 व्यस्त कोर और प्रति अनुरोध 135 से 190 us CPU पर प्रति सेकंड 19,398 से 28,862 अनुरोध सर्व किए। उसकी resident मेमोरी admitted वर्कलोड में 39,980 KiB से बढ़कर challenged में 516,872 KiB और allowed_static में 616,548 KiB हो गई, और वर्कलोड के बाद उसने 589,276 KiB रखी, जबकि निष्क्रिय अवस्था में 21,552 KiB थी। बढ़ोतरी challenged में शुरू हुई, जहाँ हर अनुरोध को अपने id वाला एक नया चैलेंज मिलता है; यह प्रति जारी चैलेंज रखे गए किसी रिकॉर्ड का संकेत देता है, लेकिन हार्नेस ने कारण की पुष्टि नहीं की। Sibuna का पीक दोनों मोड की हर पंक्ति में 16,228 और 16,544 KiB के बीच रहा।
कई पंक्तियाँ भी एक जैसी स्थितियों की तुलना नहीं करतीं:
- forward-auth मोड में Anubis
/robots.txtऔरattackपाथ का उत्तर स्वयं200से देता है, बिना ऑरिजिन के; Sibuna उनका उत्तर वैसे ही देता है जैसे उस मोड में किसी भी अनुरोध का। - Anubis में अनुरोध निरीक्षण नहीं है, इसलिए वह
attackवर्कलोड के SQL injection को प्रवेश देता है। Shield उसे अधिक कार्य के बाद403से अस्वीकार करता है; Gate उसे प्रवेश देता है, जैसे Anubis। - उत्पाद सत्रों पर अलग-अलग तरह से हस्ताक्षर करते हैं (Anubis के लिए डिफ़ॉल्ट रूप से Ed25519, Sibuna के लिए कुंजी-युक्त BLAKE3 MAC), और वे अलग-अलग चैलेंज पेज रेंडर करते हैं।
प्रवेश ऑपरेशन
प्रवेश हार्नेस उन चार ऑपरेशनों का समय मापता है जिनसे प्रवेश बनता है, forward-auth मोड में, हर उत्पाद दो CPU पर (Sibuna के दो वर्कर, GOMAXPROCS=2)। लोड CPU पर दो क्लाइंट थ्रेड, हर एक एक keep-alive कनेक्शन के साथ, हर बैच को साझा करते हैं: 200 ऑपरेशन, या सत्यापन के लिए 64 प्रमाण, जो बैच से पहले तैयार किए जाते हैं। हम सात बैच की माध्यिका रिपोर्ट करते हैं।
- सत्र जाँच: वैध सत्र के साथ check endpoint (
200)। - अप्रमाणित जाँच: वही, बिना कुकी के (
401)। - चैलेंज बूटस्ट्रैप: चैलेंज शुरू करने के लिए ब्राउज़र जो लाता है। Sibuna के लिए यह दो अनुरोध हैं, इंटरस्टिशियल और चैलेंज रिकॉर्ड; Anubis के लिए एक, एम्बेडेड चैलेंज वाला पेज।
- प्रमाण सत्यापन: प्रति ऑपरेशन एक नया प्रमाण। Sibuna के प्रमाण वाले चैलेंज 25 ms के अंतर पर जारी होते हैं, उस प्रति सेकंड 50 से नीचे जिस पर उसकी अनुकूली कठिनाई बिट जोड़ती है, इसलिए बराबर रखा गया कार्य बना रहता है। Sibuna
--challenge-rate-limit 100000000के साथ चलता है, इसलिए उसका लिमिटर जाँचा जाता है लेकिन कभी समाप्त नहीं होता।
Anubis दो बार चला, अपने डिफ़ॉल्ट Ed25519 टोकन के साथ और --hs512-secret के साथ।
| उत्पाद (टोकन) | सत्र जाँच | अप्रमाणित जाँच | चैलेंज बूटस्ट्रैप | प्रमाण सत्यापन | बाद में RSS, KiB |
|---|---|---|---|---|---|
| Sibuna (कुंजी-युक्त BLAKE3) | 88,104 | 78,997 | 42,664 | 57,924 | 7,792 |
| Anubis 1.27.0 (Ed25519) | 10,951 | 28,619 | 7,893 | 12,668 | 33,400 |
| Anubis 1.27.0 (HS512) | 16,976 | 27,785 | 7,952 | 19,261 | 29,840 |
सात बैच की श्रेणियाँ फ़ाइल में हैं। Sibuna की श्रेणियाँ उसकी माध्यिकाओं के 11% के भीतर हैं; Anubis की अधिक चौड़ी हैं (Ed25519 टोकन के साथ उसकी अप्रमाणित जाँचें 25,394 से 32,741 तक फैली हैं), और 200 ऑपरेशन का एक बैच केवल 2 से 25 ms चलता है, इसलिए हम इन आँकड़ों को लगभग दसवें हिस्से की सटीकता तक पढ़ते हैं। धीमे क्लाइंट का प्रति ऑपरेशन समय round trip देता है: Sibuna सत्र जाँच के लिए 22.7 us, Ed25519 टोकन के साथ Anubis जाँच के लिए 182.5 us और HS512 के साथ 117.7 us।
ऊपर की किसी भी पंक्ति में Anubis ने Sibuna से अधिक अनुरोध सर्व नहीं किए, न कम CPU या मेमोरी उपयोग की। यह इस होस्ट पर इन वर्कलोड के बारे में एक कथन है, इससे अधिक कुछ नहीं।
कंसोल का अतिरिक्त भार
SID 0007 कंसोल का पृथक्करण अनुबंध तय करता है। कंसोल सक्षम करने की लागत data-plane थ्रूपुट का अधिकतम 1% और p99 लेटेंसी का अधिकतम 10% हो सकती है, जिसे कॉन्फ़िगरेशन (कंपाइल से बाहर, कंपाइल में लेकिन अक्षम, निष्क्रिय, और आठ सक्रिय डैशबोर्ड) और वर्कलोड के एक मैट्रिक्स पर, बार-बार बारी-बारी से चले रन और रिपोर्ट की गई अनिश्चितता के साथ मापा जाता है। अनिर्णायक या noisy रन अनुपालन स्थापित नहीं करते, और प्रिमिटिव आधार-रेखाएँ और smoke रन गेट का विकल्प नहीं हो सकते।
SID 0010 एक मापन दर्ज करता है: कंसोल कंपाइल होने पर, अक्षम, केवल स्टोरेज, या सक्षम और निष्क्रिय होने पर, 16 उत्पाद वर्कलोड उसके बिना बने डेमन के लगभग 1% के भीतर रहते हैं, जो noise के भीतर है। रिकॉर्ड इसके लिए कोई परिणाम फ़ाइल नहीं बताता। लोड में आठ सक्रिय डैशबोर्ड वाला कॉन्फ़िगरेशन मापा नहीं गया है, इसलिए SID 0007 का औपचारिक गेट खुला रहता है।
आठ-डैशबोर्ड रन कार्य की जाँच करता है, अतिरिक्त भार की नहीं। sibuna-browser dashboards ने एक SQLite नोड पर उसके कंसोल, चार वर्कर और एक ऐसी नीति के साथ रिलीज़ डेमन शुरू किया जो /static/*, /about, /missing/* और /broken/* की अनुमति देती है और बाकी सब को चैलेंज करती है; एक ऑरिजिन fixture /missing/* का उत्तर 404 से और /broken/* का 500 से देता है। एक जनरेटर ने 30 सेकंड तक प्रति सेकंड 200 अनुरोध भेजे, दस पाथ (एक SQL injection), तीन User-Agent और 500 फ़ॉरवर्ड किए गए पते बदलते हुए। हर डैशबोर्ड अपने सत्र के साथ अपने अलग Chromium में चला: डैशबोर्ड 1 से 3 एडमिनिस्ट्रेटर सत्र के रूप में, डैशबोर्ड 4 से 8 पहले वाले द्वारा जारी कोड से खुले wall display के रूप में, क्योंकि कंसोल प्रति पता और प्रति खाता प्रति मिनट पाँच साइन-इन की अनुमति देता है।
| माप | मान |
|---|---|
| Data-plane अनुरोध | 30.0 s में 6,000 (प्रति सेकंड 200, 4 थ्रेड, प्रति अनुरोध एक कनेक्शन) |
| उत्तर दिए गए | 6,000: 200 x 1,200, 401 x 3,000, 403 x 600, 404 x 600, 500 x 600 |
| त्रुटियाँ (कोई उत्तर नहीं) | 0 |
| लेटेंसी p50 / p90 / p99 / अधिकतम | 246 / 311 / 373 / 552 us (connect सहित) |
| शुरुआत में डेमन VmRSS | 36,152 KiB |
| 8 डैशबोर्ड खुले होने पर डेमन VmRSS | 38,028 KiB |
| ट्रैफ़िक के बाद डेमन VmRSS | 41,496 KiB (VmHWM 41,496 KiB) |
ट्रैफ़िक के दौरान हर दो सेकंड पर और उसके 3 सेकंड बाद टाइलें पढ़ी गईं। हर डैशबोर्ड एक जैसे योग पर समाप्त हुआ (Requests 6,000, Admitted 2,400, Challenged 3,000, Policy denied 600, Origin 4xx 600, Origin 5xx 600), उसे 134 से 139 stats delta मिले, उसने अपना WebSocket खुला रखा, और कोई exception, कंसोल त्रुटि या Content-Security-Policy उल्लंघन रिपोर्ट नहीं किया। आठ ब्राउज़र subscriber कंसोल की 64 की सीमा से काफ़ी नीचे हैं। इस रन के डेमन में SQLite स्टोरेज और कंसोल है, उत्पाद हार्नेस के मेमोरी में चलने वाले डेमन के विपरीत, इसलिए इसकी resident मेमोरी उनसे तुलनीय नहीं है।
जो मापा नहीं गया
| विषय | यहाँ क्यों नहीं मापा गया | इसकी जगह क्या है |
|---|---|---|
| SafeLine community edition 9.x | केवल Docker Compose स्टैक के रूप में आता है; होस्ट पर कोई Docker डेमन नहीं था, और डिटेक्टर इमेज ऐसा open-source बिल्ड नहीं है जिसे वहाँ कंपाइल किया जा सके | प्रकाशित, विक्रेता द्वारा रिपोर्ट किए गए तथ्य (सितंबर 2026 में जाँचे गए): पहचान दर 71.65% (balance) और 76.17% (strict), false positive 0.07% (balance) और 0.22% (strict); न्यूनतम होस्ट SSSE3 वाला Linux x86_64 या arm64, 1 CPU कोर, 1 GB RAM, 5 GB डिस्क, Docker 20.10.14+ और Compose 2.0+ |
| Cloudflare WAF | एक होस्टेड सेवा; loopback मापन WAF को नहीं, नेटवर्क पाथ को मापेगा | प्रकाशित प्लान कोटा (सितंबर 2026 में जाँचे गए): कस्टम नियम Free 5, Pro 20, Business 100, Enterprise 1000; rate limiting नियम Free 1, Pro 2, Business 5, Enterprise 100 |
| लोड में एक क्लस्टर | अभी कोई हार्नेस एक PostgreSQL डेटाबेस पर कई नोड नहीं चलाता | वे प्रोटोकॉल गुण जिन्हें SID 0011 निर्दिष्ट करता है (एक साझा सीड, जारीकर्ता से बँधे चैलेंज) और उसका तीन-नोड कार्यात्मक परीक्षण (मानदंड 2); कोई मापन नहीं |
| अनुरोध पाथ पर स्टोरेज | हर हार्नेस में दोनों डेमन मेमोरी में चलते हैं | SID 0011: एक स्टोरेज थ्रेड सारे SQL का स्वामी है, और अनुरोध पाथ कभी उसकी प्रतीक्षा नहीं करता |
| TLS, WAN, वास्तविक ब्राउज़र | हार्नेस loopback और HTTP का उपयोग करते हैं; सत्र हर स्थिति के लिए एक बार sibuna-pow से हल किए जाते हैं |
कुछ नहीं; हर डिप्लॉयमेंट अपना पाथ स्वयं मापता है |
| ब्राउज़र सॉल्वर का हल-समय | हार्नेस नेटिव सॉल्वर से 8 बिट पर हल करता है | ऊपर दिया मॉड्यूल का आकार; भाग VII समझाता है कि नेटिव समय-माप ब्राउज़र के हल-समय का प्रतिनिधित्व क्यों नहीं करते |
| आवंटन की गिनती | हार्नेस एलोकेटर को instrument नहीं करता | भाग V के steady-state परीक्षण |
| लोड में आठ सक्रिय डैशबोर्ड के साथ कंसोल का पृथक्करण | SID 0007 का औपचारिक गेट नहीं चलाया गया है | SID 0010 का आँकड़ा (लगभग 1% के भीतर, कंसोल निष्क्रिय) और ऊपर का कार्यात्मक रन |
इस तालिका की कोई पंक्ति उत्पाद के प्रदर्शन के बारे में दावा नहीं है। SafeLine की अपनी संख्याएँ पहचान की गुणवत्ता से संबंधित हैं, थ्रूपुट से नहीं, और Cloudflare प्रति-अनुरोध लागत के बजाय प्लान कोटा प्रकाशित करता है। Docker होस्ट वाला कोई भी व्यक्ति SafeLine को उन्हीं wrk वर्कलोड के पीछे चला सकता है।