भाग V: Rust में शून्य-आवंटन इंजीनियरिंग
हम एक कनेक्शन को accept से रिस्पॉन्स तक एक निश्चित बफ़र के ज़रिए देखते हैं, और उन समवर्ती डेटा संरचनाओं की जाँच करते हैं जो कई कनेक्शन थ्रेड को अनुरोध पाथ पर हीप आवंटन के बिना अवस्था साझा करने देती हैं। जहाँ मेमोरी सुरक्षा के लिए अन्यथा अपनी अलग व्यवस्था (reader count, arena, descriptor table, teardown chain) चाहिए होती, वहाँ हम दिखाते हैं कि Rust की ओनरशिप उसकी जगह यह कैसे देती है।
कनेक्शन लूप
प्रति कनेक्शन एक थ्रेड, सीमित
Accept वर्कर (--workers, डिफ़ॉल्ट रूप से प्रति CPU एक, अधिकतम 64) listening सॉकेट साझा करते हैं। हर स्वीकृत कनेक्शन एक मेगाबाइट स्टैक वाले उसके अपने थ्रेड को सौंप दिया जाता है, और accept लूप सीधे accept पर लौट जाता है। जो थ्रेड अपना कनेक्शन पूरा कर लेता है, वह रुककर अगला कनेक्शन लेता है, क्योंकि हर कनेक्शन के लिए थ्रेड बनाने और समाप्त करने से दूसरे थ्रेड अटक जाते थे (भाग VIII, SID 0002)। विकल्प, यानी कनेक्शन को accept थ्रेड पर ही पूरा सर्व करना, पहला डिज़ाइन था: एक क्लाइंट पर इसके माप अच्छे थे और चौंसठ पर बुरे, क्योंकि उनमें से साठ किसी वर्कर के 256 अनुरोधों का कोटा पूरा होने की प्रतीक्षा करते थे, और हर प्रतीक्षारत क्लाइंट के साथ टेल लेटेंसी बढ़ती जाती थी। प्रति कनेक्शन एक थ्रेड के साथ, 64 कनेक्शन पर p99 पूरे उत्पाद के हर वर्कलोड में एक मिलीसेकंड से कम रहता है, 305 us से 857 us तक (benchmarks/results/product-latest.md; भाग VIII)।
कनेक्शन थ्रेड की संख्या --max-connections से सीमित है (डिफ़ॉल्ट 1,024, अधिकतम 8,192)। सीमा पार होने पर accept लूप नए सॉकेट पर 503 Service Unavailable उत्तर देता है और कुछ भी शुरू किए बिना उसे बंद कर देता है, और इस घटना को sibuna_overloaded_total में गिनता है।
fn accept_loop(server: &Arc<Server>, listener: &TcpListener) {
    while !server.is_stopping() {
        let stream = match listener.accept() {
            Ok((stream, _)) => stream,
            // ... descriptor या मेमोरी खत्म: spin करने के बजाय 1 ms रुकें
        };
        let limit = server.max_connections.load(Ordering::Relaxed);
        if server.connections.fetch_add(1, Ordering::Relaxed) >= limit {
            server.connections.fetch_sub(1, Ordering::Relaxed);
            server.metrics.overloaded.bump();
            let text = "Service Unavailable: connection limit reached";
            reject(server, &stream, text);
            continue;
        }
        set_no_delay(&stream);
        let task_server = Arc::clone(server);
        let launched = server.tasks.launch(move || {
            let _counted = Counted(&task_server);
            crate::connection::serve(&task_server, &stream);
        });
        // ... launch विफल होने पर स्थान लौटता है और एक ओवरलोड गिना जाता है
    }
}
Counted एक guard है जिसका Drop सीमा में कनेक्शन का स्थान वापस कर देता है, थ्रेड चाहे जैसे समाप्त हो, return से या panic से। 503 वाला पाथ सॉकेट की अपनी ओर को बंद करने से पहले वह सब पढ़कर खाली कर देता है जो क्लाइंट पहले ही भेज चुका है: बिना पढ़े बाइट वाले सॉकेट को बंद करने पर reset उत्तर जाता है, और reset 503 को मिटा देगा।
थ्रेड एक TaskPool (cmd/sibuna/src/tasks.rs) से आते हैं, जो join किए जा सकने वाले स्लॉट की एक निश्चित टेबल है। समाप्त हुआ थ्रेड join होने तक अपना स्टैक रखता है, इसलिए स्लॉट को तब join किया जाता है जब उसे दोबारा लिया जाता है, और नया task कर्सर आगे बढ़ाने के बजाय सबसे निचला समाप्त स्लॉट लेता है। कर्सर किसी समाप्त स्लॉट तक टेबल का पूरा चक्कर लगाने के बाद ही दोबारा पहुँचता, जिससे हज़ारों समाप्त थ्रेड मेमोरी में बने रहते, और मेमोरी खुले कनेक्शनों के बजाय सर्व किए गए कनेक्शनों के साथ बढ़ती। दूसरा guard, Finished, task समाप्त होने पर स्लॉट को मुक्त चिह्नित करता है, इसलिए panic करने वाला कनेक्शन भी अपना स्लॉट मुक्त कर देता है।
मेमोरी भी इसी तरह सीमित है। कनेक्शन थ्रेड अपने स्टैक पर अपना 64 KiB रीड बफ़र और 16 KiB राइट बफ़र रखता है, और हीप पर 40 KiB का प्रॉक्सी वर्कस्पेस, जो कनेक्शन शुरू होने पर एक बार आवंटित होता है। इसलिए सबसे खराब स्थिति एक ज्ञात संख्या है, यह इस पर निर्भर नहीं कि कोई क्लाइंट कितने सॉकेट खोल सकता है। आइडल रीपर (नीचे) उन कनेक्शनों को बंद करता है जो भेजना बंद कर देते हैं, इसलिए कोई धीमा क्लाइंट किसी थ्रेड को --idle-timeout से आगे नहीं रोक सकता।
आवंटक का चयन
Rust 1.100 में Allocator API का मुख्य भाग और Vec तथा Box के आवंटक पैरामीटर स्थिर हो गए हैं (रिलीज़ नोट)। हम प्रक्रिया का आवंटक बदले बिना किसी एक संग्रह का आवंटक चुन सकते हैं। इस API से अनुरोध पथ पर आवंटन की और बचत नहीं होती: तैयार कनेक्शन पर अनुरोध पहले से कोई मेमोरी आवंटित नहीं करते, जिसकी जाँच cmd/sibuna/tests/steady_state.rs और crates/net/tests/steady_state.rs करते हैं। प्रॉक्सी हर कनेक्शन के लिए अपने तीन बफ़र एक बार आवंटित करता है और उनका पुनः उपयोग करता है। सीमक और प्रयुक्त प्रमाणों का सेट भी अपनी तालिकाएँ एक ही बार आवंटित करते हैं; शून्य से आरंभ किए गए आवंटन में अछुए पृष्ठ निवासी मेमोरी नहीं लेते, जिसकी जाँच crates/store/tests/resident.rs करता है।
आवंटक में बदलाव की जाँच करते समय हम पहले नीति स्नैपशॉट के निर्माण और कंसोल के JSON पार्सिंग को मापेंगे। उनके अस्थायी संग्रह अनुरोध पथ के बाहर मेमोरी आवंटित करते हैं, लेकिन किसी संग्रह का आवंटक उसके तत्वों के आवंटन को अपने आप नियंत्रित नहीं करता। हमारा JSON वृक्ष एस्केप वाली स्ट्रिंग का स्वामित्व भी Cow<str> के माध्यम से रखता है, जिसका स्वामित्व वाला रूप String है; Rust 1.100 में String का कोई आवंटक पैरामीटर नहीं है। इस रिलीज़ में Arc::new_in भी अस्थिर है (API दस्तावेज़)। प्रकाशित इंजन Arc के माध्यम से तब तक साझा रहते हैं जब तक अंतिम पाठक उन्हें छोड़ नहीं देता, इसलिए पुनर्निर्माण उस मेमोरी को रीसेट नहीं कर सकता जिसे पुराना इंजन अभी उपयोग कर रहा है। किसी अरीना को इन जीवनकालों और पार्सर की इनपुट सीमाओं को बनाए रखना होगा।
हम कंसोल के WebAssembly मॉड्यूल के मौजूदा वैश्विक आवंटक WipeOnFree को cmd/console-ui/src/abi.rs में बनाए रखते हैं। यह मुक्त किए गए ब्लॉक मिटाता है, जिनमें पुनः आवंटन के बाद पुराना ब्लॉक भी शामिल है। किसी संग्रह के लिए सीधे System चुनने से यह मिटाना छूट जाएगा। कार्य प्रमाण के WebAssembly मॉड्यूल में कोई हीप आवंटक नहीं है, और Argon2 पहले से कॉलर के स्वामित्व वाले कार्यक्षेत्र का पुनः उपयोग करता है। इसलिए हम मापे गए कार्यभार से बदलाव उचित सिद्ध होने तक मौजूदा आवंटक और Rust 1.94 संगतता बनाए रखते हैं। किसी विकल्प को मिटाना, सीमाबद्ध इनपुट प्रसंस्करण और आवंटन रहित अनुरोध पथ बनाए रखते हुए विलंबता या निवासी मेमोरी में सुधार करना होगा।
प्रति कनेक्शन एक बफ़र
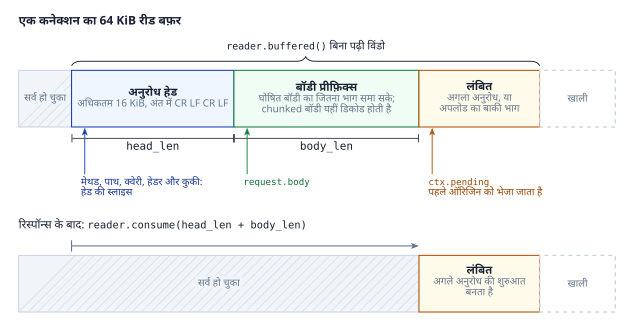
अनुरोध पाथ पर हर डायनामिक आवंटन denial-of-service का एक लीवर है: दिनों में बढ़ता विखंडन (fragmentation), थ्रेड के बीच एलोकेटर लॉक की होड़, और उन हमलावरों द्वारा प्रवर्धन जो आवंटन को अधिकतम करने वाले अनुरोध गढ़ते हैं। Sibuna का नियम पूर्ण है: वर्गीकरण, सत्यापन और प्रॉक्सी को सौंपना शून्य हीप आवंटन के साथ चलते हैं। कनेक्शन हैंडलर सॉकेट के पूरे जीवनकाल के लिए एक 64 KiB रीड बफ़र और एक 16 KiB राइट बफ़र का स्वामी है; बाकी सब उनमें स्लाइस है।
pub fn serve(server: &Server, stream: &TcpStream) {
    let Some(lease) = server.idle.register(stream) else { return };
    // ...
    let mut read_buffer = [0u8; MAX_REQUEST_BYTES]; // 64 KiB
    let mut write_buffer = [0u8; WRITE_BUFFER]; // 16 KiB
    let mut reader = Reader::new(stream, &mut read_buffer[..]);
    let mut peer = PeerText::default();
    peer.format(stream.peer_addr().ok());
    let mut link = Link {
        server,
        stream,
        writer: Writer::new(stream, &mut write_buffer[..]),
        workspace: Workspace::new(),
        cache: EngineCache::new(),
        activity: lease.activity(),
        last: false,
    };
    for served in 0..MAX_REQUESTS_PER_CONNECTION {
        link.last = served + 1 == MAX_REQUESTS_PER_CONNECTION;
        if !serve_one(&mut reader, &mut link, peer.as_bytes()) {
            break;
        }
        lease.touch();
    }
}
read_head बफ़र को तब तक भरता है जब तक खाली पंक्ति न आ जाए, और केवल पिछली खोज के बाद आए बाइट में खोजता है, और 16 KiB से बड़े हेड को 431 के साथ अस्वीकार करता है। parse_request (क्रेट sibuna-http) एक Request<'a> बनाता है जिसके मेथड, पाथ, क्वेरी, हेडर और कुकी बफ़र की स्लाइस हैं। घोषित बॉडी को जितनी समा सके उतनी भरा जाता है और हेड के बाद स्लाइस किया जाता है। फिर reader.consume(head_len + body_len) रीडर को आगे बढ़ाता है, ताकि अगला keep-alive अनुरोध साफ़ शुरू हो; रीडर बिना पढ़े बाइट को आगे केवल तब खिसकाता है जब उसे जगह चाहिए। chunked बॉडी को हेड के पीछे उसी स्थान पर डिकोड किया जाता है (SID 0009): हर चरण की फ़्रेमिंग बफ़र से काट दी जाती है, इसलिए डिकोड किया गया प्रीफ़िक्स निरीक्षण के लिए सटा हुआ रहता है। आंतरिक रूट लंबाई से सीमांकित हैं और कनेक्शन खुला रखते हैं। प्रॉक्सी किए गए अनुरोध भी इसे खुला रखते हैं, बशर्ते ऑरिजिन का रिस्पॉन्स फ़्रेम किया गया हो और बॉडी पूरी तरह बफ़र हुई हो; अगले अनुभाग दिखाते हैं कि प्रॉक्सी यह कैसे तय करता है।
fn serve_one<W: Write>(
    reader: &mut Reader<'_, &TcpStream>,
    link: &mut Link<'_, W>,
    peer: &[u8],
) -> bool {
    let head_len = match read_head(reader) {
        Head::Complete(length) => length,
        Head::TooLarge => { /* 431 "Request head exceeds 16 KB" */ return false; }
        Head::Closed | Head::Failed => return false,
    };
    let framing = {
        let bytes = reader.buffered();
        let head = bytes.get(..head_len).unwrap_or_default();
        let request = match parse_request(head) {
            Ok(request) => request,
            Err(error) => return reject_head(link, error),
        };
        let declared = request.content_length().unwrap_or(0);
        // ... Expect: 100-continue
        if declared == 0 && !request.chunked {
            let upload = Upload::declared(&request);
            let pending = bytes.get(head_len..).unwrap_or_default();
            let keep = dispatch(link, request, pending, upload, 0, peer);
            reader.consume(head_len);
            return keep;
        }
        (declared, request.chunked)
    };
    serve_with_body(reader, link, peer, head_len, framing)
}
प्रॉक्सी हेड का पुनर्लेखन
हेड को ज्यों का त्यों फ़ॉरवर्ड नहीं किया जाता। write_request_head (crates/net/src/request.rs, क्रेट sibuna-net) अनुरोध पंक्ति और हर हेडर को ऑरिजिन writer में दोबारा लिखता है, और hop-by-hop फ़ील्ड (Connection, Keep-Alive, Proxy-Connection, Transfer-Encoding, TE, Trailer, Upgrade, प्रॉक्सी प्राधिकरण फ़ील्ड), कोई भी आने वाला फ़ॉरवर्डिंग या ऑडिट फ़ील्ड (X-Forwarded-For, X-Real-IP, Forwarded, X-Forwarded-Proto, X-Forwarded-Host, X-Forwarded-Port, X-Sibuna-Status, X-Sibuna-Rule), Expect, Content-Length, और हर वह फ़ील्ड जिसे अनुरोध का Connection हेडर नामित करता है, हटा देता है। फिर वह ऑडिट समुच्चय जोड़ता है। बॉडी की फ़्रेमिंग बनाई जाती है, कभी कॉपी नहीं की जाती:
for header in request.headers() {
    if is_hop_by_hop(header.name) || nominated(request, header.name) {
        continue;
    }
    out.write_all(header.name)?;
    out.write_all(b": ")?;
    out.write_all(header.value)?;
    out.write_all(b"\r\n")?;
}
match upload {
    Upload::None => {}
    Upload::Length(length) => {
        out.write_all(b"Content-Length: ")?;
        write_decimal(out, *length)?;
        out.write_all(b"\r\n")?;
    }
    Upload::Chunked(_) => out.write_all(b"Transfer-Encoding: chunked\r\n")?,
}
Content-Length दोबारा लिखा जाता है। जो chunked बॉडी कनेक्शन बफ़र के भीतर समाप्त हो गई, उसे उसी स्थान पर डिकोड करके उसकी लंबाई के साथ भेजा जाता है। लंबी बॉडी को Transfer-Encoding: chunked के रूप में घोषित किया जाता है और एक बार में एक रीड करके दोबारा chunk किया जाता है (SID 0009): हर रीड प्रॉक्सी के 16 KiB अपलोड बफ़र में आती है, वहीं डिकोड होती है, और एक canonical chunk के रूप में बाहर जाती है, इसलिए ऑरिजिन कभी क्लाइंट के chunk आकार, extension या trailer नहीं देखता। ऑडिट समुच्चय:
Connection: keep-alive
X-Forwarded-For: <client>
X-Forwarded-Proto: <scheme>
X-Real-IP: <client>
X-Sibuna-Status: PASS
X-Sibuna-Rule: session | robots-txt | ip/cidr-trie | ...
बफ़र से बड़ी बॉडी को रिस्पॉन्स वापस स्ट्रीम होने से पहले क्लाइंट से ऑरिजिन writer तक 16 KiB के टुकड़ों में रिले किया जाता है (relay_body)। crates/net/src/request.rs में यूनिट परीक्षण proxy_head_rewrite_drops_hop_by_hop_headers_and_injects_audit_fields पुष्टि करता है कि पुनर्लेखन एक जाली X-Forwarded-For को हटा देता है और ऑडिट फ़ील्ड जोड़ता है।
प्रॉक्सी के तीन बफ़र, ऑरिजिन रीड बफ़र (एक रिस्पॉन्स हेड, 16 KiB), ऑरिजिन राइट बफ़र (8 KiB) और अपलोड बफ़र (16 KiB), एक Workspace में रहते हैं जिसे कनेक्शन एक बार आवंटित करता है और हर अनुरोध के लिए दोबारा उपयोग करता है। वर्कस्पेस उनके जीवनकाल को एक्सचेंज का नहीं, कनेक्शन का बना देता है, और ऑरिजिन रीडर और writer उन्हें एक समय पर एक एक्सचेंज के लिए उधार लेते हैं।
ऑरिजिन रिस्पॉन्स का रिले
पहला प्रॉक्सी ऑरिजिन के बंद होने तक उसके बाइट स्ट्रीम करता था और फिर क्लाइंट को बंद कर देता था: बिना पार्सिंग के सही फ़्रेमिंग, लेकिन प्रति प्रॉक्सी अनुरोध एक नए TCP कनेक्शन की कीमत पर। लोड जनरेटर के तहत यह कीमत TIME_WAIT में दसियों हज़ार सॉकेट के रूप में दिखी, और loopback पर ephemeral पोर्ट समाप्त हो गए। अब प्रॉक्सी ऑरिजिन का हेड (अधिकतम 16 KiB) पढ़ता है और RFC 9112 के नियमों से बॉडी को वर्गीकृत करता है:
pub enum Framing { None, Length(u64), Chunked, UntilClose }

pub fn parse_response_head(
    head: &[u8],
    head_request: bool,
) -> Option<ResponseHead> {
    let status = status_code(head)?;
    let mut fields = FramingFields {
        keep_alive: head.get(7) == Some(&b'1'),
        ..Default::default()
    };
    for line in crlf_lines(head).skip(1) {
        if line.is_empty() {
            break;
        }
        fields.read_line(line)?; // Transfer-Encoding, Content-Length, Connection
    }
    let mut framing = fields.length.map_or(Framing::UntilClose, Framing::Length);
    if head_request || status / 100 == 1 || status == 204 || status == 304 {
        framing = Framing::None;
    } else if fields.encoded {
        framing =
            if fields.chunked { Framing::Chunked } else { Framing::UntilClose };
    }
    let mut keep_alive = fields.keep_alive;
    if framing == Framing::UntilClose || fields.closing {
        keep_alive = false;
    }
    if fields.nominates_framing {
        return None;
    }
    Some(ResponseHead { status, framing, keep_alive })
}
पार्सर वह अस्वीकार करता है जिसे प्रॉक्सी को रिले नहीं करना चाहिए: खराब स्टेटस पंक्ति, ऐसा फ़ील्ड नाम जो टोकन नहीं है, मान में कंट्रोल बाइट, परस्पर विरोधी लंबाइयाँ, दोहराई गई या गैर-अंतिम chunked coding, और ऐसा Connection फ़ील्ड जो Content-Length या Transfer-Encoding को नामित करता है। इसका कार्य हेड में रैखिक है, और यह कभी panic नहीं करता।
हेड क्लाइंट को दोबारा लिखा जाता है, जिसमें ऑरिजिन के Connection हेडर की जगह Sibuna का अपना निर्णय होता है, और बॉडी ठीक-ठीक रिले की जाती है: लंबाई के लिए copy_exact, chunked coding के लिए chunk दर chunk (आकार पंक्ति, डेटा, trailer), और पुरानी (legacy) स्थिति के लिए copy_remaining। केवल legacy स्थिति क्लाइंट को बंद करती है। हर रिले एक ही कॉपी चरण पर बना है: स्रोत के पास जो पहले से है उसे आगे भेजें, और केवल तब, जब उसके पास कुछ न हो, गंतव्य को flush करें और फिर एक बार पढ़ें। इसलिए छोटे राइट की धारा जैसे-जैसे बनती है वैसे-वैसे पहुँचाई जाती है, जबकि बड़ा स्थानांतरण फिर भी प्रति रीड और राइट एक पूरा बफ़र ले जाता है।
let keep = client_keep_alive && parsed.framing != Framing::UntilClose;
write_client_head(client, head, keep).map_err(client_head_error)?;
origin.consume(head_length);
match parsed.framing {
    Framing::None => {}
    Framing::Length(length) => copy_exact(origin, client, length, progress)?,
    Framing::Chunked => relay_chunked(origin, client, progress)?,
    Framing::UntilClose => copy_remaining(origin, client, progress)?,
}
client.flush().map_err(|_| ProxyError::ClientFailed)?;
Ok(Relayed { client_keep: keep, origin_reusable: parsed.keep_alive })
आठ फ़ील्ड वाले ऑरिजिन हेड को पार्स करने में 322 ns लगते हैं, और loopback पर प्रॉक्सी किए गए 1 KiB रिस्पॉन्स वाले keep-alive GET में 29.8 us लगते हैं (अक्टूबर 2026 में मापा गया; crates/net/src/lib.rs मापन का दस्तावेज़ देता है)।
ऑरिजिन पूल
फ़्रेमिंग पार्स करने से प्रॉक्सी को यह भी पता चलता है कि ऑरिजिन सॉकेट दोबारा उपयोग हो सकता है या नहीं: Connection: close के बिना HTTP/1.1 रिस्पॉन्स (या keep-alive के साथ HTTP/1.0 रिस्पॉन्स), जिसकी बॉडी पूरी तरह consume हो चुकी हो, सॉकेट को एक साफ़ अनुरोध सीमा पर छोड़ता है। ऐसे सॉकेट 256 निष्क्रिय ऑरिजिन कनेक्शनों के एक निश्चित पूल में जाते हैं, और अगला प्रॉक्सी अनुरोध नया कनेक्शन बनाने के बजाय उनमें से एक लेता है। पूल के बिना हर प्रॉक्सी अनुरोध एक नया ऑरिजिन कनेक्शन खोलता है, और हर बंद कनेक्शन अपना स्थानीय पोर्ट TIME_WAIT में रोके रखता है; लोड में loopback पर प्रॉक्सी के ephemeral पोर्ट जल्दी समाप्त हो जाते हैं, और उसका थ्रूपुट गिर जाता है।
एक लॉक के अधीन पूल हर प्रॉक्सी अनुरोध को उस लॉक के लिए होड़ में डाल देता। इसलिए पूल (crates/net/src/pool.rs) को पट्टियों (stripes) में बाँटा गया है: 16 सॉकेट की 16 पट्टियाँ, हर पट्टी अपनी अलग cache line पर एक Mutex<Vec<Arc<TcpStream>>>। पहले उपयोग पर हर थ्रेड को round robin से एक मूल पट्टी (home stripe) मिलती है, वह पहले उसी में देता और उसी से लेता है, और नया कनेक्शन बनाने से पहले, किसी पकड़े हुए लॉक की प्रतीक्षा किए बिना, दूसरी पट्टियों में देखता है।
pub fn take(&self) -> Option<Arc<TcpStream>> {
    if self.is_stopping() {
        return None;
    }
    let home = home_stripe();
    if let Some(socket) =
        self.stripe(home).and_then(|stripe| lock(&stripe.sockets).pop())
    {
        return Some(socket);
    }
    (1..STRIPES).find_map(|offset| {
        let stripe = self.stripe((home + offset) % STRIPES)?;
        try_lock(&stripe.sockets)?.pop()
    })
}
पूल का कोई सॉकेट निष्क्रिय रहते समय ऑरिजिन द्वारा बंद किया जा चुका हो सकता है। प्रॉक्सी इसे दो में से एक तरह से पहचानता है, विफल राइट या पहले रिस्पॉन्स बाइट से पहले end-of-stream, और दोनों स्थितियों में क्लाइंट तक अभी कुछ नहीं पहुँचा होता, इसलिए वह सॉकेट बंद करता है और एक नए कनेक्शन पर एक बार रीट्राई करता है, कभी पूल के किसी दूसरे सॉकेट पर नहीं: निष्क्रिय अवधि के बाद पूल का हर सॉकेट पुराना पड़ चुका हो सकता है, और इस रीट्राई का पहला संस्करण, जो पूल का दूसरा सॉकेट लेता था, हर शांत अवधि के बाद पहले अनुरोध को 502 उत्तर देता था। रीट्राई केवल सुरक्षित मेथड (GET, HEAD, OPTIONS) के लिए अनुमत है जिसकी बॉडी पूरी तरह बफ़र हुई हो। उत्तर न मिलना इस बात का साक्ष्य नहीं कि ऑरिजिन ने कोई परिवर्तन कमिट नहीं किया, और टुकड़ों में रिले की गई बॉडी दोबारा नहीं भेजी जा सकती; दोनों स्थितियों में क्लाइंट को 502 मिलता है।
let safe = matches!(request.method, Method::Get | Method::Head | Method::Options);
let buffered = exchange.upload.is_buffered(request.body.len());
let retryable = safe && buffered;
for attempt in 0..2 {
    // रीट्राई हमेशा नया कनेक्शन बनाता है: निष्क्रिय अवधि के बाद पूल का हर
    // सॉकेट पुराना पड़ चुका हो सकता है, और दूसरा पुराना सॉकेट अनुरोध विफल कर देगा।
    let pooled = if attempt == 0 { pool.take() } else { None };
    // ... पूल में कुछ न हो तो कनेक्ट करें, activity से जोड़ें, एक्सचेंज करें
    match outcome {
        Ok(relayed) => {
            if relayed.origin_reusable {
                pool.give(origin);
            }
            return Ok(relayed.client_keep && buffered);
        }
        Err(error) => {
            drop(origin);
            let stale = was_pooled
                && retryable
                && matches!(
                    error,
                    ProxyError::UpstreamClosed | ProxyError::UpstreamWriteFailed
                );
            // ... बाकी हर त्रुटि तुरंत रिपोर्ट होती है
        }
    }
}
यूनिट परीक्षण निश्चित बाइट स्ट्रिंग को इन्हीं फ़ंक्शन से रिले करते हैं और पुष्टि करते हैं कि कनेक्शन हेडर को छोड़कर आउटपुट byte-identical है (crates/net/src/relay/tests.rs)। डेमन का एक end-to-end परीक्षण एक क्लाइंट सॉकेट पर दो प्रॉक्सी अनुरोध भेजता है और स्टब ऑरिजिन द्वारा जोड़े गए एक क्रम हेडर से जाँचता है कि दूसरे ने पूल का ऑरिजिन कनेक्शन दोबारा उपयोग किया। crates/net/tests/ में एक vector परीक्षण दर्ज किए गए प्रॉक्सी परिदृश्यों (एक कच्चा क्लाइंट अनुरोध और एक पहले से तैयार ऑरिजिन रिस्पॉन्स) को दोबारा चलाता है और ऑरिजिन तथा क्लाइंट को मिलने वाले हर बाइट की तुलना करता है।
निष्क्रियता की समय-सीमाएँ
हर क्लाइंट कनेक्शन अपना सॉकेट एक IdleTable (crates/net/src/idle.rs) में पंजीकृत करता है और एक Lease पाता है। lease का Activity वह समय रखता है जब कनेक्शन पर पिछली बार बाइट चले। डेमन हर सर्व किए गए अनुरोध के बाद इसे छूता है; प्रॉक्सी हर ऑरिजिन रीड पर और अपलोड के हर 16 KiB पर इसे छूता है, और चल रहे एक्सचेंज का ऑरिजिन सॉकेट इससे जोड़ता है। रीपर थ्रेड सबसे छोटे टाइमआउट के हर चौथाई पर (200 ms और एक सेकंड के बीच) जागता है और अपने टाइमआउट से अधिक समय तक चुप रहे हर कनेक्शन को, जुड़े हुए ऑरिजिन सॉकेट के साथ, बंद कर देता है, ताकि किसी भी ओर अवरुद्ध थ्रेड end of stream देखे और अपना स्लॉट छोड़ दे।
इसलिए समय-सीमाएँ चुप्पी को मापती हैं, रिस्पॉन्स की लंबाई को कभी नहीं: चलता रहने वाला बड़ा डाउनलोड कभी नहीं कटता। अपलोड के बाइट अविश्वसनीय पक्ष से आते हैं और केवल हर 16 KiB पर stamp को ताज़ा करते हैं, जो क्लाइंट से हर निष्क्रिय अवधि में कम से कम 16 KiB माँगता है; यह न्यूनतम-दर वाले अनुरोध टाइमआउट की slow-body रक्षा है।
टेबल में प्रति स्लॉट एक छोटा लॉक है और पूरी टेबल पर कोई लॉक नहीं। यह हर क्लाइंट सॉकेट का एक try_clone और हर जुड़े ऑरिजिन सॉकेट का एक Arc रखती है, ऊपर बताए गए कारण से। Lease अपने कनेक्शन को Drop में अपंजीकृत करता है, और रीप किया गया स्लॉट तब तक अपने lease का ही रहता है, इसलिए कोई पुराना कनेक्शन कभी वह स्लॉट नहीं छोड़ सकता जिसे किसी नए ने ले लिया हो।
अपग्रेड किए गए कनेक्शन
सत्यापित 101 के बाद WebSocket अपग्रेड दोनों दिशाओं में रिले होता है। हर दिशा एक निश्चित बफ़र के साथ अपने अलग थ्रेड पर चलती है: कनेक्शन का अपना थ्रेड ऑरिजिन से क्लाइंट की ओर के बाइट ले जाता है, और 128 KiB स्टैक वाला एक scoped थ्रेड क्लाइंट से ऑरिजिन की ओर के बाइट ले जाता है। एक थ्रेड poll(2) से दोनों दिशाओं की सेवा कर सकता था, लेकिन Rust की standard library इसे उपलब्ध नहीं कराती; सॉकेट टाइमआउट वाले दो थ्रेड रिले को unsafe से मुक्त रखते हैं। इसलिए अपग्रेड किया गया कनेक्शन दो थ्रेड रखता है, और जब हर कनेक्शन अपग्रेड हो तो कनेक्शन थ्रेड की संख्या --max-connections की दोगुनी तक पहुँच सकती है।
दोनों दिशाएँ एक निष्क्रियता समय-सीमा साझा करती हैं (--websocket-idle-timeout, डिफ़ॉल्ट 300 सेकंड): किसी भी ओर चलने वाले बाइट एक stamp को ताज़ा करते हैं। हर सॉकेट प्रतीक्षा बचे हुए समय के बराबर टाइमआउट रखती है; टाइमआउट होने वाली प्रतीक्षा साझा stamp को दोबारा पढ़ती है और या तो शेष समय के लिए फिर प्रतीक्षा करती है या रिले समाप्त कर देती है। जब एक दिशा end of stream पर पहुँचती है, तो दूसरे सॉकेट की भेजने वाली ओर बंद कर दी जाती है (half close); जब कोई दिशा विफल होती है, तो दोनों सॉकेट बंद कर दिए जाते हैं ताकि दूसरी दिशा भी समाप्त हो। अपग्रेड प्रॉक्सी होने से पहले कनेक्शन अपना cache किया गया नीति इंजन छोड़ देता है, ताकि घंटों तक चल सकने वाला कनेक्शन किसी पुराने इंजन को जीवित न रखे।
रोकना
Running::stop, और इसी तरह Running का Drop, डेमन को एक निश्चित क्रम में रोकता है। यह stopping फ़्लैग सेट करता है और listener से जुड़कर हर accept वर्कर को जगाता है, वर्करों को join करता है, हर पंजीकृत क्लाइंट सॉकेट और उससे जुड़े ऑरिजिन सॉकेट को बंद करता है (IdleTable::shutdown), ऑरिजिन पूल को रोकता है, हर कनेक्शन थ्रेड को join करता है, रीपर को join करता है, और पूल के सॉकेट बंद करता है।
SIGINT और SIGTERM साधारण Rust के ज़रिए इस क्रम तक पहुँचते हैं। कोई भी थ्रेड शुरू करने से पहले डेमन दोनों सिग्नल को ब्लॉक कर देता है (बाद का हर थ्रेड यह mask विरासत में पाता है) और एक थ्रेड को sigwait के लिए समर्पित करता है, जो अनुरोध दर्ज करता है और मुख्य थ्रेड को तुरंत जगाता है। किसी signal handler में कोई कोड नहीं चलता, और कोई थ्रेड किसी फ़्लैग को बार-बार नहीं जाँचता। signal मॉड्यूल (cmd/sibuna/src/signals.rs) में डेमन का एकमात्र unsafe कोड है: उन कुछ C library फ़ंक्शन की घोषणाएँ जिन्हें std रैप नहीं करता।
हमने क्या मापा
तालिका एक Ryzen 9 5950X पर रिवर्स-प्रॉक्सी मोड में Shield को दिखाती है: डेमन चार CPU पर पिन किया गया, wrk दो थ्रेड और 64 कनेक्शन के साथ आठ अन्य CPU पर, पाँच-सेकंड के रन, तीन की माध्यिका। पंक्तियाँ benchmarks/results/product-latest.md से कॉपी की गई हैं; पूरा रिकॉर्ड भाग VIII में है।
| वर्कलोड | स्टेटस | req/s | p50 / p99 (us) | प्रति अनुरोध CPU (us) |
|---|---|---|---|---|
| सत्र के साथ स्वीकृत, प्रॉक्सी किया गया | 200 | 138,965 | 438 / 857 | 28.57 |
| चैलेंज किया गया (इंटरस्टिशियल) | 200 | 195,188 | 162 / 328 | 13.73 |
| स्टैटिक अनुमत, प्रॉक्सी किया गया | 200 | 145,673 | 415 / 746 | 27.27 |
| WAF द्वारा अस्वीकृत (सत्र के साथ) | 403 | 209,507 | 151 / 306 | 12.17 |
wrk 64 अनुरोध एक साथ चलते रखता है, इसलिए CPU पर निर्भर प्रॉक्सी पाथ पर अनुरोध चार CPU के लिए कतार में लगते हैं, और वहाँ का p99 एक अनुरोध की लागत नहीं बल्कि शेड्यूलर की टेल है। इसके बजाय open-loop जनरेटर, जो एक निश्चित दर से भेजता है और हर अनुरोध का समय उसके इच्छित भेजने के क्षण से मापता है, समान प्रस्तावित लोड पर लेटेंसी मापता है। रिवर्स-प्रॉक्सी मोड में स्वीकृत अनुरोधों के लिए p99 प्रति सेकंड 10,000 अनुरोधों पर 65 us और 100,000 पर 100 us है; 150,000 प्रस्तावित पर चार CPU संतृप्त हो जाते हैं, प्रति सेकंड 134,344 अनुरोध प्राप्त होते हैं, और कतार सेकंडों तक बढ़ जाती है (benchmarks/results/latency-latest.md)। warm keep-alive कनेक्शन हर निर्णय हीप आवंटन के बिना सर्व करता है: cmd/sibuna/tests/steady_state.rs डेमन के आवंटन गिनता है, और crates/net/tests/steady_state.rs 500 प्रॉक्सी किए गए keep-alive अनुरोधों में कोई आवंटन नहीं पाता।
आवंटन के बिना समवर्ती अवस्था
sibuna-store का हर स्टोर अपनी निश्चित क्षमता एक बार, बनते समय, आवंटित करता है, और उसके बाद न कभी आवंटन करता है और न किसी वैश्विक लॉक पर रुकता है। किसी को बैकग्राउंड sweeper की ज़रूरत नहीं: समाप्त हुई अवस्था उसी स्थान पर वापस ली जाती है।
लॉक और शार्डिंग
Sibuna की टेबल के critical section दसियों निर्देश लंबे हैं, कर्नेल futex के round trip से कहीं छोटे। टेबल को कुंजी हैश से 16 शार्ड में बाँटा गया है, इसलिए दो ऑपरेशन \(1/16\) प्रायिकता से होड़ करते हैं, और हर शार्ड अपनी अलग cache line पर है, इसलिए पड़ोसी लॉक false sharing नहीं करते।
टेबल std::sync::Mutex का उपयोग करती हैं: होड़ न होने पर एक compare-and-swap, धारक के चलते समय थोड़ा spin, फिर futex प्रतीक्षा। विकल्प एक दो-अवस्था वाला atomic spin lock है जिसके प्रतीक्षा लूप में spin-loop hint हो। SID 0010 ने हमसे मापन के आधार पर इन दोनों में से चुनने को कहा। spin lock होड़-रहित ऑपरेशन पर लगभग एक नैनोसेकंड बचाता है, लेकिन होड़ में हार जाता है:
| वर्कलोड | Mutex |
Spin lock |
|---|---|---|
| spent set, 16 थ्रेड | 10.8 M/s | 8.6 M/s |
| spent set, 64 थ्रेड (CPU से अधिक) | 11.2 M/s | 6.9 M/s |
| छह व्यस्त पतों पर GCRA, 16 थ्रेड | 44.9 M/s | 19.3 M/s |
| छह व्यस्त पतों पर GCRA, 64 थ्रेड | 37.4 M/s | 6.5 M/s |
edge सर्वर CPU से अधिक कनेक्शन थ्रेड चलाता है, और जिस spin lock का धारक preempt हो जाए वह हर प्रतीक्षक से उसका time slice जलवाता है, इसलिए हम mutex रखते हैं। poisoned लॉक में प्रवेश किया जाता है, उसे आगे नहीं बढ़ाया जाता: कोई ऑपरेशन शार्ड पकड़े हुए panic नहीं करता, और यदि करे भी तो शार्ड संरचनात्मक रूप से वैध रहता है।
Robin Hood spent set
केवल स्वीकृत प्रमाण spent set में आते हैं (भाग III)। इसके 16 शार्ड हैं, हर एक Option<Entry> के 4,096 स्लॉट की open-addressed ऐरे, जहाँ एक प्रविष्टि { tag: [u8; 16], expires_at: u64, dist: u8 } है। Robin Hood insertion (Celis, 1986) हर उस निवासी को हटा देता है जो आने वाली कुंजी की तुलना में अपने घर (home) के अधिक निकट है, जिससे probe की लंबाइयाँ एक-दूसरे के पास बनी रहती हैं; लुकअप जैसे ही ऐसी प्रविष्टि से मिलता है जो अपने घर के उससे अधिक निकट है जितनी खोजी जा रही कुंजी अपने घर के, वह वहीं रुक जाता है।
fn insert(
    &mut self,
    tag: &Tag,
    expires_at: u64,
    now: u64,
) -> Result<(), SpendError> {
    if !self.can_insert(tag, now) {
        return Err(SpendError::Full);
    }
    let mut carry = Entry { tag: *tag, expires_at, dist: 0 };
    let mut idx = Self::home(tag);
    while carry.dist < MAX_PROBE {
        let slot = &mut self.entries[idx];
        let Some(e) = slot else {
            *slot = Some(carry);
            return Ok(());
        };
        // समाप्त निवासी को अधिलेखित करना तभी सुरक्षित है जब नई दूरी
        // छोटी न हो, ताकि इस स्लॉट से आगे probe करने वाली कुंजियाँ
        // early-termination जाँच में फिर भी पास हों।
        if e.is_expired(now) && carry.dist >= e.dist {
            *e = carry;
            return Ok(());
        }
        if carry.dist > e.dist {
            std::mem::swap(&mut carry, e);
            // हटाई गई समाप्त प्रविष्टि बस छोड़ दी जाती है।
            if carry.is_expired(now) {
                return Ok(());
            }
        }
        idx = (idx + 1) % SHARD_CAPACITY;
        carry.dist += 1;
    }
    Err(SpendError::Full)
}
समाप्त-स्लॉट वाला नियम सूक्ष्म भाग है: समाप्त प्रविष्टि को उसी स्थान पर केवल ऐसी कुंजी अधिलेखित कर सकती है जो अपने घर से कम से कम उतनी ही दूर हो, अन्यथा उस स्लॉट से आगे probe करने वाली कोई बाद की कुंजी जल्दी रुक जाएगी और खो जाएगी। हटाई गई समाप्त प्रविष्टियाँ बस छोड़ दी जाती हैं। किसी sweeper थ्रेड की ज़रूरत नहीं। प्रविष्टि पहले कुछ भी बदले बिना विस्थापन पाथ का अनुकरण करती है (can_insert) और जाँचती है कि सीमित विस्थापन किसी जीवित टैग को खोए बिना सफल हो सकता है।
एक स्लॉट Option<Entry> है। खाली स्लॉट में पढ़ने के लिए कोई टैग नहीं होता, इसलिए कोई occupied फ़्लैग नहीं है जिसे जाँचना कोई पाठक भूल सके, और match तब तक कंपाइल नहीं होगा जब तक दोनों स्थितियाँ संभाली न जाएँ। त्रुटि का प्रकार भी उतना ही सटीक है: spent set दो तरह से विफल हो सकता है (DoubleSpend और Full), और SpendError ठीक इन्हीं के नाम देता है।
GCRA: एक पूर्णांक में रेट लिमिटिंग
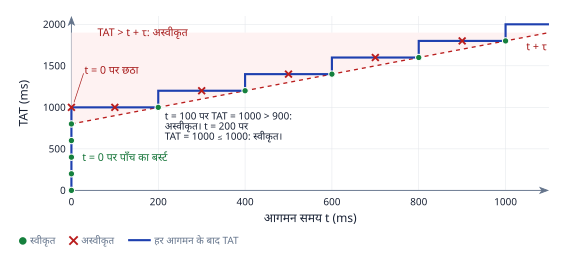
Generic Cell Rate Algorithm (ATM Forum, 1996) leaky bucket का virtual-scheduling रूप है। प्रति क्लाइंट यह एक सैद्धांतिक आगमन समय (TAT) संग्रहीत करता है। प्रति विंडो \(W\) धनात्मक सीमा \(N\) के लिए उत्सर्जन अंतराल \(T = \max(1, \lceil W / N \rceil)\) और बर्स्ट टॉलरेंस \(\tau = (N - 1) T\) के साथ:
fn arrive(
    cells: &mut [Cell; SLOTS_PER_SHARD],
    key: u64,
    now_ms: u64,
    limits: Limits,
) -> Decision {
    let interval = limits.emission_interval();
    let tau = limits.burst_tolerance();
    let Some(cell) = locate(cells, key, now_ms, tau) else {
        return Decision {
            limited: true,
            capacity_exhausted: true,
            retry_after_ms: interval,
            remaining: 0,
        };
    };
    let tat = cell.tat_ms.max(now_ms);
    let horizon = now_ms.saturating_add(tau);
    if tat > horizon {
        return Decision {
            limited: true,
            capacity_exhausted: false,
            retry_after_ms: tat - tau - now_ms,
            remaining: 0,
        };
    }
    cell.tat_ms = tat.saturating_add(interval);
    // ... remaining = min(rate, floor((t + tau - TAT) / T) + 1)
}
शार्ड का check लॉक लेता है और लॉक की गई सेल के साथ arrive को कॉल करता है; check लौटने पर guard लॉक छोड़ देता है। सेल 16 बाइट की हैं (एक कुंजी और एक TAT), 512 स्लॉट के 16 शार्ड में, 16 स्लॉट की probe विंडो के साथ, कुल लगभग 128 KiB। जिस सेल का TAT \(t - \tau\) से पुराना है, वह खाली हो चुकी है और तुरंत वापस ली जाती है। Retry-After हेडर उसी अंकगणित से निकाला जाता है। भरी हुई probe विंडो सक्रिय कोटा अवस्था को हटाने के बजाय नए क्लाइंट को अस्वीकार करती हैं, और निर्णय यह बताता है (capacity_exhausted), ताकि कॉल करने वाला क्षमता-जनित अस्वीकृति को प्रतिबंध में न बदले। शून्य पर कॉन्फ़िगर की गई दर अनुरोधों को अस्वीकार करती है। एक लिमिटर कई नियमों की सेवा करता है: सेल कुंजी नियम के scope से seed किया गया क्लाइंट पते का Wyhash है, इसलिए अलग-अलग scope में एक ही क्लाइंट के स्वतंत्र बजट होते हैं।
संस्करण वाली बैन टेबल
प्रतिबंध atomic संस्करण, कुंजी और समाप्ति फ़ील्ड वाले 4,096 स्लॉट उपयोग करते हैं, जो प्रतिबंधित पते के कुंजी-युक्त हैश से 8 स्लॉट की probe विंडो के साथ open-addressed हैं। एक writer, जो एक mutex द्वारा दूसरे writers के साथ क्रम में लगाया जाता है, हर अपडेट को संस्करण वृद्धियों के बीच रखता है; पाठक कोई लॉक नहीं लेते, केवल एक स्थिर सम (even) संस्करण स्वीकार करते हैं, और समवर्ती बदलावों पर दोबारा प्रयास करते हैं।
pub fn ban(&self, banned: &[u8], until: u64, now: u64) {
    let key = slot_key(banned);
    let _writers = self.lock_writers();
    let victim = &self.slots[self.victim(key, now)];
    // कुंजी और समाप्ति एक तार्किक मान हैं: बदलाव को विषम संस्करण के बीच
    // रखें, ताकि पाठक पुरानी कुंजी को अगली कुंजी की समाप्ति के साथ
    // न जोड़ सकें।
    victim.version.fetch_add(1, Ordering::SeqCst);
    victim.until.store(until, Ordering::SeqCst);
    victim.key.store(key, Ordering::SeqCst);
    victim.version.fetch_add(1, Ordering::SeqCst);
}

fn read_slot(&self, slot: &Slot) -> (u64, u64) {
    loop {
        let before = slot.version.load(Ordering::SeqCst);
        if before & 1 != 0 {
            std::hint::spin_loop();
            continue;
        }
        let key = slot.key.load(Ordering::SeqCst);
        let until = slot.until.load(Ordering::SeqCst);
        if before == slot.version.load(Ordering::SeqCst) {
            return (key, until);
        }
    }
}
अनुक्रमिक सुसंगतता (sequential consistency) पुरानी पहचान को नई समाप्ति के साथ मिलने से रोकती है: हर पहुँच एक कुल क्रम (total order) का हिस्सा है, जो तर्क को सरल रखता है। पाठक कोई mutex नहीं लेते, लेकिन किसी writer की प्रतीक्षा कर सकते हैं और wait-free नहीं हैं। इन atomic ऑपरेशन की वास्तविक लागत है, जिसे मुफ़्त मानने के बजाय HTTP हार्नेस में अप्रत्यक्ष रूप से मापा जाता है। भरी हुई probe विंडो किसी समाप्त हो चुके स्लॉट को, अन्यथा सबसे पहले समाप्त होने वाले स्लॉट को, अधिलेखित करती है। clear हर प्रतिबंध हटाता है लेकिन कुंजियों को उनकी जगह छोड़ देता है, क्योंकि खाली किया गया स्लॉट probe chain में आगे की किसी टकराने वाली कुंजी को छिपा सकता है।
MPSC घटना रिंग
जब Shield सतह किसी अनुरोध को अस्वीकार करती है या हनीपॉट सक्रिय होता है, तो घटना को लगभग 1.3 KB के एक निश्चित रिकॉर्ड में कॉपी किया जाता है (क्लाइंट पता, User-Agent, मेथड, पाथ, श्रेणी और पेलोड, हर एक अपनी क्षमता पर काटा गया) और एक सीमित multi-producer single-consumer रिंग पर push किया जाता है (Vyukov का sequence-stamped डिज़ाइन, 512 स्लॉट, BoundedQueue<IncidentRecord, 512>)। producer कनेक्शन थ्रेड हैं; consumer स्टोरेज थ्रेड है। भरी हुई रिंग रिस्पॉन्स को रोकने के बजाय सबसे नया रिकॉर्ड छोड़ देती है, यह टिकाऊपन की गारंटी नहीं बल्कि एक स्पष्ट हानि-नीति है। drop काउंटर उस हानि को दृश्य बनाता है।
/// `incident` को रिंग में कॉपी करता है; भरी हुई रिंग उसे छोड़ देती है और drop गिनती है।
pub(crate) fn record(&self, incident: &Incident<'_>) {
    if self.queue.push(IncidentRecord::from_incident(incident)).is_err() {
        self.metrics.incidents_dropped.bump();
    }
}
किसी रिकॉर्ड को लंबित बैच में ले जाने के बाद स्टोरेज थ्रेड उसे, तैयार पंक्तियों के साथ, कमिट की पुष्टि होने तक रखता है; वह डेटाबेस त्रुटि पर उसे चुपचाप नहीं फेंकता, और रीट्राई वही बैच लिखता है।
हर स्लॉट एक क्रम संख्या रखता है जो producers को बताती है कि स्लॉट मुक्त है या नहीं और consumer को बताती है कि वह भरा है या नहीं, इसलिए कोई भी पक्ष लॉक नहीं लेता। ऐसी रिंग safe Rust में नहीं लिखी जा सकती: producers और consumer एक ही ऐरे के अलग-अलग स्लॉट को एक ही समय छूते हैं, और कौन-सा थ्रेड कौन-सा स्लॉट छू सकता है, यह type system नहीं, केवल क्रम प्रोटोकॉल सिद्ध करता है। इसलिए मॉड्यूल crates/store/src/ring.rs अपने मान UnsafeCell<MaybeUninit<T>> स्लॉट में रखता है, और हर unsafe ब्लॉक प्रोटोकॉल के उस चरण का नाम देता है जो उसे उचित ठहराता है:
if diff == 0 {
    // Relaxed: CAS केवल यह तय करता है कि स्थिति `pos` किस producer की है।
    match self.tail.0.compare_exchange_weak(
        pos, pos.wrapping_add(1), Ordering::Relaxed, Ordering::Relaxed,
    ) {
        Ok(_) => {
            // SAFETY: CAS ने इस थ्रेड को स्थिति `pos` दी है, और
            // `sequence == pos` बताता है कि स्लॉट खाली है; कोई दूसरा producer
            // `pos` का दावा नहीं कर सकता, और consumer नीचे के Release store से
            // पहले उसे नहीं पढ़ता।
            unsafe { (*slot.value.get()).write(value) };
            // Release: लिखा गया मान consumer के लिए प्रकाशित करता है।
            slot.sequence.store(pos.wrapping_add(1), Ordering::Release);
            return Ok(());
        }
        Err(current) => pos = current,
    }
} else if diff < 0 {
    return Err(value);
}
रिंग की दो परिपाटियाँ प्रकार (type) हैं, टिप्पणी नहीं। भरी हुई रिंग पर push Err(value) लौटाता है, रिकॉर्ड वापस सौंपते हुए ताकि कॉल करने वाला तय करे कि उसे गिने या छोड़े; एक कोरा false उसे खो देता। रिंग का एक ही consumer है, और pop &mut self लेता है, और साझा कोड को पहले अद्वितीय Consumer पर दावा करना होता है, इसलिए दूसरा consumer या तो कंपाइल नहीं होता या रन टाइम पर अस्वीकार होता है।
इंजन का read-copy-update प्रकाशन
नीतियाँ बदलने पर नीति इंजन हॉट पाथ से बाहर दोबारा बनाया जाता है। अनुरोधों को कभी आधा बना इंजन नहीं दिखना चाहिए, और कोई इंजन तब कभी मुक्त नहीं होना चाहिए जब कोई अनुरोध उसे अभी पढ़ रहा हो। Sibuna हर इंजन को एक EngineSlot में Arc<Engine> के रूप में प्रकाशित करता है, और हर कनेक्शन उसे एक EngineCache के ज़रिए पढ़ता है:
pub struct EngineSlot {
    current: RwLock<Arc<Engine>>,
    generation: AtomicU64,
}

pub fn publish(&self, engine: Engine) {
    let fresh = Arc::new(engine);
    let previous = {
        let mut current =
            self.current.write().unwrap_or_else(PoisonError::into_inner);
        std::mem::replace(&mut *current, fresh)
    };
    self.generation.fetch_add(1, Ordering::Release);
    // पुराना इंजन लॉक के बाहर छोड़ा जाता है (जब यह उसका अंतिम धारक था)।
    drop(previous);
}

pub struct EngineCache {
    generation: u64,
    engine: Option<Arc<Engine>>,
}

pub fn refresh(&mut self, slot: &EngineSlot) -> &Engine {
    let generation = slot.generation();
    if self.generation != generation {
        // ऊपर के load और इस clone के बीच हुआ प्रकाशन नए इंजन पर पुरानी
        // generation लगा देता है; अगला refresh बस दोबारा लोड करता है।
        self.generation = generation;
        self.engine = None;
    }
    self.engine.get_or_insert_with(|| slot.load())
}
इंजन अपनी जगह रखे जाने के बाद generation को release ordering से संग्रहीत किया जाता है, और acquire ordering से लोड किया जाता है: जो पाठक नई generation देखता है, वह उससे पहले संग्रहीत इंजन भी देखता है। टिप्पणी में बताई गई race हानिरहित है। यदि कोई प्रकाशन किसी पाठक के generation load और उसके clone के बीच पड़ता है, तो पाठक नए इंजन को पुराने generation नंबर के तहत cache कर लेता है, और उसका अगला refresh असंगति पकड़कर दोबारा लोड करता है। एक पाठक एक अनुरोध के लिए एक इंजन पीछे हो सकता है; वह कभी आधा बना इंजन नहीं देख सकता, क्योंकि स्लॉट में केवल पूरे इंजन ही संग्रहीत होते हैं।
cache क्यों, केवल लॉक क्यों नहीं? SID 0010 ने हमसे 16 थ्रेड के साथ पढ़ने की लागत मापने और RwLock<Arc<Engine>> तथा safe Rust में एक lock-free विकल्प के बीच चुनने को कहा। लॉक के ज़रिए पढ़ने में lock word और reference count लिए जाते हैं, दो cache line जिन्हें हर कोर लिखता है। इसके विपरीत generation प्रति प्रकाशन एक बार लिखी जाती है और अन्यथा केवल पढ़ी जाती है, इसलिए हर कोर अपनी प्रति रखता है:
| पाठक | 1 थ्रेड | 16 थ्रेड |
|---|---|---|
केवल RwLock read guard |
4.2 ns | 752 ns |
RwLock read और Arc clone |
7.6 ns | 833 ns |
cache किए गए Arc के साथ generation जाँच |
0.8 ns | 1.8 ns |
होड़ में cache किया गया रीड लॉक से 400 गुना से अधिक सस्ता है, इसलिए अनुरोध पाथ cache का उपयोग करता है और RwLock का केवल refresh के धीमे पाथ पर। मापन cmd/sibuna/src/slot.rs में अनदेखा (ignored) परीक्षण read_cost_under_contention है। अनुरोध पाथ पर हर उपयोग refresh करता है, इसलिए अनुरोध उस चरण पर वर्तमान इंजन देखता है। इंजन स्वयं छोटा है: सघन हीप टेबल के 209,052 बाइट, लगभग 204 KiB (benchmarks/results/primitives-latest.json में engine_bytes), जिसमें 128 नियम, 128-बाइट नियम नाम और 8,192 trie नोड की क्षमता है।