第VIII部:実験による評価
コミット済みのハーネスで記録したSibunaの測定を示します。プリミティブのレイテンシー、外部の負荷生成器の下でCPUとメモリを計上した製品全体、オープンループの生成器による同じ負荷を与えたときのレイテンシー、そして広くデプロイされている作業証明のゲートであるAnubisとの比較です。ライブのダッシュボードを八つ動かしたコンソールの実行で記録を締めくくります。この部のすべての数値は、コミット済みの結果ファイル(各表がその生成時刻とともに示します)か、設計の記録から得たものです。機能の合格と性能の測定は別の問いに答えるもので、一つのホストでの測定は別のホストでの順位ではありません。
方法
ハーネスは一つのRustのツールtools/bench(バイナリsibuna-bench)のコマンドで、cargo xtask benchを通して実行します。別のツールがコンソールの実行を記録します。
| ハーネス | 測定するもの | 結果ファイル |
|---|---|---|
cargo xtask bench primitives |
一つのCPUでの16個のプリミティブのワークロードと、ハッシュ化したレートリミッターの経路の2行。7バッチ、操作あたりの中央値と最小・最大のばらつき | primitives-latest.json, primitives-latest.md |
cargo xtask bench product |
wrkの下でのデーモン全体。forward-authモードとリバースプロキシモードでのGateとShieldのスループット、レイテンシーのパーセンタイル、リクエストあたりのCPU時間、ピークの常駐メモリ |
product-latest.json, product-latest.md |
cargo xtask bench latency |
オープンループの生成器による、一定の負荷レートでの許可されたリクエストのレイテンシーのパーセンタイル | latency-latest.json, latency-latest.md |
cargo xtask bench product --anubis |
Anubisをさらに一つの製品として加えた製品全体のワークロード。caddy respondの背後 |
comparison-latest.json, comparison-latest.md |
cargo xtask bench admission --anubis |
forward-authモードでのSibunaとAnubisの毎秒の許可操作数。二つのkeep-aliveクライアントから | admission-latest.json, admission-latest.md |
sibuna-browser dashboards (tools/browser) |
コンソールの機能の実行。生成器がトラフィックを送る間、ヘッドレスChromiumで八つのライブのダッシュボードを動かす | console-8-dashboards-2026-10-15.md |
.mdファイルは要約です。.jsonファイルは、すべての繰り返し、マシン、リビジョン、測定したすべてのバイナリのパス、サイズ、SHA-256を保持します。履歴はGitが保持するので、ディレクトリには最新のファイルだけを置きます。一部のファイルは以前の版のハーネスで記録したもので、同じ実行で測定した二つ目のデーモンのビルドの行も含みます。この部ではSibunaの行を報告します。
プリミティブ
各ワークロードは、計時しない最大1,000操作のウォームアップの後、計時する7バッチで実行します。可変の状態(使用済み集合、レートリミッター)は、各バッチの前にタイマーの外で作り直します。タイマーは個々の操作ではなくバッチ全体を囲みます。操作ごとに時計を読むと、測定する100 ns未満の作業と同じだけのコストがかかるからです。そのため操作ごとのパーセンタイルは報告せず、ばらつきはバッチ間のものです。操作あたりの中央値のバッチを、最速と最遅のバッチと並べて報告します。
スイートは一つのCPUに固定した子プロセス(sibuna-bench primitives-run)で実行します。共有ホストでは、忙しいSMTの兄弟スレッドや低いクロックがスイートの実行全体を遅くするので、ツールはスイートを3回実行し(--rounds)、行ごとに中央値が最も小さいラウンドを残します。ラウンドの中の統計は上のとおりです。
製品全体
各モード(forward auth、リバースプロキシ)と各運用構成(Gate、Shield)について、ハーネスはデーモンをメモリ上で--algorithm hashcash --difficulty 8 --rate-limit 100000000 --idle-timeout 5と四つのワーカー(そのCPUセットのCPUごとに一つ)で起動します。ブラウザーと同じように、sibuna-powでデーモンのHashcashチャレンジを解いてセッションを得ます。その後wrkで、keep-alive接続を使って四つのワークロードを実行します。2スレッド、64接続、5秒、3回の繰り返しです。
admitted:有効なセッションCookie付きのGET /private。リバースプロキシモードではリクエストがオリジンに届き、その応答を中継します。forward-authモードではデーモン自身が200で応答します。challenged:Cookieのない同じリクエストを、ブラウザーのUser-Agentから送ります。デーモンはチャレンジを返します。リバースプロキシモードではHTML付きの200、forward-authモードでは401です。allowed_static:curl/8.0からのGET /robots.txt。どちらの運用構成もチャレンジなしで許可します。attack:有効なセッションにq=' OR 1=1--を加えたもの。拒否するのはShieldだけです(403)。Gateは許可し、リバースプロキシモードではオリジンに中継します。
オリジンはスタブ(sibuna-bench origin)です。標準ライブラリだけを使い、接続ごとに一つのスレッド、keep-alive、41バイトのページです。リクエストあたりのCPU時間は、実行中の/proc/<pid>/statから得たデーモンのユーザー時間とシステム時間(10 msのティック)を、wrkが数えたリクエスト数で割ったものです。オリジンのCPUは含みません。ピークメモリは/proc/<pid>/statusのVmHWMで、各実行の前に/proc/<pid>/clear_refsでリセットするので、各実行は自身のピークを報告します。どの数値も繰り返しの中央値で、最小値と最大値はJSONファイルに並べて残しています。
wrkはクローズドループの生成器で、64件のリクエストを処理中に保ちます。そのため速いデーモンほど多くのリクエストを受け取り、wrkのパーセンタイルは、遅い応答を待つ間に送らなかったリクエストを除外します(coordinated omission)。そのp99が示すのは、デーモン自身の飽和の下での振る舞いであり、ある負荷でのレイテンシーではありません。その問いにはレイテンシーのハーネスが答えます。
同じ負荷でのレイテンシー
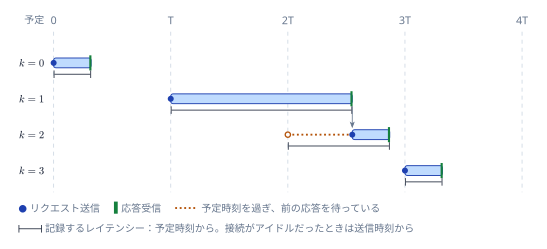
オープンループの生成器(sibuna-bench generate)は、接続ごとに一つのブロッキングスレッドを動かします。64個の接続はそれぞれ、セッション付きのGET /privateを決まった予定で送ります。接続のリクエスト\(k\)の予定時刻は\(t_0 + o + kT\)で、\(o\)は接続のオフセット、\(T\)はその間隔であり、それ以前の応答とは独立です。次のリクエストの予定時刻を過ぎてから応答が届いた場合、wrk2と同じく、そのリクエストはすぐに送られ、レイテンシーは予定時刻から数えます。予定時刻に接続がアイドルだった場合、レイテンシーは実際の送信時刻から数えるので、生成器自身のスリープの行き過ぎがデーモンに課されることはありません。
ハーネスは、Shieldの運用構成と許可のワークロードを五つの負荷レートで実行します。毎秒10,000、25,000、50,000、100,000、150,000リクエストで、それぞれ2秒のウォームアップ、10秒の測定、3回の実行です。ハーネスは一回の実行で二つのデーモンのビルドを測定できます。その場合、両方を同じCPUセットで起動し、レートと繰り返しのたびに交互に切り替え、アイドルの側はCPUを使いません。これにより、マシンのゆっくりした変動が両方に同じように影響します。記録した実行はそのようにしました。パーセンタイルは一回の実行で測定したすべてのリクエストに対する最近順位法によるもので、各数値は3回の実行の中央値で、p99の最小・最大を並べています。
CPUセット
CPUセットは他のどの設定よりも重要です。デーモンはCPU 0から3で動きます(--cpus。--workersはその集合の大きさです)。wrk、レイテンシーの生成器、オリジンはCPU 8から15で動きます(--load-cpus)。プリミティブのスイートはCPU 4で動きます(--cpu)。どのプロセスも開始前にtaskset -cで固定するので、プロセスが作るすべてのスレッドがその集合を継承します。許可のハーネスは、製品に二つのCPU(0と1)を、クライアントにCPU 8から15を使います。
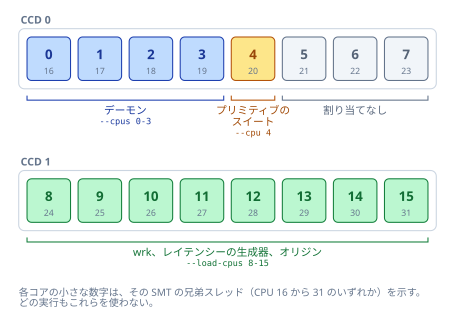
他のマシンでは、コアを共有しない集合を選びます(lscpu -eでトポロジーが分かります)。
マシンと条件
ファイルはpaxos-zigで記録しました。AMD Ryzen 9 5950X 16-Core Processor(論理CPU 32個)、Linux 7.0.0-28-generic x86_64、ブーストを有効にしたpowersaveガバナー、rustc 1.99.0です。プリミティブ、製品、レイテンシーのファイルは2026年10月15日に、Anubisとの比較は2026年10月16日に記録しました。デーモンはcargo build --release -p sibuna、つまりSQLiteストレージとコンソールを組み込んだ既定のビルドです(SID 0010)。製品とレイテンシーのファイルは49,113,856バイトのバイナリを示しています。各ファイルはリビジョン(プリミティブはefce14d、製品とレイテンシーの実行は249d913)をdirty: trueとともに記録しています。後者の作業ツリーには、SID 0002が記録する接続スレッドの再利用がすでに入っており、SID 0002はその効果についてlatency-latest.mdを引用しています。比較と許可のファイルはリビジョン54e4ec5をdirty: trueとともに示しています。作業ツリーにtools/benchのハーネスの追加があったからです。そのデーモンはそのリビジョンのリリースビルド(37,450,232バイト)です。1分間のロードアベレージは、比較の実行の前に3.53、許可の実行の終了時に0.56でした。
ファイルに記録された1分間のロードアベレージは、プリミティブの実行時に2.46、レイテンシーの実行の前に1.30、後に52.31、製品の実行の前に52.31、後に33.39です。高い数値はレイテンシーの生成器の64スレッドによるもので、製品の実行はその直後に行いました。
再現の方法
Linux、taskset(util-linux)、PATH上のwrkが必要です。
cargo xtask bench primitives
cargo xtask bench product
cargo xtask bench latency
cargo xtask bench help
cargo xtask benchはまずcargo build --release -p sibunaでデーモンをビルドし、次にリリースモードでsibuna-benchを実行します。ツールは自身のバイナリの隣にあるデーモンを見つけます。--rust <path>で上書きできます。cargo xtask bench helpはオプションを一覧表示します。その中には--cpus、--load-cpus、--cpu、--rounds、--repetitions、--seconds、--rates、--warmupがあります。Anubisとの比較を記録したコマンドは、後のAnubisの節に示します。
プリミティブのレイテンシー
表はプリミティブの実行のすべての行を示します。JSONファイルは各行をサブシステムとワークロードで名付けています(たとえばpow_verifyとhashcash_16_bits)。
| ワークロード | ns/op | 最小-最大 |
|---|---|---|
| Hashcashの検証(16ビット) | 70.2 | 69.9-71.0 |
| PoSWの検証(深さ13、t = 16) | 22272.4 | 22257.0-22316.4 |
| ボットのシグネチャ(40個、Aho-Corasick) | 55.7 | 55.3-57.2 |
| ボットのシグネチャ(40個、逐次探索) | 763.0 | 762.2-763.5 |
| IPv4 CIDRの検索 | 32.0 | 31.8-32.2 |
| IPv6 CIDRの検索 | 79.3 | 78.5-79.6 |
| セッショントークン(鍵付きBLAKE3) | 155.8 | 155.3-156.4 |
| セッショントークン(Ed25519) | 40587.5 | 40544.6-40631.1 |
| 使用済み集合(Robin Hood)、使用と検索 | 21.0 | 20.8-21.3 |
| レートリミッター(GCRA)、クライアントのバイト列 | 12.8 | 12.7-12.8 |
| レートリミッター、四つのルールのスコープ、クライアントのバイト列 | 13.1 | 13.0-13.2 |
| レートリミッター(GCRA)、ハッシュ化したクライアント | 6.2 | 6.1-6.3 |
| レートリミッター、四つのルールのスコープ、ハッシュ化したクライアント | 6.3 | 6.2-6.4 |
| HTTPのパースとCookie | 132.5 | 132.3-133.2 |
| 分類、Shieldのプロファイル | 790.8 | 787.2-793.1 |
| 分類、Gateのプロファイル | 75.9 | 75.6-76.1 |
| WAFのボディーの走査(8 KiB) | 12784.3 | 12771.5-12809.2 |
| WAFのボディーの走査(8 KiB)、SQLインジェクションを監査 | 15485.4 | 15460.9-15530.1 |
ばらつきは小さく、どの行のどのバッチも、その行の中央値から2.8%以上離れていません。図は同じ行を対数目盛で示すので、6 nsの行と40 usの行を並べても読み取れます。
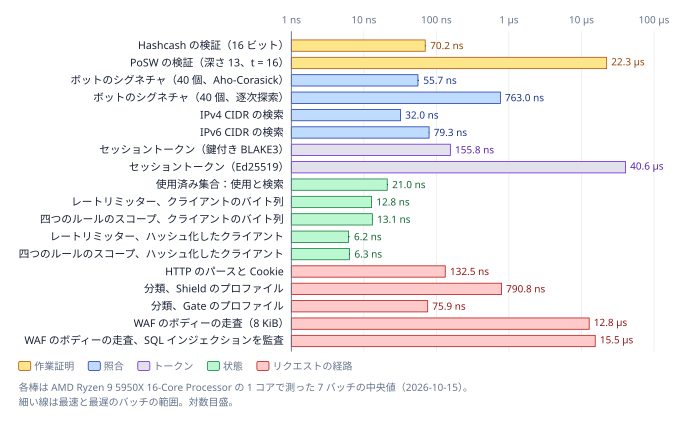
benchmarks/results/primitives-latest.jsonから描いています。¶作業証明の検証
Hashcashの検証は、チャレンジ、区切り文字、十進数のnonceをハッシュします。70.2 nsです。逐次作業の検証器はグラフの開示を確認します。22,272.4 nsです。入力の長さが異なるので、ハッシュの呼び出し回数とSHA-256の圧縮回数はHashcashとは異なります。どちらの行もSHA-256に律速され、sibuna-cryptoは、CPUにSHA-NI命令があれば実行時に検出して使います(SID 0010)。
照合
密なAho-Corasickオートマトンと逐次的な部分文字列探索は、同一のパターンと、いずれかに一致すればよいという意味論を使います。同じ40個のシグネチャで、オートマトンは逐次探索より13.7倍速く動きます(55.7 ns対763.0 ns)。その表は状態ごとに256列ではなくバイトクラスを使うので(SID 0006、Part F)、ボットのシグネチャの表は42,244バイトに収まります(後のフットプリントの表)。CIDRの分類器は32.0 ns(IPv4)と79.3 ns(IPv6)です。
トークン
BLAKE3のMACトークンは155.8 nsで検証できます。sibuna-cryptoはBLAKE3を移植可能な形で実装しており、SIMDの経路はありません。SIMDの経路は大きな入力で有利ですが、SibunaがBLAKE3でハッシュするのは100バイト未満の入力で、そこでは移植可能なコードで十分速いからです。Ed25519のコンパクトなトークンの検証は40,587.5 nsです。検証器は幅5と幅8のNAFの桁を使い、デコードした公開鍵を保持します。Ed25519の検証一回は、MACの検証約260回分のコストです。MACがSibunaの既定のトークン方式です。
状態
使用済み集合の行は、新しいタグを挿入して再び検索します。21.0 nsです。この行の表は4,096スロットのシャードが16個(65,536タグ。デーモンの既定は1,048,576)で、各バッチの前にタイマーの外でその場で空にします。したがって、どのバッチも常駐しているメモリを探査します。以前のスイートは、バッチごとにデーモンの既定サイズのゼロ初期化した新しい表を作っていました。それでは、最初の書き込みでカーネルが表のページを割り当てる時間を計っていました。これは稼働中のデーモンが一度だけ払うコストで、報告すべき行ではありません。
レートリミッターの行には注意が必要です。クライアントのバイト列の二つの行(gcra_checkとgcra_four_rule_scopes)は、バイト列のAPIを呼び出します。各確認はクライアントのアドレスをバイト列として受け取り、まずOSの乱数から引いた秘密の下で、その鍵付きSipHash-1-3を計算します。秘密鍵があるので、誰も被害者の探査窓を共有するアドレスを計算できません(SID 0010とsibuna-storeの文書)。これらの行は12.8 nsと13.1 nsです。
デーモンはリクエストの経路でバイト列のAPIを使いません。リクエストごとに一度クライアントをハッシュし(ClientHasher)、参照するすべての表にそのハッシュを渡します。ハッシュ化したクライアントの二つの行(gcra_check_hashedとgcra_four_rule_scopes_hashed)は、ループの前にハッシュを計算したうえで、その経路を測ります。確認あたり6.2 nsと6.3 nsです。バイト列とハッシュ化の行の中央値の差6.6 nsは、これらの入力での鍵付きハッシュのおよその代価で、デーモンはこれを表ごとではなくリクエストごとに一度払います。
HTTPパーサー
パーサーの行は、400バイトのブラウザーのリクエストをパースし、Cookieを一つ検索します。132.5 nsです。クレート自身の計時テストも一致します(crates/http:同じマシンで約135から180 ns)。パーサーはゼロコピーで、どのフィールドも接続のバッファーのスライスです。
ポリシーエンジン
ブラウザーのリクエストの完全な分類には790.8 ns、Gateのプロファイルでは75.9 nsかかります。これらの行では、リクエストのパース済みのクライアントアドレスを空にしているので、エンジンは評価の中でクライアントアドレスのテキストをパースします。デーモンは評価の前にリクエストごとに一度アドレスをパースするので、これらの行には、デーモンがエンジンの外で払う小さなコストが含まれています。エンジンのヒープ上の表は合計209,052バイトです(SID 0002)。
WAFの検査
8 KiBのボディーの意味解析の走査には12,784.3 ns、つまり1バイトあたり\(12784.3 / 8192 \approx 1.56\) nsかかります。二つ目の行は、SQLインジェクションのカテゴリーを監査、その他を強制にして同じボディーを走査します。15,485.4 nsです。いずれかのカテゴリーが強制ではなく監査のとき、各フィールドはカテゴリーごとに検査されます(SID 0004、"inspection modes")。エンジンはシグネチャのオートマトンでフィールドを一度走査して、シグネチャが現れるカテゴリーの集合を求め、その中から必要なカテゴリーだけを探します。そのため、一つのカテゴリーを監査するコストは、すべてを強制する場合の約5分の1増しで、カテゴリーごとに走査するわけではありません。
製品全体の比較
表は、各運用構成とワークロードについて、5秒のwrkの実行3回の中央値を示します。各ワークロードの横のステータスは、ハーネスが期待し、実際に受け取った応答です。
forward-authモード
イングレスがデーモンにリクエストを許可するかどうかを問い合わせます。オリジンもボディーの中継もないので、これが許可のコストの最も純粋な尺度です。
| 運用構成 | ワークロード(ステータス) | req/s | p50 | p90 | p99 | CPU us/req | ピークRSS KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
211,345 | 151 | 175 | 305 | 11.84 | 15912 |
| Gate | challenged (401) |
198,315 | 160 | 180 | 326 | 13.15 | 16176 |
| Gate | allowed_static (200) |
211,053 | 152 | 175 | 305 | 11.73 | 16176 |
| Gate | attack (200) |
211,618 | 151 | 176 | 305 | 11.84 | 16176 |
| Shield | admitted (200) |
208,101 | 152 | 178 | 308 | 12.87 | 15928 |
| Shield | challenged (401) |
197,532 | 161 | 183 | 327 | 13.77 | 16192 |
| Shield | allowed_static (200) |
211,636 | 151 | 175 | 305 | 11.78 | 16192 |
| Shield | attack (403) |
210,549 | 152 | 175 | 307 | 12.32 | 16192 |
forward-authモードでは、デーモンはボトルネックではありません。稼働中のコア数(実時間に対するCPU時間、JSONファイルのcores_busy_median)は、デーモンの四つのCPUのうち2.47から2.72にとどまり、どの行も毎秒197,532から211,636リクエストの間にあります。これは負荷生成器が上限であることを示しています。その上限の近くでは、行の間の数パーセントの差は実行ごとに入れ替わります。Gateのadmittedの行だけでも、3回の実行で毎秒205,151から211,513リクエストの幅があります。このモードでより有用な数値は、リクエストあたりのCPU時間です。11.73から13.77 usで、GateよりShieldのほうが少し多く、チャレンジの応答を描画するchallengedの行が最も多くなります。
リバースプロキシモード
デーモンはスタブのオリジンの前に置かれ、許可したリクエストと応答を中継します。そのためプロキシする行には、オリジン自身のコストと、ループバックの1ホップ分が加わります。
| 運用構成 | ワークロード(ステータス) | req/s | p50 | p90 | p99 | CPU us/req | ピークRSS KiB |
|---|---|---|---|---|---|---|---|
| Gate | admitted (200) |
142,498 | 427 | 548 | 768 | 27.68 | 15896 |
| Gate | challenged (200) |
199,465 | 160 | 181 | 324 | 12.98 | 16160 |
| Gate | allowed_static (200) |
147,303 | 411 | 541 | 759 | 26.88 | 16324 |
| Gate | attack (200) |
143,900 | 422 | 555 | 745 | 27.67 | 16348 |
| Shield | admitted (200) |
138,965 | 438 | 571 | 857 | 28.57 | 16064 |
| Shield | challenged (200) |
195,188 | 162 | 185 | 328 | 13.73 | 16328 |
| Shield | allowed_static (200) |
145,673 | 415 | 551 | 746 | 27.27 | 16328 |
| Shield | attack (403) |
209,507 | 151 | 177 | 306 | 12.17 | 16328 |
ここではプロキシする行(admitted、allowed_static、そしてGateが中継するGateのattack)はCPU律速で、稼働中のコア数は四つのうち3.96から3.98です。毎秒138,965から147,303リクエストを、リクエストあたり26.88から28.57 usのCPUで処理します。これはデーモン自身が返す応答の約2倍のコストです。challengedの行とShieldのattackの行はデーモン自身が応答するので、forward-authの行と似ています。飽和の下ではwrkのp99はデーモン自身の速度でのスケジューラーの裾なので、代わりに次の章の裾を読みます。
リバースプロキシの三つの行で、wrkは、想定していなかった2xxと3xx以外の応答を数えました。3回の実行の合計で、2,162,579リクエスト中3件(Gateのattack)、2,082,640中1件(Shieldのadmitted)、2,204,358中1件(Shieldのallowed_static)です。ファイルには、それがどのステータスだったかは記録されていません。デーモンのメトリクスを付けて実行を再現すると、sibuna_overloaded_totalに数えられた503の応答が見つかりました。wrkは64個の接続を一つのアドレスから開き、これは既定の--max-connections-per-ipとちょうど同じです。接続が4,096番目のリクエストの後で閉じられたとき、古い接続が枠を返す前にwrkが再接続していました。現在のデーモンは、閉じる応答を書く前に枠を返します(SID 0002、"bug fix")。表はこの修正より前のものです。
フットプリント
| 項目 | 値 |
|---|---|
| デーモンのバイナリ | 49,113,856バイト |
| アイドル時の常駐メモリ、製品の実行 | 5,592から5,788 KiB |
| ワークロード中のピークの常駐メモリ | 15,896から16,348 KiB |
| ワークロード後の常駐メモリ | 16,176から16,348 KiB |
| アイドル時の常駐メモリ、プリミティブの実行 | 6,052 KiB |
| ポリシーエンジンの表 | 209,052バイト(ヒープ) |
| ボットのシグネチャの表 | 42,244バイト(ヒープ) |
| WAFの表 | 164,908バイト(ヒープ) |
| ブラウザーのソルバーのモジュール(WebAssembly) | 14,744バイト |
範囲は四つの製品の実行(二つのモード、二つの運用構成)にわたるもので、ピークについてはその16個のワークロードにわたるものです。表のサイズはエンジンが報告するヒープのサイズです。記録にはバイナリのサイズの内訳はありません。
同じ負荷を与えたときのレイテンシー
どちらの表もcargo xtask bench latencyの一回の実行から得たものです。エラーの列は、生成器の接続、入出力、フレーミングのエラーを数えます。
| 負荷 req/s | 達成 req/s | p50 | p90 | p99(最小-最大) | p99.9 | max | エラー | CPU us/req |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 10,000 | 30 | 32 | 37 (36-39) | 58 | 355 | 0 | 16.92 |
| 25,000 | 25,000 | 28 | 31 | 34 (32-34) | 45 | 1035 | 0 | 15.83 |
| 50,000 | 50,000 | 25 | 27 | 30 (30-30) | 40 | 3029 | 0 | 13.83 |
| 100,000 | 99,998 | 24 | 26 | 41 (40-42) | 62 | 2358 | 0 | 13.48 |
| 150,000 | 149,996 | 25 | 36 | 51 (51-52) | 74 | 1753 | 0 | 14.16 |
| 負荷 req/s | 達成 req/s | p50 | p90 | p99(最小-最大) | p99.9 | max | エラー | CPU us/req |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 10,000 | 56 | 61 | 65 (65-66) | 76 | 555 | 0 | 32.25 |
| 25,000 | 25,000 | 51 | 54 | 58 (58-60) | 72 | 1105 | 0 | 28.63 |
| 50,000 | 50,000 | 47 | 50 | 60 (58-66) | 74 | 3066 | 0 | 27.45 |
| 100,000 | 99,996 | 55 | 75 | 100 (100-104) | 150 | 2239 | 0 | 28.42 |
| 150,000 | 134,344 | 583934 | 1544160 | 1906273 (1631234-2218760) | 1967134 | 1989964 | 4 | 29.22 |
forward-authモードでは、p50はどのレートでも24から30 usにとどまります。p99は毎秒150,000リクエストまで51 us以下、p99.9は74 us以下にとどまります。デーモンはリクエストあたり13.48から16.92 usのCPUを費やします。
リバースプロキシモードでは、毎秒100,000リクエストまでp50は47から56 usで、100,000でのp99は100 us、p99.9は150 usです。毎秒150,000リクエストではデーモンが飽和します。毎秒134,344リクエストを完了し、レイテンシーは秒単位まで伸びます。処理能力を超えたオープンループのテストでは、こうなるのが当然です。このレートは、前章のクローズドループでのプロキシのスループット(Shieldのadmittedで毎秒138,965リクエスト)に近い値です。その行の四つのエラーは過負荷の中で起きました。
飽和の手前ではp99のばらつきは小さく、最も大きいのは毎秒50,000リクエストでのリバースプロキシのp99で、58から66 usです。maxの列は、一回の実行での最大150万件のリクエストのうちの1件です。共有ホストでは、これをデーモンの性質ではなく、ホストの最悪の瞬間として読みます。
測定が変えたこと
外部からの負荷はSibunaの設計を変えました。デーモンは各接続を専用のスレッドで処理します(SID 0002、SID 0010)。最初のレイテンシーの実行では、wrkが示さなかった裾が見つかりました。64接続で、デーモンが4,096リクエストごとに各接続を閉じる場合、許可されたリクエストが毎秒100,000件のときの99.9パーセンタイルは0.3から2 msでした。
SID 0002とcmd/sibuna/src/tasks.rsの文書に記録した診断は、スレッドの入れ替わりです。スレッドの生成と終了では、シグナルスタックのマップとアンマップ、スタックのページの返却が起き、そのアドレス空間の変更がデーモンの他のスレッドを停滞させていました。一つの実験で決着しました。接続を一度も閉じない、つまり実行中にスレッドを一つも生成しないビルドでは、同じレートで54から60 usになったのです。修正では接続スレッドを再利用します。接続を終えたスレッドは待機して次の接続を引き受けるので、新しい接続が絶えず来てもスレッドは生成されません。10秒待機したスレッドは終了し、次の起動か、次にタスクを終えたスレッドがそれをjoinします。そのため、バーストの後にスタックがメモリに残り続けることはありません。接続がパニックしたスレッドは、待機せずに終了します。同時に処理する接続は、以前と同じく最大--max-connectionsです。
上の表は修正後の実行のものです。毎秒100,000リクエストでのp99.9は、forward-authモードで62 us、リバースプロキシモードで150 usです。修正前の実行は結果ファイルとして残していないので、その数値はSID 0002とこの節にだけ現れます。
SibunaとAnubis
TecharoのAnubisは、SibunaのGateと同じようにWebサイトの前に置く、広くデプロイされている作業証明のゲートです。Anubis v1.27.0の公式リリースバイナリ(anubis-1.27.0-linux-amd64、40,001,698バイト)を、同じホスト、同じCPU、同じワークロードでSibunaと並べて測定しました。二つの結果ファイルは次のコマンドで記録しました。
cargo xtask bench product --anubis <path/to/anubis>
cargo xtask bench admission --anubis <path/to/anubis>
Anubisは、このプロジェクトの以前のPythonのドライバーと同じように起動しました。--bind、--metrics-bind、--target=(forward-authモードでは空、リバースプロキシモードではオリジン)、--difficulty 2、--slog-level ERROR、--cookie-secure=false、そしてMozillaを含むすべてのUser-Agentにチャレンジし、DNSBLとハニーポットを無効にしたポリシーです。GOMAXPROCSはSibunaのワーカー数と等しく、どちらの製品のスレッドもすべて同じCPUセットに固定します。Hashcashの作業量はそろえています。Sibunaは8個のゼロビット、Anubisは16進数で2個のゼロで、期待ハッシュ回数はどちらも256回です。ハーネスは各製品のセッションをブラウザーと同じように得ます。Anubisでは、チャレンジのページを取得し、<script id="anubis_challenge">からチャレンジを読み、SHA-256(randomData || nonce)が00で始まるnonceを見つけ、ページの検証用Cookieとともにpass-challengeに渡します。forward-authモードでは、admittedとchallengedのワークロードはAnubisの確認エンドポイント(/.within.website/x/cmd/anubis/api/check)に問い合わせます。
製品全体のワークロード
四つのワークロード、負荷、統計は製品全体のハーネスと同じですが、一つ変更があります。オリジンは、以前のドライバーと同じく、負荷用のCPUに固定したcaddy respondです。Anubisのリバースプロキシの実行では何万ものソケットが残るので、ハーネスは毎回の実行の前に、TIME_WAITのソケットが3,000未満になるまで待ちます。
| ワークロード | 数値 | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s(ステータス) | 210,682 (200) | 208,635 (200) | 36,509 (200) |
| p99 us | 305 | 308 | 7,477 | |
| CPU us/req | 12.09 | 13.21 | 106.30 | |
| ピークRSS KiB | 16,228 | 16,316 | 32,624 | |
challenged |
req/s(ステータス) | 198,251 (401) | 193,087 (401) | 113,170 (401) |
| p99 us | 326 | 342 | 3,781 | |
| CPU us/req | 13.49 | 15.02 | 32.96 | |
| ピークRSS KiB | 16,240 | 16,328 | 32,696 | |
allowed_static |
req/s(ステータス) | 212,569 (200) | 212,444 (200) | 89,904 (200) |
| p99 us | 304 | 304 | 4,547 | |
| CPU us/req | 11.73 | 11.95 | 41.63 | |
| ピークRSS KiB | 16,240 | 16,328 | 33,396 | |
attack |
req/s(ステータス) | 212,086 (200) | 211,347 (403) | 36,853 (200) |
| p99 us | 305 | 306 | 7,283 | |
| CPU us/req | 12.07 | 12.56 | 104.88 | |
| ピークRSS KiB | 16,240 | 16,328 | 33,764 |
| ワークロード | 数値 | Sibuna Gate | Sibuna Shield | Anubis 1.27.0 |
|---|---|---|---|---|
admitted |
req/s(ステータス) | 106,376 (200) | 103,298 (200) | 19,398 (200) |
| p99 us | 3,331 | 3,321 | 11,062 | |
| CPU us/req | 27.02 | 27.92 | 190.40 | |
| ピークRSS KiB | 16,528 | 16,444 | 39,980 | |
challenged |
req/s(ステータス) | 198,402 (200) | 197,327 (200) | 28,842 (200) |
| p99 us | 325 | 328 | 9,546 | |
| CPU us/req | 13.05 | 13.78 | 137.73 | |
| ピークRSS KiB | 16,544 | 16,464 | 516,872 | |
allowed_static |
req/s(ステータス) | 105,427 (200) | 106,819 (200) | 28,862 (200) |
| p99 us | 3,320 | 3,316 | 30,124 | |
| CPU us/req | 26.24 | 26.52 | 135.41 | |
| ピークRSS KiB | 16,544 | 16,464 | 616,548 | |
attack |
req/s(ステータス) | 105,616 (200) | 210,483 (403) | 23,399 (200) |
| p99 us | 3,327 | 306 | 14,124 | |
| CPU us/req | 26.98 | 12.28 | 169.04 | |
| ピークRSS KiB | 16,544 | 16,464 | 599,516 |
forward-authモードでは、Sibunaは毎秒193,087から212,569リクエストをp99 304から342 usで処理し、Anubisは36,509(admitted)から113,170(challenged)をp99 3,781から7,477 usで処理しました。Sibunaの稼働中のコア数は四つのうち2.49から2.90にとどまったので、上限を決めたのは負荷生成器です。Anubisは3.73から3.88で、CPU律速でした。最も明確な数値はリクエストあたりのCPU時間です。許可されたリクエストのコストは、Sibuna Gateで12.09 us、Anubisで106.30 usでした。この差の一部はおそらくセッショントークンによるものです。Anubisは既定でEd25519でセッションに署名し、Sibunaは鍵付きBLAKE3のMAC(プリミティブの表で155.8 ns)を確認します。後の許可の測定では、HS512のトークンにするとAnubisのセッションの確認が半分以上増えており、この読みを支持しています。
リバースプロキシモードでは、Sibunaのプロキシする行は、稼働中のコア数2.77から2.98で毎秒103,298から106,819リクエストを処理しました。これはproduct-latest.jsonのスタブのオリジンでの138,965から147,303を下回り、デーモンはCPU律速ではないので、上限はデーモンの外にあります。オリジンのcaddy respondが負荷用のCPUをwrkと共有しているのです。その裾は2.1から2.4 msのp90に現れています。Anubisは稼働中のコア数3.68から3.97、リクエストあたりのCPU 135から190 usで、毎秒19,398から28,862リクエストを処理しました。その常駐メモリは、admittedのワークロードの39,980 KiBから、challengedで516,872 KiB、allowed_staticで616,548 KiBに増え、ワークロードの後もアイドル時の21,552 KiBに対して589,276 KiBを保持していました。増加はchallengedで始まりました。そこでは各リクエストが独自のIDを持つ新しいチャレンジを受け取ります。これは発行したチャレンジごとにレコードを保持していることを示唆しますが、ハーネスはその原因を確認していません。Sibunaのピークは、両方のモードのどの行でも16,228から16,544 KiBにとどまりました。
条件がそろっていない行もいくつかあります。
- forward-authモードでは、Anubisは
/robots.txtとattackのパスに、オリジンなしで自ら200で応答します。Sibunaは、そのモードでの他のリクエストと同じように応答します。 - Anubisにはリクエストの検査がないので、
attackのワークロードのSQLインジェクションを許可します。Shieldは、より多くの作業の後で403で拒否します。GateはAnubisと同じく許可します。 - 製品はセッションの署名方法が異なり(Anubisは既定でEd25519、Sibunaは鍵付きBLAKE3のMAC)、描画するチャレンジのページも異なります。
許可処理の操作
許可のハーネスは、許可を構成する四つの操作を、forward-authモードで、各製品に二つのCPUを与えて計時します(Sibunaのワーカーは二つ、GOMAXPROCS=2)。負荷用のCPU上の二つのクライアントスレッドが、それぞれ一つのkeep-alive接続を持ち、各バッチを分担します。バッチは200操作、検証については64個の証明で、バッチの前に用意します。7バッチの中央値を報告します。
- セッションの確認:有効なセッションでの確認エンドポイント(
200)。 - 未認証の確認:Cookieなしの同じ確認(
401)。 - チャレンジの開始:ブラウザーがチャレンジを始めるために取得するもの。Sibunaでは中間ページとチャレンジレコードの二つのリクエスト、Anubisではチャレンジを埋め込んだページの一つです。
- 証明の検証:操作ごとに一つの新しい証明。Sibunaの証明のチャレンジは25 ms間隔で発行します。これは適応的な難易度がビットを加え始める毎秒50件を下回るので、そろえた作業量が保たれます。Sibunaは
--challenge-rate-limit 100000000で実行するので、リミッターは確認されますが、使い果たされることはありません。
Anubisは、既定のEd25519のトークンと、--hs512-secretを指定した場合の2回実行しました。
| 製品(トークン) | セッションの確認 | 未認証の確認 | チャレンジの開始 | 証明の検証 | 実行後のRSS、KiB |
|---|---|---|---|---|---|
| Sibuna(鍵付きBLAKE3) | 88,104 | 78,997 | 42,664 | 57,924 | 7,792 |
| Anubis 1.27.0(Ed25519) | 10,951 | 28,619 | 7,893 | 12,668 | 33,400 |
| Anubis 1.27.0(HS512) | 16,976 | 27,785 | 7,952 | 19,261 | 29,840 |
7バッチの範囲はファイルにあります。Sibunaの範囲は中央値から11%以内に収まります。Anubisの範囲はより広く(Ed25519のトークンでの未認証の確認は25,394から32,741)、200操作のバッチは2から25 msしか続かないので、これらの数値は1割程度の精度で読みます。遅いほうのクライアントの操作あたりの時間が往復時間を表します。Sibunaのセッションの確認で22.7 us、AnubisのEd25519のトークンでの確認で182.5 us、HS512で117.7 usです。
上のどの行でも、AnubisがSibunaより多くのリクエストを処理したり、少ないCPUやメモリしか使わなかったりしたことはありません。これはこのホストでのこれらのワークロードについての記述であり、それ以上のものではありません。
コンソールのオーバーヘッド
SID 0007は、コンソールの分離に関する取り決めを定めています。コンソールを有効にしたときのコストは、データプレーンのスループットの最大1%、p99のレイテンシーの最大10%までです。測定は、構成のマトリクス(組み込まない、組み込むが無効、アイドル、ダッシュボード八つが稼働中)とワークロードについて、交互に繰り返す実行で行い、不確かさを報告します。決定的でない実行やノイズの多い実行では適合を示せず、プリミティブの基準値や簡易な確認の実行でこの判定の代わりにすることはできません。
SID 0010は一つの測定を記録しています。コンソールを組み込んだ場合、無効にした場合、ストレージのみの場合、有効でアイドルの場合のいずれでも、16個の製品のワークロードはコンソールなしでビルドしたデーモンの約1%以内に収まり、これはノイズの範囲内です。この記録は結果ファイルを示していません。負荷の下でダッシュボードを八つ稼働させた構成は測定していないので、SID 0007の正式な判定はまだ完了していません。
八つのダッシュボードの実行が確かめるのは、オーバーヘッドではなく機能です。sibuna-browser dashboardsは、一つのSQLiteノード上で、コンソール、四つのワーカー、そして/static/*、/about、/missing/*、/broken/*を許可し、それ以外にはすべてチャレンジするポリシーでリリースビルドのデーモンを起動しました。オリジンのフィクスチャは/missing/*に404、/broken/*に500で応答します。生成器は30秒間、毎秒200リクエストを送り、10個のパス(一つはSQLインジェクション)、三つのUser-Agent、500個の転送アドレスを順に使いました。各ダッシュボードは専用のChromiumで専用のセッションを持って動きました。ダッシュボード1から3は管理者のセッション、4から8は最初のダッシュボードが発行したコードで開いたウォールディスプレイです。コンソールは、アドレスごと、アカウントごとに毎分5回のサインインしか許さないからです。
| 項目 | 値 |
|---|---|
| データプレーンのリクエスト | 30.0秒で6,000件(毎秒200件、4スレッド、リクエストごとに一つの接続) |
| 応答あり | 6,000: 200 x 1,200, 401 x 3,000, 403 x 600, 404 x 600, 500 x 600 |
| エラー(応答なし) | 0 |
| レイテンシー p50 / p90 / p99 / max | 246 / 311 / 373 / 552 us(接続を含む) |
| 開始時のデーモンのVmRSS | 36,152 KiB |
| ダッシュボードを8つ開いたときのデーモンのVmRSS | 38,028 KiB |
| トラフィック後のデーモンのVmRSS | 41,496 KiB(VmHWM 41,496 KiB) |
タイルは、トラフィックの間は2秒ごとに、その後は3秒後に読みました。どのダッシュボードも同じ合計(Requests 6,000、Admitted 2,400、Challenged 3,000、Policy denied 600、Origin 4xx 600、Origin 5xx 600)で終わり、134から139個のstatsの差分を受け取り、WebSocketを開いたままにし、例外、コンソールのエラー、Content-Security-Policyの違反を一つも報告しませんでした。ブラウザーの購読者八つは、コンソールの上限64を大きく下回ります。この実行のデーモンは、製品のハーネスのメモリ上のデーモンと違ってSQLiteストレージとコンソールを持つので、その常駐メモリは製品のハーネスのものとは比較できません。
測定していないもの
| 対象 | ここで測定しない理由 | 代わりになるもの |
|---|---|---|
| SafeLineコミュニティ版9.x | Docker Composeのスタックとしてしか配布されていません。ホストにはDockerデーモンがなく、検出器のイメージはそこでコンパイルできるオープンソースのビルドではありません | 公表された、ベンダーが報告する事実(2026年9月に確認):検出率71.65%(balance)と76.17%(strict)、誤検知0.07%(balance)と0.22%(strict)。最小のホストはSSSE3付きのLinux x86_64またはarm64、CPU 1コア、RAM 1 GB、ディスク5 GB、Docker 20.10.14以降、Compose 2.0以降 |
| Cloudflare WAF | ホスト型のサービスです。ループバックでの測定はWAFではなくネットワークの経路を測ることになります | 公表されたプランごとの上限(2026年9月に確認):カスタムルールはFree 5、Pro 20、Business 100、Enterprise 1000。レート制限ルールはFree 1、Pro 2、Business 5、Enterprise 100 |
| 負荷の下のクラスター | 一つのPostgreSQLデータベースで複数のノードを動かすハーネスはまだありません | SID 0011が規定するプロトコルの性質(一つの共有シード、発行者に結び付いたチャレンジ)と、三つのノードによるその機能テスト(criterion 2)。測定はなし |
| リクエストの経路上のストレージ | どのハーネスでも、両方のデーモンはメモリ上で動きます | SID 0011:一つのストレージスレッドがすべてのSQLを所有し、リクエストの経路がそれを待つことはありません |
| TLS、WAN、本物のブラウザー | ハーネスはループバックとHTTPを使います。セッションは各ケースで一度だけsibuna-powで解きます |
なし。デプロイごとに自分の経路を測ります |
| ブラウザーのソルバーの解答時間 | ハーネスはネイティブのソルバーで8ビットで解きます | 上のモジュールのサイズ。ネイティブの所要時間がブラウザーでの解答時間の代わりにならない理由は第VII部で説明します |
| 割り当ての回数 | ハーネスはアロケーターを計装しません | 第V部の定常状態のテスト |
| 負荷の下でダッシュボードを八つ稼働させたときのコンソールの分離 | SID 0007の正式な判定はまだ実施していません | SID 0010の数値(コンソールがアイドルで約1%以内)と、上の機能の実行 |
この表の行は、製品の性能についての主張ではありません。SafeLine自身の数値はスループットではなく検出の質に関するもので、Cloudflareはリクエストあたりのコストではなくプランごとの上限を公表しています。Dockerホストがあれば、誰でも同じwrkのワークロードの背後でSafeLineを実行できます。