第V部:Rustによるゼロアロケーションのエンジニアリング
一つの固定バッファーを通して、接続を受け付けてから応答するまでを追います。また、多くの接続スレッドがリクエストの経路でヒープ割り当てをせずに状態を共有するための並行データ構造を調べます。メモリ安全性のために本来なら専用の仕組み(読み手のカウント、アリーナ、ディスクリプターの表、後始末の連鎖)が必要になる箇所では、Rustの所有権が代わりにそれを提供する様子を示します。
接続のループ
接続ごとに一つのスレッド、ただし上限付き
受付ワーカー(--workers、既定ではCPUごとに一つ、最大64)は待ち受けソケットを共有します。受け付けた接続はそれぞれ、1メガバイトのスタックを持つ専用のスレッドに渡され、受付ループはすぐにacceptに戻ります。接続を終えたスレッドは待機して次の接続を引き受けます。接続ごとにスレッドを生成して終了させると、他のスレッドが停滞したからです(第VIII部、SID 0002)。別の案である、受付スレッドで接続を最後まで処理する方式が最初の設計でした。クライアントが一つなら良い測定値でしたが、64では悪い値でした。そのうち60がワーカーの256リクエストの上限が終わるのを待ち、待つクライアントが増えるごとに裾のレイテンシーが伸びたからです。接続ごとにスレッドを持たせると、64接続でのp99は、製品全体のどのワークロードでも1ミリ秒未満、305 usから857 usに収まります(benchmarks/results/product-latest.md、第VIII部)。
接続スレッドの数は--max-connections(既定で1,024、最大8,192)で制限されます。上限を超えると、受付ループは新しいソケットに503 Service Unavailableで応答し、何も生成せずに閉じ、その事象をsibuna_overloaded_totalに数えます。
fn accept_loop(server: &Arc<Server>, listener: &TcpListener) {
    while !server.is_stopping() {
        let stream = match listener.accept() {
            Ok((stream, _)) => stream,
            // ... ディスクリプターかメモリが尽きた:スピンせずに1 ms待つ
        };
        let limit = server.max_connections.load(Ordering::Relaxed);
        if server.connections.fetch_add(1, Ordering::Relaxed) >= limit {
            server.connections.fetch_sub(1, Ordering::Relaxed);
            server.metrics.overloaded.bump();
            let text = "Service Unavailable: connection limit reached";
            reject(server, &stream, text);
            continue;
        }
        set_no_delay(&stream);
        let task_server = Arc::clone(server);
        let launched = server.tasks.launch(move || {
            let _counted = Counted(&task_server);
            crate::connection::serve(&task_server, &stream);
        });
        // ... 起動に失敗したら枠を返し、過負荷として数える
    }
}
Countedはガードで、そのDropは、スレッドが戻り値で終わってもパニックで終わっても、接続が上限の中で占めていた枠を返します。503の経路では、ソケットの自分の側を閉じる前に、クライアントがすでに送ったデータを読み捨てます。未読のバイトが残ったままソケットを閉じるとリセットで応答することになり、そのリセットは503を破棄してしまうからです。
スレッドはTaskPool(cmd/sibuna/src/tasks.rs)から取り出します。これはjoin可能なスロットの固定表です。終了したスレッドはjoinされるまでスタックを保持するので、スロットは再び取り出されるときにjoinされ、新しいタスクはカーソルを進めるのではなく、終了済みのスロットのうち最も小さいものを取ります。カーソルでは、表を一周した後でないと終了済みのスロットに戻らず、何千もの終了済みスレッドがメモリに残ります。そしてメモリは開いている接続の数ではなく、処理した接続の数に応じて増えてしまいます。二つ目のガードFinishedはタスクの終了時にスロットを空きとして記録するので、パニックした接続もスロットを解放します。
メモリも同じように上限を持ちます。接続スレッドは64 KiBの読み込みバッファーと16 KiBの書き込みバッファーをスタックに、40 KiBのプロキシ作業領域をヒープに持ち、作業領域は接続の開始時に一度だけ確保します。したがって最悪の場合は、クライアントが開けるソケットの数の関数ではなく、既知の数値になります。アイドル接続回収スレッド(後述)は送信をやめた接続を閉じるので、遅いクライアントが--idle-timeoutを超えてスレッドを占有することはできません。
アロケーターの選択
Rust 1.100 では Allocator API の中核と、Vec および Box のアロケーターパラメーターが安定化されました(リリースノート)。私たちはプロセスのアロケーターを置き換えずに、個々のコレクションのアロケーターを選べます。この API によってリクエスト経路の割り当てがさらに減るわけではありません。ウォームアップ後のリクエストはすでにメモリーを割り当てず、cmd/sibuna/tests/steady_state.rs と crates/net/tests/steady_state.rs で確認しています。プロキシは接続ごとに三つのバッファーを一度だけ割り当て、再利用します。レートリミッターと使用済み証明集合もテーブルを一度だけ割り当てます。ゼロ初期化された割り当てでは、未使用のページを常駐させずに済み、crates/store/tests/resident.rs で確認しています。
アロケーターの変更を調べる際には、まずポリシースナップショットの構築とコンソールの JSON 解析を測定します。一時的なコレクションはリクエスト経路の外でメモリーを割り当てますが、コレクションのアロケーターが要素の割り当てまで自動的に管理するわけではありません。JSON ツリーはエスケープを含む文字列も Cow<str> を通して所有し、その所有形式は String です。Rust 1.100 の String にはアロケーターパラメーターがありません。Arc::new_in もこのリリースでは不安定なままです(API ドキュメント)。公開したエンジンは最後の読み手が解放するまで Arc で共有されるため、再構築時に古いエンジンが使うメモリーをリセットできません。アリーナでも、この生存期間とパーサーの入力上限を維持する必要があります。
私たちはコンソールの WebAssembly モジュールにある既存のグローバルアロケーター WipeOnFree を cmd/console-ui/src/abi.rs に維持します。これは解放するブロックを消去し、再割り当て後の古いブロックも消去します。コレクションに System を直接選ぶと、この消去を迂回します。作業証明の WebAssembly モジュールにはヒープアロケーターがなく、Argon2 も呼び出し側が所有する作業領域をすでに再利用しています。そのため、測定した負荷が変更を正当化するまでは、既存のアロケーターと Rust 1.94 との互換性を維持します。候補は、消去、上限付きの入力処理、割り当てのないリクエスト経路を保ったうえで、レイテンシーか常駐メモリーを改善する必要があります。
接続ごとに一つのバッファー
リクエストの経路での動的なメモリ割り当ては、どれもサービス拒否のてこになります。何日もかけて進む断片化、スレッド間でのアロケーターのロック競合、割り当てを最大化するリクエストを作る攻撃者による増幅です。Sibunaの規則は絶対的です。分類、検証、プロキシへの受け渡しは、ヒープ割り当てなしで実行します。接続ハンドラーは、ソケットが生きている間、64 KiBの読み込みバッファーと16 KiBの書き込みバッファーを所有します。それ以外はすべて、それらを指すスライスです。
pub fn serve(server: &Server, stream: &TcpStream) {
    let Some(lease) = server.idle.register(stream) else { return };
    // ...
    let mut read_buffer = [0u8; MAX_REQUEST_BYTES]; // 64 KiB
    let mut write_buffer = [0u8; WRITE_BUFFER]; // 16 KiB
    let mut reader = Reader::new(stream, &mut read_buffer[..]);
    let mut peer = PeerText::default();
    peer.format(stream.peer_addr().ok());
    let mut link = Link {
        server,
        stream,
        writer: Writer::new(stream, &mut write_buffer[..]),
        workspace: Workspace::new(),
        cache: EngineCache::new(),
        activity: lease.activity(),
        last: false,
    };
    for served in 0..MAX_REQUESTS_PER_CONNECTION {
        link.last = served + 1 == MAX_REQUESTS_PER_CONNECTION;
        if !serve_one(&mut reader, &mut link, peer.as_bytes()) {
            break;
        }
        lease.touch();
    }
}
read_headは空行が現れるまでバッファーを満たします。探索するのは前回の探索以降に届いたバイトだけで、16 KiBを超えるヘッダー部は431で拒否します。parse_request(クレートsibuna-http)はRequest<'a>を生成します。そのメソッド、パス、クエリ、ヘッダー、Cookieはバッファーのスライスです。宣言されたボディーは収まる分まで読み込み、ヘッダー部の後ろをスライスします。その後reader.consume(head_len + body_len)がリーダーを進めるので、次のkeep-aliveリクエストはきれいに始まります。リーダーは、場所が必要なときだけ未読のバイトを先頭に移します。チャンク形式のボディーは、ヘッダー部の後ろでその場でデコードします(SID 0009)。各ステップのフレーミングをバッファーから切り取るので、デコードした先頭部分は検査のために連続したままです。内部ルートは長さで区切られ、接続を開いたままにします。プロキシしたリクエストも、オリジンの応答がフレーミングされていて、ボディーが完全にバッファーされていれば、接続を開いたままにします。プロキシがどう判断するかは次の節で示します。
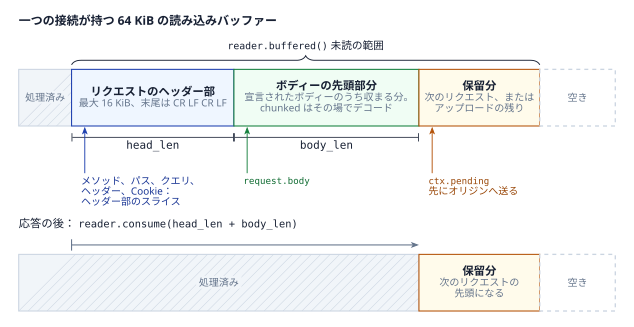
fn serve_one<W: Write>(
    reader: &mut Reader<'_, &TcpStream>,
    link: &mut Link<'_, W>,
    peer: &[u8],
) -> bool {
    let head_len = match read_head(reader) {
        Head::Complete(length) => length,
        Head::TooLarge => { /* 431 "Request head exceeds 16 KB" */ return false; }
        Head::Closed | Head::Failed => return false,
    };
    let framing = {
        let bytes = reader.buffered();
        let head = bytes.get(..head_len).unwrap_or_default();
        let request = match parse_request(head) {
            Ok(request) => request,
            Err(error) => return reject_head(link, error),
        };
        let declared = request.content_length().unwrap_or(0);
        // ... Expect: 100-continue
        if declared == 0 && !request.chunked {
            let upload = Upload::declared(&request);
            let pending = bytes.get(head_len..).unwrap_or_default();
            let keep = dispatch(link, request, pending, upload, 0, peer);
            reader.consume(head_len);
            return keep;
        }
        (declared, request.chunked)
    };
    serve_with_body(reader, link, peer, head_len, framing)
}
プロキシでのヘッダー部の書き換え
ヘッダー部はそのまま転送するのではありません。write_request_head(crates/net/src/request.rs、クレートsibuna-net)は、リクエスト行と各ヘッダーをオリジン向けのライターに出力し直します。その際、ホップごとのフィールド(Connection、Keep-Alive、Proxy-Connection、Transfer-Encoding、TE、Trailer、Upgrade、プロキシ認証のフィールド)、受信した転送用または監査用のフィールド(X-Forwarded-For、X-Real-IP、Forwarded、X-Forwarded-Proto、X-Forwarded-Host、X-Forwarded-Port、X-Sibuna-Status、X-Sibuna-Rule)、Expect、Content-Length、そしてリクエストのConnectionヘッダーが指名するすべてのフィールドを取り除きます。その後、監査用のフィールドの組を付け加えます。ボディーのフレーミングは生成するもので、コピーはしません。
for header in request.headers() {
    if is_hop_by_hop(header.name) || nominated(request, header.name) {
        continue;
    }
    out.write_all(header.name)?;
    out.write_all(b": ")?;
    out.write_all(header.value)?;
    out.write_all(b"\r\n")?;
}
match upload {
    Upload::None => {}
    Upload::Length(length) => {
        out.write_all(b"Content-Length: ")?;
        write_decimal(out, *length)?;
        out.write_all(b"\r\n")?;
    }
    Upload::Chunked(_) => out.write_all(b"Transfer-Encoding: chunked\r\n")?,
}
Content-Lengthは出力し直します。接続バッファーの中で終わるチャンク形式のボディーは、その場でデコードし、長さを付けて送ります。それより長いものはTransfer-Encoding: chunkedと告げ、一回の読み込みごとにチャンク化し直します(SID 0009)。各読み込みはプロキシの16 KiBのアップロードバッファーに入り、そこでその場でデコードされ、正規の一つのチャンクとして送り出されます。そのため、オリジンがクライアントのチャンクサイズ、拡張、トレーラーを見ることはありません。監査用のフィールドの組は次のとおりです。
Connection: keep-alive
X-Forwarded-For: <client>
X-Forwarded-Proto: <scheme>
X-Real-IP: <client>
X-Sibuna-Status: PASS
X-Sibuna-Rule: session | robots-txt | ip/cidr-trie | ...
バッファーより大きいボディーは、応答をストリームで返す前に、クライアントからオリジン向けのライターへ16 KiBずつ中継します(relay_body)。crates/net/src/request.rsの単体テストproxy_head_rewrite_drops_hop_by_hop_headers_and_injects_audit_fieldsは、書き換えが偽装されたX-Forwarded-Forを取り除き、監査用のフィールドを挿入することを確認します。
プロキシの三つのバッファー、つまりオリジンの読み込みバッファー(応答のヘッダー部一つ、16 KiB)、オリジンの書き込みバッファー(8 KiB)、アップロードバッファー(16 KiB)は、接続が一度だけ確保してすべてのリクエストで再利用するWorkspaceにあります。作業領域によって、それらの寿命は一回のやり取りではなく接続の寿命になり、オリジンのリーダーとライターは一回のやり取りの間だけそれらを借用します。
オリジンの応答の中継
最初のプロキシは、オリジンが閉じるまでオリジンのバイトをストリームし、その後クライアントを閉じていました。パースなしで正しくフレーミングできますが、プロキシするリクエストごとに新しいTCP接続が必要になります。負荷生成器の下では、その代償がTIME_WAITにある何万ものソケットとして現れ、ループバックではエフェメラルポートを使い果たしました。現在のプロキシはオリジンのヘッダー部(最大16 KiB)を読み、RFC 9112の規則でボディーを分類します。
pub enum Framing { None, Length(u64), Chunked, UntilClose }

pub fn parse_response_head(
    head: &[u8],
    head_request: bool,
) -> Option<ResponseHead> {
    let status = status_code(head)?;
    let mut fields = FramingFields {
        keep_alive: head.get(7) == Some(&b'1'),
        ..Default::default()
    };
    for line in crlf_lines(head).skip(1) {
        if line.is_empty() {
            break;
        }
        fields.read_line(line)?; // Transfer-Encoding, Content-Length, Connection
    }
    let mut framing = fields.length.map_or(Framing::UntilClose, Framing::Length);
    if head_request || status / 100 == 1 || status == 204 || status == 304 {
        framing = Framing::None;
    } else if fields.encoded {
        framing =
            if fields.chunked { Framing::Chunked } else { Framing::UntilClose };
    }
    let mut keep_alive = fields.keep_alive;
    if framing == Framing::UntilClose || fields.closing {
        keep_alive = false;
    }
    if fields.nominates_framing {
        return None;
    }
    Some(ResponseHead { status, framing, keep_alive })
}
パーサーは、プロキシが中継してはならないものを拒否します。不正なステータス行、トークンでないフィールド名、値の中の制御バイト、矛盾する長さ、繰り返された、または最後でないchunkedコーディング、Content-LengthやTransfer-Encodingを指名するConnectionフィールドです。その作業量はヘッダー部の長さに比例し、決してパニックしません。
ヘッダー部は、オリジンのConnectionヘッダーをSibuna自身の判断で置き換えたうえでクライアントに出力し直し、ボディーは正確に中継します。長さがあればcopy_exact、chunkedコーディングならチャンクごと(サイズ行、データ、トレーラー)、旧来の場合はcopy_remainingです。クライアントを閉じるのは旧来の場合だけです。どの中継も一つのコピー手順の上に作られています。送り元がすでに持っているものは何でも転送し、何も持っていないときだけ宛先をフラッシュしてから一回読み込みます。そのため小さな書き込みの流れは生成されたとおりに届き、大量転送では読み書きのたびにバッファー一杯分が動きます。
let keep = client_keep_alive && parsed.framing != Framing::UntilClose;
write_client_head(client, head, keep).map_err(client_head_error)?;
origin.consume(head_length);
match parsed.framing {
    Framing::None => {}
    Framing::Length(length) => copy_exact(origin, client, length, progress)?,
    Framing::Chunked => relay_chunked(origin, client, progress)?,
    Framing::UntilClose => copy_remaining(origin, client, progress)?,
}
client.flush().map_err(|_| ProxyError::ClientFailed)?;
Ok(Relayed { client_keep: keep, origin_reusable: parsed.keep_alive })
8フィールドのオリジンのヘッダー部のパースには322 ns、1 KiBの応答を返すkeep-aliveのGETをループバックでプロキシするには29.8 usかかります(2026年10月に測定。測定方法はcrates/net/src/lib.rsに記載しています)。
オリジンのプール
フレーミングをパースすると、オリジン側のソケットを再利用できるかどうかも分かります。Connection: closeのないHTTP/1.1の応答(またはkeep-aliveのあるHTTP/1.0の応答)で、ボディーを完全に読み切ったものは、ソケットをリクエストのきれいな境界に残します。そのようなソケットは256個のアイドルなオリジン接続からなる固定のプールに入り、次にプロキシするリクエストは新たに接続する代わりにそこから一つ取ります。プールがなければ、プロキシするリクエストごとに新しいオリジン接続を開き、閉じた接続はそれぞれローカルのポートをTIME_WAITで保持します。負荷の下では、ループバック上のプロキシはすぐにエフェメラルポートを使い果たし、スループットが崩壊します。
一つのロックで守るプールでは、プロキシするリクエストがすべてそのロックを奪い合うことになります。そこでプール(crates/net/src/pool.rs)はストライプに分けています。16ソケットのストライプが16個あり、各ストライプは専用のキャッシュラインに置いたMutex<Vec<Arc<TcpStream>>>です。スレッドは最初に使うときにラウンドロビンでホームのストライプを割り当てられ、まずそこにソケットを返したりそこから取ったりします。新たに接続する前には、保持されているロックを待たずに他のストライプも調べます。
pub fn take(&self) -> Option<Arc<TcpStream>> {
    if self.is_stopping() {
        return None;
    }
    let home = home_stripe();
    if let Some(socket) =
        self.stripe(home).and_then(|stripe| lock(&stripe.sockets).pop())
    {
        return Some(socket);
    }
    (1..STRIPES).find_map(|offset| {
        let stripe = self.stripe((home + offset) % STRIPES)?;
        try_lock(&stripe.sockets)?.pop()
    })
}
プールしたソケットは、アイドルの間にオリジンによって閉じられているかもしれません。プロキシは二つの方法のいずれかでそれに気づきます。書き込みの失敗か、応答の最初のバイトより前のストリームの終端です。どちらの場合もまだ何もクライアントに届いていないので、プロキシはソケットを閉じ、新しい接続で一回だけ再試行します。別のプールしたソケットでは再試行しません。アイドル期間の後ではプールしたソケットがすべて古くなっている可能性があり、二つ目のプールしたソケットを使っていたこの再試行の最初の版は、静かな期間の後の最初のリクエストに毎回502で応答していました。再試行が許されるのは、ボディーが完全にバッファーされた安全なメソッド(GET、HEAD、OPTIONS)だけです。応答がないことは、オリジンが変更をコミットしなかった証拠にはなりませんし、分割して中継したボディーを再送することもできません。どちらの場合もクライアントは502を受け取ります。
let safe = matches!(request.method, Method::Get | Method::Head | Method::Options);
let buffered = exchange.upload.is_buffered(request.body.len());
let retryable = safe && buffered;
for attempt in 0..2 {
    // 再試行では必ず新しく接続する。アイドル期間の後はプールのどのソケットも
    // 古くなっている可能性があり、二つ目も古ければリクエストが失敗するため。
    let pooled = if attempt == 0 { pool.take() } else { None };
    // ... プールが空なら接続し、アクティビティに結び付けて交換する
    match outcome {
        Ok(relayed) => {
            if relayed.origin_reusable {
                pool.give(origin);
            }
            return Ok(relayed.client_keep && buffered);
        }
        Err(error) => {
            drop(origin);
            let stale = was_pooled
                && retryable
                && matches!(
                    error,
                    ProxyError::UpstreamClosed | ProxyError::UpstreamWriteFailed
                );
            // ... それ以外はすぐに報告する
        }
    }
}
単体テストは固定したバイト列を同じ関数に通して中継し、出力が接続ヘッダーを除いてバイト単位で同一であることを確認します(crates/net/src/relay/tests.rs)。デーモンのエンドツーエンドテストは、一つのクライアントソケットでプロキシするリクエストを二つ送り、スタブのオリジンが付けるシーケンスヘッダーによって、二つ目がプールしたオリジン接続を再利用したことを確認します。crates/net/tests/のベクターテストは、記録したプロキシのシナリオ(生のクライアントのリクエストと、用意したオリジンの応答)を再生し、オリジンとクライアントが受け取るすべてのバイトを比較します。
アイドル期限
すべてのクライアント接続は、ソケットをIdleTable(crates/net/src/idle.rs)に登録し、Leaseを受け取ります。リースのActivityは、接続上でバイトが最後に動いた時刻を保持します。デーモンはリクエストを処理するたびにそれを更新し、プロキシはオリジンからの読み込みごとと、アップロードの16 KiBごとに更新し、進行中のやり取りのオリジンのソケットを関連付けます。回収スレッドは最短のタイムアウトの4分の1ごと(200 msから1秒の間)に起き、タイムアウトより長く無通信の接続を、関連付けたオリジンのソケットとともにすべてシャットダウンします。そのため、どちらの側でブロックしているスレッドもストリームの終端を見て、スロットを解放します。
したがって期限が測るのは無通信の時間であり、応答の長さではありません。動き続けている大きなダウンロードが切られることはありません。アップロードのバイトは信頼できない側から来るので、タイムスタンプを更新するのは16 KiBごとだけです。これはクライアントにアイドル期間ごとに少なくとも16 KiBを求めることになり、最低速度付きのリクエストタイムアウトによる、遅いボディーへの防御です。
この表はスロットごとに小さなロックを一つ持ち、表全体のロックはありません。上で述べた理由から、各クライアントソケットのtry_cloneと、関連付けた各オリジンソケットのArcを保持します。LeaseはDropで接続の登録を解除し、回収されたスロットはそのときまでリースが所有し続けます。そのため古い接続が、新しい接続が取ったスロットを解放してしまうことはありません。
アップグレードした接続
検証済みの101の後、WebSocketへのアップグレードは双方向に中継します。各方向は一つの固定バッファーを持つ専用のスレッドで動きます。接続自身のスレッドがオリジンからクライアントへのバイトを運び、128 KiBのスタックを持つスコープ付きスレッドがクライアントからオリジンへのバイトを運びます。poll(2)を使えば一つのスレッドで両方向を処理できますが、Rustの標準ライブラリはこれを公開していません。ソケットのタイムアウトを持つ二つのスレッドにすれば、中継からunsafeを排除できます。したがってアップグレードした接続は二つのスレッドを持ち、すべての接続がアップグレードされると、接続スレッドの数は--max-connectionsの2倍に達し得ます。
両方向は一つのアイドル期限(--websocket-idle-timeout、既定で300秒)を共有します。どちらの方向にバイトが動いても、一つのタイムスタンプが更新されます。ソケットの各待機には残り時間に等しいタイムアウトがあります。タイムアウトした待機は共有のタイムスタンプを読み直し、残りの時間だけ再び待つか、中継を終えます。一方の方向がストリームの終端に達すると、もう一方のソケットの送信側をシャットダウンします(ハーフクローズ)。ある方向が失敗すると、両方のソケットをシャットダウンし、もう一方の方向も終わらせます。アップグレードをプロキシする前に、接続はキャッシュしたポリシーエンジンを手放します。何時間も生き得る接続が古いエンジンを生かし続けないようにするためです。
停止
Running::stopと、同様にRunningのDropは、決まった順序でデーモンを停止します。停止フラグを立て、リスナーに接続してすべての受付ワーカーを起こし、ワーカーをjoinし、登録されたすべてのクライアントソケットと関連付けたオリジンソケットをシャットダウンし(IdleTable::shutdown)、オリジンのプールを停止し、すべての接続スレッドをjoinし、回収スレッドをjoinし、プールしたソケットを閉じます。
SIGINTとSIGTERMは、普通のRustのコードでこの手順に届きます。デーモンは、スレッドを一つも生成しないうちに両方のシグナルをブロックし(後のスレッドはすべてこのマスクを継承します)、一つのスレッドをsigwait専用にします。このスレッドは要求を記録し、すぐにメインスレッドを起こします。シグナルハンドラーの中で動くコードはなく、フラグをポーリングするスレッドもありません。シグナルのモジュール(cmd/sibuna/src/signals.rs)にはデーモンで唯一のunsafeコードがあります。stdがラップしていない、いくつかのCライブラリ関数の宣言です。
測定したこと
この表は、Ryzen 9 5950X一台でのリバースプロキシモードのShieldを示します。デーモンを四つのCPUに固定し、wrkを他の八つのCPUで2スレッド、64接続で動かし、5秒の実行を3回行った中央値です。行はbenchmarks/results/product-latest.mdから写したもので、完全な記録は第VIII部にあります。
| ワークロード | ステータス | req/s | p50 / p99 (us) | リクエストあたりのCPU (us) |
|---|---|---|---|---|
| セッションありで許可、プロキシ | 200 | 138,965 | 438 / 857 | 28.57 |
| チャレンジ(中間ページ) | 200 | 195,188 | 162 / 328 | 13.73 |
| 静的な許可、プロキシ | 200 | 145,673 | 415 / 746 | 27.27 |
| WAFで拒否(セッションあり) | 403 | 209,507 | 151 / 306 | 12.17 |
wrkは64件のリクエストを処理中に保つので、CPU律速のプロキシの経路ではリクエストが四つのCPUを待って列を作り、そこでのp99はリクエスト一件のコストではなくスケジューラーの裾です。オープンループの生成器は、一定の速度で送信し、各リクエストを本来の送信時刻から計時するので、同じ負荷を与えたときのレイテンシーを測れます。リバースプロキシモードの許可されたリクエストでは、p99は毎秒10,000リクエストで65 us、100,000で100 usです。与える負荷150,000では四つのCPUが飽和し、達成されるのは毎秒134,344リクエストで、キューは秒単位まで伸びます(benchmarks/results/latency-latest.md)。温まったkeep-alive接続は、どの判断もヒープ割り当てなしで処理します。cmd/sibuna/tests/steady_state.rsはデーモンの割り当てを数え、crates/net/tests/steady_state.rsは、プロキシした500件のkeep-aliveリクエストで割り当てがゼロであることを確かめます。
割り当てを行わない並行状態
sibuna-storeのどのストアも、構築時に固定の容量を一度だけ確保し、その後はメモリを確保することも、グローバルなロックでブロックすることもありません。バックグラウンドで掃除するスレッドも必要ありません。期限切れの状態はその場で回収されます。
ロックとシャーディング
Sibunaの表のクリティカルセクションは数十命令の長さで、カーネルのfutexの往復よりはるかに短いものです。表はキーのハッシュで16個のシャードに分かれているので、二つの操作が競合する確率は\(1/16\)です。各シャードは専用のキャッシュラインに置かれるので、隣り合うロックが偽共有を起こすこともありません。
表はstd::sync::Mutexを使います。競合がなければcompare-and-swap一回、保持者が動いている間は短いスピン、その後futexで待機します。別の案は、待機ループでスピンループのヒントを使う二状態のアトミックなスピンロックです。SID 0010は、両者を測定で選ぶよう求めました。スピンロックは競合のない操作あたり約1ナノ秒節約しますが、競合の下では負けます。
| ワークロード | Mutex |
スピンロック |
|---|---|---|
| 使用済み集合、16スレッド | 10.8 M/s | 8.6 M/s |
| 使用済み集合、64スレッド(CPU数より多い) | 11.2 M/s | 6.9 M/s |
| 六つの集中するアドレスでのGCRA、16スレッド | 44.9 M/s | 19.3 M/s |
| 六つの集中するアドレスでのGCRA、64スレッド | 37.4 M/s | 6.5 M/s |
エッジサーバーはCPUより多くの接続スレッドを動かします。保持者がプリエンプトされたスピンロックでは、待機者全員がタイムスライスを空費するので、ミューテックスを使い続けます。ポイズンされたロックはエラーを伝播させずにそのまま入ります。シャードを保持している間にパニックする操作はなく、仮にパニックしてもシャードは構造的に正しいままです。
Robin Hood使用済み集合
使用済み集合に入るのは受理された証明だけです(第III部)。16個のシャードを持ち、各シャードはOption<Entry>の4,096スロットからなるオープンアドレス法の配列です。項目は{ tag: [u8; 16], expires_at: u64, dist: u8 }です。Robin Hood挿入(Celis、1986)は、入ってくるキーよりもホーム位置に近い占有者を押しのけるので、探査長がきつくまとまります。検索は、自分のホーム位置からの距離よりもホーム位置に近い項目に出会った時点で止まります。
fn insert(
    &mut self,
    tag: &Tag,
    expires_at: u64,
    now: u64,
) -> Result<(), SpendError> {
    if !self.can_insert(tag, now) {
        return Err(SpendError::Full);
    }
    let mut carry = Entry { tag: *tag, expires_at, dist: 0 };
    let mut idx = Self::home(tag);
    while carry.dist < MAX_PROBE {
        let slot = &mut self.entries[idx];
        let Some(e) = slot else {
            *slot = Some(carry);
            return Ok(());
        };
        // 期限切れの占有者を上書きしてよいのは、新しい距離が小さくない場合だけ。
        // そうすれば、このスロットを越えて探索するキーも早期終了の判定を
        // 引き続き通過する。
        if e.is_expired(now) && carry.dist >= e.dist {
            *e = carry;
            return Ok(());
        }
        if carry.dist > e.dist {
            std::mem::swap(&mut carry, e);
            // 押し出された期限切れのエントリーは単に捨てる。
            if carry.is_expired(now) {
                return Ok(());
            }
        }
        idx = (idx + 1) % SHARD_CAPACITY;
        carry.dist += 1;
    }
    Err(SpendError::Full)
}
微妙なのは期限切れのスロットの規則です。期限切れの項目をその場で上書きできるのは、ホーム位置からの距離が少なくとも同じだけあるキーだけです。そうしないと、そのスロットを越えて探査する後のキーが早く止まってしまい、見失われます。押しのけられた期限切れの項目は単に捨てられます。掃除のスレッドは必要ありません。挿入ではまず、何も変更せずに押しのけの経路をシミュレートし(can_insert)、有効なタグを失わずに上限内の押しのけで成功できることを確認します。
スロットはOption<Entry>です。空のスロットには読むべきタグがないので、読み手が確認を忘れ得るoccupiedフラグはなく、両方の場合を扱うまでmatchはコンパイルできません。エラー型も同じく正確です。使用済み集合が失敗する仕方は二つ(DoubleSpendとFull)で、SpendErrorはちょうどそれらを名指しします。
GCRA:一つの整数によるレート制限
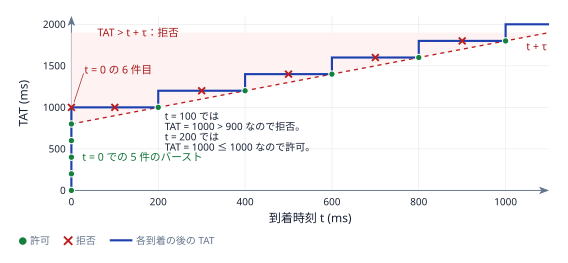
Generic Cell Rate Algorithm(ATM Forum、1996)は、リーキーバケットの仮想スケジューリング形式です。クライアントごとに一つの理論到着時刻(TAT)を保存します。窓\(W\)あたりの正の上限\(N\)に対して、送出間隔を\(T = \max(1, \lceil W / N \rceil)\)、バースト許容量を\(\tau = (N - 1) T\)とすると、
fn arrive(
    cells: &mut [Cell; SLOTS_PER_SHARD],
    key: u64,
    now_ms: u64,
    limits: Limits,
) -> Decision {
    let interval = limits.emission_interval();
    let tau = limits.burst_tolerance();
    let Some(cell) = locate(cells, key, now_ms, tau) else {
        return Decision {
            limited: true,
            capacity_exhausted: true,
            retry_after_ms: interval,
            remaining: 0,
        };
    };
    let tat = cell.tat_ms.max(now_ms);
    let horizon = now_ms.saturating_add(tau);
    if tat > horizon {
        return Decision {
            limited: true,
            capacity_exhausted: false,
            retry_after_ms: tat - tau - now_ms,
            remaining: 0,
        };
    }
    cell.tat_ms = tat.saturating_add(interval);
    // ... remaining = min(rate, floor((t + tau - TAT) / T) + 1)
}
シャードのcheckはロックを取り、ロックしたセルを渡してarriveを呼び出します。ガードはcheckが戻るときにロックを解放します。セルは16バイト(キーとTAT)で、16スロットの探査窓を持つ512スロットのシャードが16個、全体で約128 KiBです。TATが\(t - \tau\)より古いセルは空になっており、その場で回収されます。Retry-Afterヘッダーも同じ算術で計算します。探査窓が飽和すると、有効なクォータの状態を追い出すのではなく新しいクライアントを拒否し、判定もそのことを示します(capacity_exhausted)。そのため呼び出し側は、飽和による拒否を禁止へと格上げしません。設定したレートがゼロなら、リクエストを拒否します。一つのリミッターが複数のルールに使われます。セルのキーはルールのスコープをシードにしたクライアントアドレスのWyhashなので、異なるスコープの同じクライアントは独立した予算を持ちます。
バージョン付きの禁止テーブル
禁止には、アトミックなバージョン、キー、期限のフィールドを持つ4,096個のスロットを使います。禁止したアドレスの鍵付きハッシュでオープンアドレス法により配置し、探査窓は8スロットです。書き手は他の書き手とミューテックスで直列化され、各更新をバージョンの増加で挟みます。読み手はロックを取らず、安定した偶数のバージョンだけを受け入れ、並行する変更があれば再試行します。
pub fn ban(&self, banned: &[u8], until: u64, now: u64) {
    let key = slot_key(banned);
    let _writers = self.lock_writers();
    let victim = &self.slots[self.victim(key, now)];
    // キーと期限は論理的に一つの値。置き換えを奇数のバージョンで挟み、
    // 読み手が古いキーと次のキーの期限を組み合わせられないようにする。
    victim.version.fetch_add(1, Ordering::SeqCst);
    victim.until.store(until, Ordering::SeqCst);
    victim.key.store(key, Ordering::SeqCst);
    victim.version.fetch_add(1, Ordering::SeqCst);
}

fn read_slot(&self, slot: &Slot) -> (u64, u64) {
    loop {
        let before = slot.version.load(Ordering::SeqCst);
        if before & 1 != 0 {
            std::hint::spin_loop();
            continue;
        }
        let key = slot.key.load(Ordering::SeqCst);
        let until = slot.until.load(Ordering::SeqCst);
        if before == slot.version.load(Ordering::SeqCst) {
            return (key, until);
        }
    }
}
逐次一貫性によって、古い識別子と置き換え後の期限が混ざることを防ぎます。すべてのアクセスが一つの全順序に属するので、議論が単純になります。読み手はミューテックスを取りませんが、書き手を待つことがあり、ウェイトフリーではありません。これらのアトミック操作には実際のコストがあり、無償と仮定するのではなく、HTTPのハーネスで間接的に測定しています。探査窓が満杯なら、期限切れのスロットを、なければ最も早く期限が切れるスロットを上書きします。clearはすべての禁止を解除しますが、キーはその場に残します。空にしたスロットが、探査の連鎖の先にある衝突したキーを隠してしまい得るからです。
MPSCインシデントリング
Shieldの運用構成がリクエストを拒否したり、ハニーポットが反応したりすると、インシデントは約1.3 KBの固定のレコード(クライアントのアドレス、User-Agent、メソッド、パス、カテゴリー、ペイロードで、それぞれ容量で切り詰めます)にコピーされ、上限のある複数生産者・単一消費者のリング(Vyukovのシーケンス番号付きの設計、512スロット、BoundedQueue<IncidentRecord, 512>)に積まれます。生産者は接続スレッドで、消費者はストレージスレッドです。リングが満杯なら、応答をブロックするのではなく最も新しいレコードを捨てます。これは永続性の保証ではなく、明示的な損失のポリシーです。破棄のカウンターによって、その損失を観測できます。
/// `incident`をリングにコピーする。リングが満杯なら捨てて、その件数を数える。
pub(crate) fn record(&self, incident: &Incident<'_>) {
    if self.queue.push(IncidentRecord::from_incident(incident)).is_err() {
        self.metrics.incidents_dropped.bump();
    }
}
ストレージスレッドは、レコードを保留中のバッチに移した後、コミットが確認されるまで、用意した行とともにそれを保持します。データベースのエラーで黙って捨てることはなく、再試行では同一のバッチを書き込みます。
各スロットはシーケンス番号を持ち、それによって生産者はスロットが空いているかを、消費者はスロットが埋まっているかを知ります。そのため、どちらの側もロックを取りません。このようなリングは安全なRustでは書けません。生産者と消費者が一つの配列の異なるスロットに同時に触れ、どのスレッドがどのスロットに触れてよいかを証明するのは型システムではなくシーケンスのプロトコルだけだからです。そのためモジュールcrates/store/src/ring.rsは値をUnsafeCell<MaybeUninit<T>>のスロットに保持し、各unsafeブロックは、それを正当化するプロトコルの手順を名指しします。
if diff == 0 {
    // Relaxed:CASは、どの生産者が位置`pos`を持つかを決めるだけ。
    match self.tail.0.compare_exchange_weak(
        pos, pos.wrapping_add(1), Ordering::Relaxed, Ordering::Relaxed,
    ) {
        Ok(_) => {
            // SAFETY: CASによってこのスレッドが位置`pos`を得ており、
            // `sequence == pos`はスロットが空であることを示す。他の生産者は
            // `pos`を取得できず、消費者は下のReleaseストアより前には
            // これを読まない。
            unsafe { (*slot.value.get()).write(value) };
            // Release:書き込んだ値を消費者に公開する。
            slot.sequence.store(pos.wrapping_add(1), Ordering::Release);
            return Ok(());
        }
        Err(current) => pos = current,
    }
} else if diff < 0 {
    return Err(value);
}
リングの二つの約束事は、コメントではなく型になっています。リングが満杯のとき、pushはErr(value)を返してレコードを返却し、数えるか捨てるかを呼び出し側に決めさせます。単なるfalseではレコードが失われます。リングの消費者は一つで、popは&mut selfを取り、共有されたコードはまず唯一のConsumerを取得しなければなりません。そのため二つ目の消費者はコンパイルできないか、実行時に拒否されます。
read-copy-updateによるエンジンの公開
ポリシーが変わると、ポリシーエンジンはホットパスの外で再構築されます。リクエストが作りかけのエンジンを目にしてはならず、リクエストがまだ読んでいる間にエンジンが解放されてもなりません。Sibunaは各エンジンをEngineSlotの中のArc<Engine>として公開し、各接続はEngineCacheを通してそれを読みます。
pub struct EngineSlot {
    current: RwLock<Arc<Engine>>,
    generation: AtomicU64,
}

pub fn publish(&self, engine: Engine) {
    let fresh = Arc::new(engine);
    let previous = {
        let mut current =
            self.current.write().unwrap_or_else(PoisonError::into_inner);
        std::mem::replace(&mut *current, fresh)
    };
    self.generation.fetch_add(1, Ordering::Release);
    // 古いエンジンはロックの外で破棄する(これが最後の保持者だった場合)。
    drop(previous);
}

pub struct EngineCache {
    generation: u64,
    engine: Option<Arc<Engine>>,
}

pub fn refresh(&mut self, slot: &EngineSlot) -> &Engine {
    let generation = slot.generation();
    if self.generation != generation {
        // 上の読み込みとこのクローンの間に公開があると、新しいエンジンに古い世代の
        // ラベルが付く。次の更新で単に読み込み直せばよい。
        self.generation = generation;
        self.engine = None;
    }
    self.engine.get_or_insert_with(|| slot.load())
}
世代は、エンジンを配置した後にreleaseの順序付けで格納し、acquireの順序付けでロードします。新しい世代を見た読み手は、その前に格納されたエンジンも見ます。コメントで名指しした競合は無害です。読み手が世代をロードしてから複製するまでの間に公開が起きると、読み手は新しいエンジンを古い世代番号の下でキャッシュし、次の更新で不一致に気づいて再びロードします。読み手は一件のリクエストの間、エンジン一つ分遅れることがありますが、作りかけのエンジンを見ることは決してありません。スロットに格納されるのは完成したエンジンだけだからです。
なぜ単純なロックではなくキャッシュなのでしょうか。SID 0010は、16スレッドで読み込みのコストを測り、RwLock<Arc<Engine>>と安全なRustによるロックフリーの代替案のどちらかを選ぶよう求めました。ロック経由の読み込みは、ロックの語と参照カウントという、すべてのコアが書き込む二つのキャッシュラインに触れます。これに対し世代は、公開のたびに一度書かれるだけで、それ以外は読まれるだけなので、各コアが自分のコピーを保持できます。
| 読み手 | 1スレッド | 16スレッド |
|---|---|---|
RwLockの読み込みガードのみ |
4.2 ns | 752 ns |
RwLockの読み込みとArcの複製 |
7.6 ns | 833 ns |
キャッシュしたArcでの世代の確認 |
0.8 ns | 1.8 ns |
競合の下では、キャッシュによる読み込みはロックより400倍以上安価です。そのためリクエストの経路ではキャッシュを使い、RwLockは更新という遅い経路でだけ使います。この測定はcmd/sibuna/src/slot.rsの無視されたテストread_cost_under_contentionです。リクエストの経路では使うたびに更新するので、リクエストはその時点で最新のエンジンを見ます。エンジン自体は小さく、コンパクトなヒープ上の表で209,052バイト、約204 KiBです(benchmarks/results/primitives-latest.jsonのengine_bytes)。128個のルール、128バイトのルール名、8,192個のトライのノードを収められます。