Teil V: Allokationsfreie Technik in Rust
Wir verfolgen eine Verbindung vom Annehmen bis zur Antwort durch einen einzigen festen Puffer und untersuchen die nebenläufigen Datenstrukturen, mit denen viele Verbindungsthreads Zustand teilen, ohne auf dem Anfragepfad Heap-Speicher zu allokieren. Wo Speichersicherheit sonst eigene Mechanismen bräuchte (Leserzähler, Arenen, Deskriptortabellen, Abbauketten), zeigen wir, wie Rusts Ownership sie stattdessen liefert.
Die Verbindungsschleife
Ein Thread pro Verbindung, begrenzt
Accept-Worker (--workers, standardmäßig einer pro CPU, höchstens 64) teilen sich den lauschenden Socket. Jede angenommene Verbindung wird einem eigenen Thread mit einem Stack von einem Megabyte übergeben, und die Accept-Schleife kehrt sofort zu accept zurück. Ein Thread, der seine Verbindung beendet hat, wartet geparkt und übernimmt die nächste, weil das Erzeugen und Beenden eines Threads für jede Verbindung die anderen Threads ins Stocken brachte (Teil VIII, SID 0002). Die Alternative, eine Verbindung auf dem Accept-Thread bis zum Ende zu bedienen, war der erste Entwurf: Mit einem einzelnen Client maß er gut und mit vierundsechzig schlecht, weil sechzig von ihnen warteten, bis ein Worker sein Kontingent von 256 Anfragen abgearbeitet hatte, und die Latenz am Verteilungsende mit jedem wartenden Client wuchs. Mit einem Thread pro Verbindung bleibt das p99 bei 64 Verbindungen in jeder Arbeitslast des Gesamtprodukts unter einer Millisekunde, zwischen 305 µs und 857 µs (benchmarks/results/product-latest.md; Teil VIII).
Die Zahl der Verbindungsthreads ist durch --max-connections begrenzt (standardmäßig 1.024, höchstens 8.192). Jenseits der Grenze antwortet die Accept-Schleife auf dem neuen Socket mit 503 Service Unavailable und schließt ihn, ohne etwas zu starten, und zählt das Ereignis in sibuna_overloaded_total.
fn accept_loop(server: &Arc<Server>, listener: &TcpListener) {
    while !server.is_stopping() {
        let stream = match listener.accept() {
            Ok((stream, _)) => stream,
            // ... Deskriptoren oder Speicher erschöpft: 1 ms warten statt spinnen
        };
        let limit = server.max_connections.load(Ordering::Relaxed);
        if server.connections.fetch_add(1, Ordering::Relaxed) >= limit {
            server.connections.fetch_sub(1, Ordering::Relaxed);
            server.metrics.overloaded.bump();
            let text = "Service Unavailable: connection limit reached";
            reject(server, &stream, text);
            continue;
        }
        set_no_delay(&stream);
        let task_server = Arc::clone(server);
        let launched = server.tasks.launch(move || {
            let _counted = Counted(&task_server);
            crate::connection::serve(&task_server, &stream);
        });
        // ... scheitert der Start: Platz zurückgeben und Überlastung zählen
    }
}
Counted ist ein Guard, dessen Drop den Platz der Verbindung innerhalb der Grenze zurückgibt, wie auch immer der Thread endet, durch Rückkehr oder durch Panic. Der 503-Pfad liest zuerst ab, was der Client bereits gesendet hat, bevor er seine Seite des Sockets schließt: Ein Socket, der über ungelesenen Bytes geschlossen wird, antwortet mit einem Reset, und der Reset würde die 503 verwerfen.
Threads stammen aus einem TaskPool (cmd/sibuna/src/tasks.rs), einer festen Tabelle joinbarer Slots. Ein beendeter Thread behält seinen Stack, bis er gejoint wird. Daher wird ein Slot gejoint, wenn er erneut belegt wird, und eine neue Aufgabe nimmt den niedrigsten beendeten Slot, statt einen Cursor weiterzuschieben. Ein Cursor würde einen beendeten Slot erst nach einer vollen Runde durch die Tabelle wieder erreichen, sodass Tausende beendeter Threads resident blieben, und der Speicher würde mit den bedienten Verbindungen wachsen statt mit den offenen. Ein zweiter Guard, Finished, markiert den Slot als frei, wenn die Aufgabe endet, sodass auch eine Verbindung mit Panic ihren Slot freigibt.
Der Speicher ist auf dieselbe Weise begrenzt. Ein Verbindungsthread hält seinen 64-KiB-Lesepuffer und seinen 16-KiB-Schreibpuffer auf seinem Stack und einen 40-KiB-Proxy-Arbeitsbereich auf dem Heap, der einmal beim Start der Verbindung allokiert wird. Der schlechteste Fall ist daher eine bekannte Zahl und keine Funktion davon, wie viele Sockets ein Client öffnen kann. Der Idle-Reaper (siehe unten) schließt Verbindungen, die nichts mehr senden, sodass ein langsamer Client einen Thread nicht über --idle-timeout hinaus festhalten kann.
Wahl des Allokators
Rust 1.100 stabilisiert den Kern der Allocator-API und die Allokatorparameter von Vec und Box (Versionshinweise). Wir können den Allokator einer Sammlung wählen, ohne den Allokator des Prozesses zu ersetzen. Auf dem Anfragepfad sparen wir dadurch keine Allokationen: Anfragen auf warmen Verbindungen allokieren bereits nichts, wie cmd/sibuna/tests/steady_state.rs und crates/net/tests/steady_state.rs prüfen. Der Proxy allokiert seine drei Puffer einmal pro Verbindung und verwendet sie wieder. Auch der Begrenzer und die Menge verbrauchter Nachweise allokieren ihre Tabellen nur einmal; die mit Nullen angeforderten Allokationen lassen unberührte Seiten nichtresident bleiben, wie crates/store/tests/resident.rs prüft.
Bei einer Untersuchung eines anderen Allokators würden wir zuerst den Aufbau von Regelwerks-Snapshots und das JSON-Parsen der Konsole messen. Ihre temporären Sammlungen allokieren außerhalb des Anfragepfads, doch der Allokator einer Sammlung bestimmt nicht automatisch die Allokationen ihrer Elemente. Unser JSON-Baum besitzt außerdem Zeichenketten mit Escape-Sequenzen über Cow<str>, dessen besitzende Form String ist; String hat in Rust 1.100 keinen Allokatorparameter. Arc::new_in bleibt in dieser Version instabil (API-Dokumentation). Veröffentlichte Engines bleiben über Arc geteilt, bis ihr letzter Leser sie freigibt. Ein Neuaufbau darf daher keinen Speicher zurücksetzen, den eine ältere Engine noch verwendet. Eine Arena müsste diese Lebensdauern und die Eingabegrenzen des Parsers erhalten.
Wir behalten den globalen Allokator WipeOnFree des WebAssembly-Moduls der Konsole in cmd/console-ui/src/abi.rs bei. Er löscht freigegebene Blöcke, einschließlich des alten Blocks nach einer Reallokation. Würden wir System direkt für eine Sammlung wählen, würde dieses Löschen umgangen. Das WebAssembly-Modul für Arbeitsnachweise hat keinen Heap-Allokator, und Argon2 verwendet bereits einen wiederverwendeten Arbeitsbereich, der dem Aufrufer gehört. Wir behalten daher die bisherigen Allokatoren und die Kompatibilität mit Rust 1.94 bei, bis eine gemessene Last eine Änderung rechtfertigt. Ein Kandidat muss Latenz oder residenten Speicher verbessern und dabei das Löschen, die begrenzte Eingabeverarbeitung und den allokationsfreien Anfragepfad erhalten.
Ein Puffer pro Verbindung
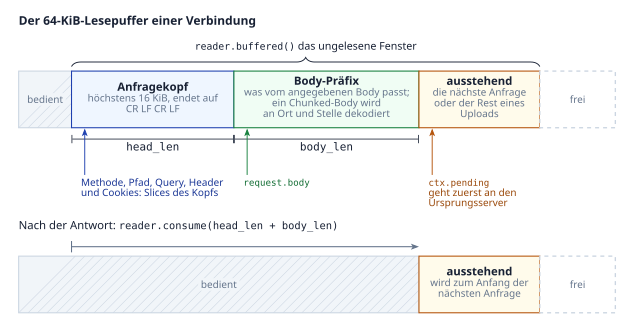
Jede dynamische Allokation auf einem Anfragepfad ist ein Hebel für Denial of Service: Fragmentierung über Tage, Konkurrenz um die Sperre des Allokators zwischen Threads und Verstärkung durch Angreifer, die Anfragen so gestalten, dass sie die Allokation maximieren. Sibunas Regel ist absolut: Klassifikation, Verifikation und Übergabe an den Proxy laufen ohne jede Heap-Allokation. Der Verbindungshandler besitzt für die Lebensdauer des Sockets einen 64-KiB-Lesepuffer und einen 16-KiB-Schreibpuffer; alles andere ist ein Slice in diese Puffer.
pub fn serve(server: &Server, stream: &TcpStream) {
    let Some(lease) = server.idle.register(stream) else { return };
    // ...
    let mut read_buffer = [0u8; MAX_REQUEST_BYTES]; // 64 KiB
    let mut write_buffer = [0u8; WRITE_BUFFER]; // 16 KiB
    let mut reader = Reader::new(stream, &mut read_buffer[..]);
    let mut peer = PeerText::default();
    peer.format(stream.peer_addr().ok());
    let mut link = Link {
        server,
        stream,
        writer: Writer::new(stream, &mut write_buffer[..]),
        workspace: Workspace::new(),
        cache: EngineCache::new(),
        activity: lease.activity(),
        last: false,
    };
    for served in 0..MAX_REQUESTS_PER_CONNECTION {
        link.last = served + 1 == MAX_REQUESTS_PER_CONNECTION;
        if !serve_one(&mut reader, &mut link, peer.as_bytes()) {
            break;
        }
        lease.touch();
    }
}
read_head füllt den Puffer, bis die Leerzeile erscheint, durchsucht dabei nur die seit der letzten Suche eingetroffenen Bytes und weist Köpfe über 16 KiB mit 431 ab. parse_request (Crate sibuna-http) erzeugt einen Request<'a>, dessen Methode, Pfad, Query, Header und Cookies Slices des Puffers sind. Der angegebene Body wird gefüllt, soweit er passt, und hinter dem Kopf als Slice genommen. Dann rückt reader.consume(head_len + body_len) den Leser vor, sodass die nächste Keep-alive-Anfrage sauber beginnt; der Leser schiebt die ungelesenen Bytes nur dann nach vorn, wenn er Platz braucht. Ein Chunked-Body wird an Ort und Stelle hinter dem Kopf dekodiert (SID 0009): Die Rahmung jedes Schritts wird aus dem Puffer herausgeschnitten, sodass das dekodierte Präfix für die Prüfung zusammenhängend bleibt. Interne Routen sind längenbegrenzt und halten die Verbindung offen. Weitergeleitete Anfragen halten sie ebenfalls offen, sofern die Antwort des Ursprungsservers gerahmt ist und der Body vollständig gepuffert wurde; die nächsten Abschnitte zeigen, wie der Proxy entscheidet.
fn serve_one<W: Write>(
    reader: &mut Reader<'_, &TcpStream>,
    link: &mut Link<'_, W>,
    peer: &[u8],
) -> bool {
    let head_len = match read_head(reader) {
        Head::Complete(length) => length,
        Head::TooLarge => { /* 431 "Request head exceeds 16 KB" */ return false; }
        Head::Closed | Head::Failed => return false,
    };
    let framing = {
        let bytes = reader.buffered();
        let head = bytes.get(..head_len).unwrap_or_default();
        let request = match parse_request(head) {
            Ok(request) => request,
            Err(error) => return reject_head(link, error),
        };
        let declared = request.content_length().unwrap_or(0);
        // ... Expect: 100-continue
        if declared == 0 && !request.chunked {
            let upload = Upload::declared(&request);
            let pending = bytes.get(head_len..).unwrap_or_default();
            let keep = dispatch(link, request, pending, upload, 0, peer);
            reader.consume(head_len);
            return keep;
        }
        (declared, request.chunked)
    };
    serve_with_body(reader, link, peer, head_len, framing)
}
Das Umschreiben des Kopfs im Proxy
Der Kopf wird nicht wörtlich weitergeleitet. write_request_head (crates/net/src/request.rs, Crate sibuna-net) gibt die Anfragezeile und jeden Header neu in den Writer zum Ursprungsserver aus und lässt dabei weg: Hop-by-Hop-Felder (Connection, Keep-Alive, Proxy-Connection, Transfer-Encoding, TE, Trailer, Upgrade, die Felder der Proxy-Autorisierung), jedes eingehende Weiterleitungs- oder Auditfeld (X-Forwarded-For, X-Real-IP, Forwarded, X-Forwarded-Proto, X-Forwarded-Host, X-Forwarded-Port, X-Sibuna-Status, X-Sibuna-Rule), Expect, Content-Length sowie jedes Feld, das der Connection-Header der Anfrage benennt. Danach hängt er die Auditfelder an. Die Rahmung des Bodys wird erzeugt, nie kopiert:
for header in request.headers() {
    if is_hop_by_hop(header.name) || nominated(request, header.name) {
        continue;
    }
    out.write_all(header.name)?;
    out.write_all(b": ")?;
    out.write_all(header.value)?;
    out.write_all(b"\r\n")?;
}
match upload {
    Upload::None => {}
    Upload::Length(length) => {
        out.write_all(b"Content-Length: ")?;
        write_decimal(out, *length)?;
        out.write_all(b"\r\n")?;
    }
    Upload::Chunked(_) => out.write_all(b"Transfer-Encoding: chunked\r\n")?,
}
Ein Content-Length wird neu ausgegeben. Ein Chunked-Body, der innerhalb des Verbindungspuffers endete, wird an Ort und Stelle dekodiert und mit seiner Länge gesendet. Ein längerer wird als Transfer-Encoding: chunked angekündigt und Lesevorgang für Lesevorgang neu in Chunks zerlegt (SID 0009): Jeder Lesevorgang landet im 16-KiB-Upload-Puffer des Proxys, wird dort an Ort und Stelle dekodiert und geht als ein kanonischer Chunk hinaus, sodass der Ursprungsserver die Chunk-Größen, Erweiterungen und Trailer des Clients nie sieht. Die Auditfelder:
Connection: keep-alive
X-Forwarded-For: <client>
X-Forwarded-Proto: <scheme>
X-Real-IP: <client>
X-Sibuna-Status: PASS
X-Sibuna-Rule: session | robots-txt | ip/cidr-trie | ...
Bodys, die größer als der Puffer sind, werden in Stücken von 16 KiB vom Client zum Writer des Ursprungsservers weitergereicht (relay_body), bevor die Antwort zurückgestreamt wird. Der Unit-Test proxy_head_rewrite_drops_hop_by_hop_headers_and_injects_audit_fields in crates/net/src/request.rs stellt sicher, dass das Umschreiben ein gefälschtes X-Forwarded-For entfernt und die Auditfelder einfügt.
Die drei Puffer des Proxys, der Lesepuffer zum Ursprungsserver (ein Antwortkopf, 16 KiB), der Schreibpuffer zum Ursprungsserver (8 KiB) und der Upload-Puffer (16 KiB), liegen in einem Workspace, den die Verbindung einmal allokiert und für jede Anfrage wiederverwendet. Der Arbeitsbereich gibt ihnen die Lebensdauer der Verbindung, nicht die des einzelnen Austauschs, und Leser und Writer zum Ursprungsserver leihen sie jeweils für einen Austausch.
Die Antwort des Ursprungsservers weiterreichen
Der erste Proxy streamte die Bytes des Ursprungsservers, bis dieser schloss, und schloss dann den Client: korrekte Rahmung ohne Parsen, um den Preis einer neuen TCP-Verbindung pro weitergeleiteter Anfrage. Unter einem Lastgenerator zeigte sich dieser Preis als Zehntausende Sockets in TIME_WAIT und, auf Loopback, als erschöpfte ephemere Ports. Der Proxy liest jetzt den Kopf des Ursprungsservers (höchstens 16 KiB) und klassifiziert den Body nach den Regeln von RFC 9112:
pub enum Framing { None, Length(u64), Chunked, UntilClose }

pub fn parse_response_head(
    head: &[u8],
    head_request: bool,
) -> Option<ResponseHead> {
    let status = status_code(head)?;
    let mut fields = FramingFields {
        keep_alive: head.get(7) == Some(&b'1'),
        ..Default::default()
    };
    for line in crlf_lines(head).skip(1) {
        if line.is_empty() {
            break;
        }
        fields.read_line(line)?; // Transfer-Encoding, Content-Length, Connection
    }
    let mut framing = fields.length.map_or(Framing::UntilClose, Framing::Length);
    if head_request || status / 100 == 1 || status == 204 || status == 304 {
        framing = Framing::None;
    } else if fields.encoded {
        framing =
            if fields.chunked { Framing::Chunked } else { Framing::UntilClose };
    }
    let mut keep_alive = fields.keep_alive;
    if framing == Framing::UntilClose || fields.closing {
        keep_alive = false;
    }
    if fields.nominates_framing {
        return None;
    }
    Some(ResponseHead { status, framing, keep_alive })
}
Der Parser weist zurück, was der Proxy nicht weiterreichen darf: eine fehlerhafte Statuszeile, einen Feldnamen, der kein Token ist, ein Steuerbyte in einem Wert, widersprüchliche Längen, eine wiederholte oder nicht abschließende chunked-Kodierung und ein Connection-Feld, das Content-Length oder Transfer-Encoding benennt. Seine Arbeit ist linear in der Größe des Kopfs, und er gerät nie in Panic.
Der Kopf wird an den Client neu ausgegeben, wobei die Connection-Header des Ursprungsservers durch Sibunas eigene Entscheidung ersetzt werden, und der Body wird exakt weitergereicht: copy_exact bei einer Länge, Chunk für Chunk (Größenzeile, Daten, Trailer) bei Chunked-Kodierung, copy_remaining im Altfall. Nur der Altfall schließt den Client. Jedes Weiterreichen baut auf einem einzigen Kopierschritt auf: weitergeben, was die Quelle bereits hält, und erst wenn sie nichts hält, das Ziel leeren und dann einmal lesen. Ein Strom kleiner Schreibvorgänge wird daher so ausgeliefert, wie er entsteht, während eine Massenübertragung weiterhin einen vollen Puffer pro Lese- und Schreibvorgang bewegt.
let keep = client_keep_alive && parsed.framing != Framing::UntilClose;
write_client_head(client, head, keep).map_err(client_head_error)?;
origin.consume(head_length);
match parsed.framing {
    Framing::None => {}
    Framing::Length(length) => copy_exact(origin, client, length, progress)?,
    Framing::Chunked => relay_chunked(origin, client, progress)?,
    Framing::UntilClose => copy_remaining(origin, client, progress)?,
}
client.flush().map_err(|_| ProxyError::ClientFailed)?;
Ok(Relayed { client_keep: keep, origin_reusable: parsed.keep_alive })
Das Parsen eines Ursprungskopfs mit acht Feldern dauert 322 ns, und ein Keep-alive-GET mit einer 1-KiB-Antwort, über Loopback weitergeleitet, dauert 29,8 µs (gemessen im Oktober 2026; crates/net/src/lib.rs dokumentiert die Messung).
Der Pool zum Ursprungsserver
Das Parsen der Rahmung sagt dem Proxy auch, ob der Socket zum Ursprungsserver wiederverwendet werden kann: Eine HTTP/1.1-Antwort ohne Connection: close (oder eine HTTP/1.0-Antwort mit keep-alive), deren Body vollständig verbraucht wurde, lässt den Socket an einer sauberen Anfragegrenze zurück. Solche Sockets kommen in einen festen Pool von 256 untätigen Verbindungen zum Ursprungsserver, und die nächste weitergeleitete Anfrage nimmt einen davon, statt neu zu verbinden. Ohne den Pool öffnet jede weitergeleitete Anfrage eine neue Verbindung zum Ursprungsserver, und jede geschlossene Verbindung hält ihren lokalen Port in TIME_WAIT; unter Last gehen einem Proxy auf Loopback bald die ephemeren Ports aus, und sein Durchsatz bricht ein.
Ein Pool unter einer einzigen Sperre würde jede weitergeleitete Anfrage um diese Sperre konkurrieren lassen. Deshalb ist der Pool (crates/net/src/pool.rs) in Streifen aufgeteilt: 16 Streifen mit je 16 Sockets, jeder Streifen ein Mutex<Vec<Arc<TcpStream>>> auf einer eigenen Cache-Zeile. Einem Thread wird bei der ersten Nutzung reihum ein Heimatstreifen zugewiesen; er gibt zuerst an diesen ab und nimmt zuerst von ihm und schaut, ohne auf eine gehaltene Sperre zu warten, in die anderen Streifen, bevor er neu verbindet.
pub fn take(&self) -> Option<Arc<TcpStream>> {
    if self.is_stopping() {
        return None;
    }
    let home = home_stripe();
    if let Some(socket) =
        self.stripe(home).and_then(|stripe| lock(&stripe.sockets).pop())
    {
        return Some(socket);
    }
    (1..STRIPES).find_map(|offset| {
        let stripe = self.stripe((home + offset) % STRIPES)?;
        try_lock(&stripe.sockets)?.pop()
    })
}
Ein Socket im Pool kann vom Ursprungsserver geschlossen worden sein, während er untätig war. Der Proxy bemerkt das auf eine von zwei Arten, durch einen fehlgeschlagenen Schreibvorgang oder durch ein Stream-Ende vor dem ersten Antwortbyte. In beiden Fällen hat den Client noch nichts erreicht, also schließt er den Socket und versucht es einmal erneut auf einer frischen Verbindung, nie auf einer anderen aus dem Pool: Nach einer Ruhephase kann jeder Socket im Pool veraltet sein, und die erste Version dieser Wiederholung, die einen zweiten Socket aus dem Pool nahm, beantwortete nach jeder ruhigen Phase die erste Anfrage mit 502. Die Wiederholung ist nur für eine sichere Methode (GET, HEAD, OPTIONS) erlaubt, deren Body vollständig gepuffert wurde. Eine fehlende Antwort belegt nicht, dass der Ursprungsserver keine Änderung festgeschrieben hat, und ein Body, der in Stücken weitergereicht wurde, kann nicht erneut gesendet werden; in beiden Fällen erhält der Client 502.
let safe = matches!(request.method, Method::Get | Method::Head | Method::Options);
let buffered = exchange.upload.is_buffered(request.body.len());
let retryable = safe && buffered;
for attempt in 0..2 {
    // Eine Wiederholung verbindet sich immer neu: Nach einer Ruhephase kann
    // jeder Pool-Socket veraltet sein; ein zweiter ließe die Anfrage scheitern.
    let pooled = if attempt == 0 { pool.take() } else { None };
    // ... verbinden, falls der Pool leer war, an Aktivität koppeln, austauschen
    match outcome {
        Ok(relayed) => {
            if relayed.origin_reusable {
                pool.give(origin);
            }
            return Ok(relayed.client_keep && buffered);
        }
        Err(error) => {
            drop(origin);
            let stale = was_pooled
                && retryable
                && matches!(
                    error,
                    ProxyError::UpstreamClosed | ProxyError::UpstreamWriteFailed
                );
            // ... alles andere wird sofort gemeldet
        }
    }
}
Unit-Tests reichen feste Bytefolgen durch dieselben Funktionen und stellen sicher, dass die Ausgabe bis auf den Connection-Header byteidentisch ist (crates/net/src/relay/tests.rs). Ein End-to-End-Test des Daemons sendet zwei weitergeleitete Anfragen auf einem Client-Socket und prüft über einen Sequenz-Header, den der Stub-Ursprungsserver hinzufügt, dass die zweite die Verbindung zum Ursprungsserver aus dem Pool wiederverwendet hat. Ein Vektortest in crates/net/tests/ spielt aufgezeichnete Proxy-Szenarien ab (eine rohe Clientanfrage und eine vorgefertigte Antwort des Ursprungsservers) und vergleicht jedes Byte, das Ursprungsserver und Client empfangen.
Leerlauffristen
Jede Clientverbindung registriert ihren Socket in einer IdleTable (crates/net/src/idle.rs) und erhält eine Lease. Die Activity der Lease hält den Zeitpunkt, zu dem sich zuletzt Bytes auf der Verbindung bewegt haben. Der Daemon aktualisiert ihn nach jeder bedienten Anfrage; der Proxy aktualisiert ihn bei jedem Lesevorgang vom Ursprungsserver und je 16 KiB Upload und hängt den Socket zum Ursprungsserver des laufenden Austauschs an. Der Reaper-Thread wacht nach jeweils einem Viertel der kürzesten Frist auf (zwischen 200 ms und einer Sekunde) und schließt jede Verbindung, die länger als ihre Frist still war, zusammen mit dem angehängten Socket zum Ursprungsserver. So sieht der auf einer der beiden Seiten blockierte Thread ein Stream-Ende und gibt seinen Slot frei.
Fristen messen daher Stille, nie die Länge einer Antwort: Ein großer Download, der in Bewegung bleibt, wird nie abgeschnitten. Upload-Bytes kommen von der nicht vertrauenswürdigen Seite und erneuern den Zeitstempel nur je 16 KiB. Damit wird von einem Client mindestens 16 KiB pro Leerlaufperiode verlangt, die Abwehr langsamer Bodys durch Anfragefristen mit Mindestrate.
Die Tabelle hat eine kleine Sperre pro Slot und keine tabellenweite Sperre. Sie hält ein try_clone jedes Client-Sockets und einen Arc jedes angehängten Sockets zum Ursprungsserver, aus dem oben genannten Grund. Eine Lease meldet ihre Verbindung in Drop ab, und ein abgeräumter Slot bleibt bis dahin im Besitz seiner Lease, sodass eine alte Verbindung nie einen Slot freigeben kann, den eine neue übernommen hat.
Verbindungen nach einem Upgrade
Nach einer validierten 101 wird ein WebSocket-Upgrade in beide Richtungen weitergereicht. Jede Richtung läuft auf einem eigenen Thread mit einem festen Puffer: Der eigene Thread der Verbindung trägt die Bytes vom Ursprungsserver zum Client, und ein Scoped Thread mit einem 128-KiB-Stack trägt die Bytes vom Client zum Ursprungsserver. Ein Thread könnte mit poll(2) beide Richtungen bedienen, aber die Rust-Standardbibliothek stellt das nicht bereit; zwei Threads mit Socket-Timeouts halten die Weiterleitung frei von unsafe. Eine Verbindung nach einem Upgrade hält daher zwei Threads, sodass die Zahl der Verbindungsthreads das Doppelte von --max-connections erreichen kann, wenn jede Verbindung ein Upgrade erhalten hat.
Beide Richtungen teilen eine Leerlauffrist (--websocket-idle-timeout, standardmäßig 300 Sekunden): Bytes, die sich in einer der beiden Richtungen bewegen, erneuern einen gemeinsamen Zeitstempel. Jedes Warten auf einen Socket trägt ein Timeout gleich der verbleibenden Zeit; ein Warten, das in das Timeout läuft, liest den gemeinsamen Zeitstempel neu und wartet entweder den Rest ab oder beendet die Weiterleitung. Erreicht eine Richtung das Stream-Ende, wird die Sendeseite des anderen Sockets geschlossen (ein Half-Close); schlägt eine Richtung fehl, werden beide Sockets geschlossen, sodass auch die andere Richtung endet. Bevor ein Upgrade weitergeleitet wird, gibt die Verbindung ihre zwischengespeicherte Richtlinien-Engine frei, sodass eine Verbindung, die Stunden leben kann, keine alte Engine am Leben hält.
Herunterfahren
Running::stop, und ebenso Drop für Running, hält den Daemon in einer festen Reihenfolge an. Es setzt das Anhalte-Flag und weckt jeden Accept-Worker, indem es sich mit dem Listener verbindet, joint die Worker, schließt jeden registrierten Client-Socket und seinen angehängten Socket zum Ursprungsserver (IdleTable::shutdown), hält den Pool zum Ursprungsserver an, joint jeden Verbindungsthread, joint den Reaper und schließt die Sockets im Pool.
SIGINT und SIGTERM erreichen diese Abfolge über gewöhnliches Rust. Bevor er irgendeinen Thread startet, blockiert der Daemon beide Signale (jeder spätere Thread erbt die Maske) und widmet einen Thread sigwait, der die Anforderung festhält und den Hauptthread sofort weckt. Kein Code läuft in einem Signalhandler, und kein Thread fragt ein Flag ab. Das Signalmodul (cmd/sibuna/src/signals.rs) enthält den einzigen unsafe-Code des Daemons: die Deklarationen der wenigen Funktionen der C-Bibliothek, die std nicht kapselt.
Was wir gemessen haben
Die Tabelle zeigt Shield im Reverse-Proxy-Modus auf einem Ryzen 9 5950X: der Daemon auf vier CPUs festgelegt, wrk mit zwei Threads und 64 Verbindungen auf acht anderen CPUs, Läufe von fünf Sekunden, der Median aus drei. Die Zeilen sind aus benchmarks/results/product-latest.md übernommen; Teil VIII enthält das vollständige Protokoll.
| Arbeitslast | Status | Anfr./s | p50 / p99 (µs) | CPU pro Anfrage (µs) |
|---|---|---|---|---|
| mit Sitzung zugelassen, weitergeleitet | 200 | 138.965 | 438 / 857 | 28,57 |
| mit Challenge belegt (Zwischenseite) | 200 | 195.188 | 162 / 328 | 13,73 |
| statisch erlaubt, weitergeleitet | 200 | 145.673 | 415 / 746 | 27,27 |
| von der WAF abgelehnt (mit Sitzung) | 403 | 209.507 | 151 / 306 | 12,17 |
wrk hält 64 Anfragen gleichzeitig in Bearbeitung, sodass Anfragen auf den CPU-gebundenen weitergeleiteten Pfaden auf die vier CPUs warten; das p99 ist dort das Verteilungsende des Schedulers und nicht die Kosten einer Anfrage. Ein Lastgenerator mit offener Schleife, der mit fester Rate sendet und jede Anfrage ab ihrem vorgesehenen Sendezeitpunkt misst, misst stattdessen die Latenz bei gleicher angebotener Last. Für zugelassene Anfragen im Reverse-Proxy-Modus beträgt das p99 65 µs bei 10.000 Anfragen pro Sekunde und 100 µs bei 100.000; bei 150.000 angebotenen Anfragen sind die vier CPUs gesättigt, 134.344 Anfragen pro Sekunde werden erreicht, und die Warteschlange wächst auf Sekunden (benchmarks/results/latency-latest.md). Eine warme Keep-alive-Verbindung bedient jede Entscheidung ohne Heap-Allokation: cmd/sibuna/tests/steady_state.rs zählt die Allokationen des Daemons, und crates/net/tests/steady_state.rs findet über 500 weitergeleitete Keep-alive-Anfragen hinweg keine.
Nebenläufiger Zustand ohne Allokation
Jeder Speicher in sibuna-store allokiert seine feste Kapazität einmal beim Aufbau und allokiert danach nie wieder und blockiert nie auf einer globalen Sperre. Keiner braucht einen Hintergrund-Aufräumer: Abgelaufener Zustand wird an Ort und Stelle zurückgewonnen.
Sperren und Sharding
Die kritischen Abschnitte in Sibunas Tabellen sind einige Dutzend Instruktionen lang, weit kürzer als ein Rundlauf über einen Kernel-Futex. Tabellen sind nach Schlüsselhash in 16 Shards aufgeteilt, sodass zwei Operationen mit Wahrscheinlichkeit \(1/16\) konkurrieren, und jeder Shard liegt auf einer eigenen Cache-Zeile, sodass benachbarte Sperren kein False Sharing verursachen.
Die Tabellen verwenden std::sync::Mutex: ein Compare-and-Swap ohne Konkurrenz, ein kurzes Spinnen, solange der Halter läuft, dann ein Futex-Warten. Die Alternative ist ein Spinlock mit zwei atomaren Zuständen und einem Spin-Loop-Hinweis in der Warteschleife. SID 0010 verlangte, zwischen beiden anhand von Messungen zu wählen. Ein Spinlock spart ohne Konkurrenz etwa eine Nanosekunde pro Operation, verliert aber unter Konkurrenz:
| Arbeitslast | Mutex |
Spinlock |
|---|---|---|
| Verbrauchsmenge, 16 Threads | 10,8 M/s | 8,6 M/s |
| Verbrauchsmenge, 64 Threads (mehr als CPUs) | 11,2 M/s | 6,9 M/s |
| GCRA auf sechs Hotspot-Adressen, 16 Threads | 44,9 M/s | 19,3 M/s |
| GCRA auf sechs Hotspot-Adressen, 64 Threads | 37,4 M/s | 6,5 M/s |
Ein Edge-Server führt mehr Verbindungsthreads aus, als er CPUs hat, und ein Spinlock, dessen Halter verdrängt wird, lässt jeden Wartenden seine Zeitscheibe verbrennen; deshalb behalten wir den Mutex. Eine vergiftete Sperre wird betreten, statt die Vergiftung weiterzugeben: Keine Operation gerät in Panic, während sie einen Shard hält, und der Shard bliebe strukturell gültig, selbst wenn eine es täte.
Die Robin-Hood-Verbrauchsmenge
Nur angenommene Nachweise gelangen in die Verbrauchsmenge (Teil III). Sie hat 16 Shards, jeder ein Array mit offener Adressierung aus 4.096 Slots vom Typ Option<Entry>, wobei ein Eintrag { tag: [u8; 16], expires_at: u64, dist: u8 } ist. Robin-Hood-Einfügen (Celis, 1986) verdrängt jeden Eintrag, der seiner Heimatposition näher ist als der eingehende Schlüssel, und hält so die Sondierungslängen eng beieinander; Suchen halten an, sobald sie auf einen Eintrag treffen, der seiner Heimatposition näher ist als sie der ihren.
fn insert(
    &mut self,
    tag: &Tag,
    expires_at: u64,
    now: u64,
) -> Result<(), SpendError> {
    if !self.can_insert(tag, now) {
        return Err(SpendError::Full);
    }
    let mut carry = Entry { tag: *tag, expires_at, dist: 0 };
    let mut idx = Self::home(tag);
    while carry.dist < MAX_PROBE {
        let slot = &mut self.entries[idx];
        let Some(e) = slot else {
            *slot = Some(carry);
            return Ok(());
        };
        // Einen abgelaufenen Eintrag zu überschreiben ist nur sicher, wenn
        // die neue Distanz nicht kleiner ist; so bestehen Schlüssel, die
        // hier vorbeisondieren, weiterhin den Test für den frühen Abbruch.
        if e.is_expired(now) && carry.dist >= e.dist {
            *e = carry;
            return Ok(());
        }
        if carry.dist > e.dist {
            std::mem::swap(&mut carry, e);
            // Ein verdrängter abgelaufener Eintrag wird einfach verworfen.
            if carry.is_expired(now) {
                return Ok(());
            }
        }
        idx = (idx + 1) % SHARD_CAPACITY;
        carry.dist += 1;
    }
    Err(SpendError::Full)
}
Die Regel für abgelaufene Slots ist der heikle Teil: Ein abgelaufener Eintrag darf nur von einem Schlüssel an Ort und Stelle überschrieben werden, der mindestens ebenso weit von seiner Heimatposition entfernt ist; sonst würde ein späterer Schlüssel, der über den Slot hinaus sondiert, zu früh anhalten und verloren gehen. Abgelaufene Einträge, die verdrängt werden, werden einfach verworfen. Ein Aufräum-Thread ist nicht nötig. Das Einfügen simuliert zuerst den Verdrängungspfad, ohne etwas zu ändern (can_insert), und prüft, dass begrenzte Verdrängung gelingen kann, ohne ein lebendes Tag zu verlieren.
Ein Slot ist Option<Entry>. Ein leerer Slot hat kein Tag zum Lesen, also gibt es kein occupied-Flag, dessen Prüfung ein Leser vergessen könnte, und match kompiliert erst, wenn beide Fälle behandelt sind. Der Fehlertyp ist ebenso genau: Die Verbrauchsmenge kann auf zwei Arten scheitern (DoubleSpend und Full), und SpendError benennt genau diese.
GCRA: Ratenbegrenzung in einer Ganzzahl
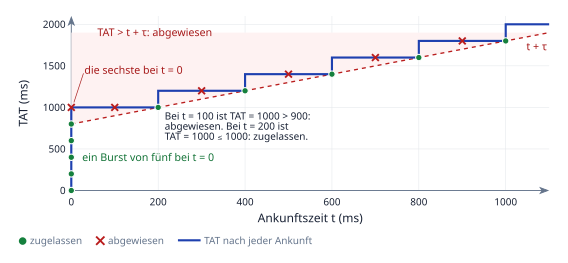
Der Generic Cell Rate Algorithm (ATM Forum, 1996) ist die Virtual-Scheduling-Form des Leaky Bucket. Pro Client speichert er eine theoretische Ankunftszeit (TAT). Mit dem Emissionsintervall \(T = \max(1, \lceil W / N \rceil)\) für ein positives Limit \(N\) pro Fenster \(W\) und der Bursttoleranz \(\tau = (N - 1) T\) gilt:
fn arrive(
    cells: &mut [Cell; SLOTS_PER_SHARD],
    key: u64,
    now_ms: u64,
    limits: Limits,
) -> Decision {
    let interval = limits.emission_interval();
    let tau = limits.burst_tolerance();
    let Some(cell) = locate(cells, key, now_ms, tau) else {
        return Decision {
            limited: true,
            capacity_exhausted: true,
            retry_after_ms: interval,
            remaining: 0,
        };
    };
    let tat = cell.tat_ms.max(now_ms);
    let horizon = now_ms.saturating_add(tau);
    if tat > horizon {
        return Decision {
            limited: true,
            capacity_exhausted: false,
            retry_after_ms: tat - tau - now_ms,
            remaining: 0,
        };
    }
    cell.tat_ms = tat.saturating_add(interval);
    // ... remaining = min(rate, floor((t + tau - TAT) / T) + 1)
}
check des Shards nimmt die Sperre und ruft arrive mit den gesperrten Zellen auf; der Guard gibt die Sperre frei, wenn check zurückkehrt. Zellen sind 16 Bytes groß (ein Schlüssel und eine TAT) und liegen in 16 Shards zu 512 Slots mit einem Sondierungsfenster von 16 Slots, insgesamt etwa 128 KiB. Eine Zelle, deren TAT älter als \(t - \tau\) ist, ist leergelaufen und wird sofort zurückgewonnen. Der Retry-After-Header wird mit derselben Arithmetik berechnet. Gesättigte Sondierungsfenster weisen neue Clients ab, statt aktiven Kontingentzustand zu verdrängen, und die Entscheidung sagt das (capacity_exhausted), sodass ein Aufrufer eine Abweisung wegen Sättigung nicht zu einer Sperre eskaliert. Eine konfigurierte Rate von null weist Anfragen ab. Ein Begrenzer bedient mehrere Regeln: Der Zellschlüssel ist ein Wyhash der Clientadresse, mit dem Geltungsbereich der Regel als Seed, sodass derselbe Client in verschiedenen Geltungsbereichen unabhängige Budgets hat.
Die versionierte Sperrtabelle
Sperren verwenden 4.096 Slots mit atomaren Feldern für Version, Schlüssel und Ablauf, offen adressiert über einen schlüsselbasierten Hash der gesperrten Adresse mit einem Sondierungsfenster von 8 Slots. Ein Schreiber, durch einen Mutex mit den anderen Schreibern serialisiert, umklammert jede Änderung mit Versionserhöhungen; Leser nehmen keine Sperre, akzeptieren nur eine stabile gerade Version und wiederholen bei gleichzeitigen Änderungen.
pub fn ban(&self, banned: &[u8], until: u64, now: u64) {
    let key = slot_key(banned);
    let _writers = self.lock_writers();
    let victim = &self.slots[self.victim(key, now)];
    // Schlüssel und Ablauf sind ein logischer Wert: Eine ungerade Version
    // klammert die Ersetzung ein, damit kein Leser einen alten Schlüssel mit
    // dem Ablauf des nächsten Schlüssels kombiniert.
    victim.version.fetch_add(1, Ordering::SeqCst);
    victim.until.store(until, Ordering::SeqCst);
    victim.key.store(key, Ordering::SeqCst);
    victim.version.fetch_add(1, Ordering::SeqCst);
}

fn read_slot(&self, slot: &Slot) -> (u64, u64) {
    loop {
        let before = slot.version.load(Ordering::SeqCst);
        if before & 1 != 0 {
            std::hint::spin_loop();
            continue;
        }
        let key = slot.key.load(Ordering::SeqCst);
        let until = slot.until.load(Ordering::SeqCst);
        if before == slot.version.load(Ordering::SeqCst) {
            return (key, until);
        }
    }
}
Sequenzielle Konsistenz verhindert, dass eine alte Identität mit einem neuen Ablauf vermischt wird: Jeder Zugriff gehört zu einer einzigen totalen Ordnung, was das Argument einfach hält. Leser nehmen keinen Mutex, können aber auf einen Schreiber warten und sind nicht wartefrei. Diese atomaren Operationen haben echte Kosten, die indirekt im HTTP-Messprogramm gemessen und nicht als kostenlos angenommen werden. Ein volles Sondierungsfenster überschreibt einen abgelaufenen Slot, andernfalls den Slot, der zuerst abläuft. clear hebt jede Sperre auf, lässt aber die Schlüssel stehen, weil ein geleerter Slot einen kollidierenden Schlüssel weiter hinten in einer Sondierungskette verbergen könnte.
Der MPSC-Ring für Vorfälle
Wenn die Betriebsform Shield eine Anfrage ablehnt oder der Honeypot auslöst, wird der Vorfall in einen festen Datensatz von etwa 1,3 KB kopiert (Clientadresse, User-Agent, Methode, Pfad, Kategorie und Nutzlast, jeweils auf ihre Kapazität gekürzt) und in einen begrenzten Ring mit mehreren Produzenten und einem Konsumenten geschoben (Vyukovs Entwurf mit Sequenzstempeln, 512 Slots, BoundedQueue<IncidentRecord, 512>). Produzenten sind Verbindungsthreads; der Konsument ist der Speicherthread. Ein voller Ring verwirft den neuesten Datensatz, statt eine Antwort zu blockieren: eine ausdrückliche Verlustrichtlinie, keine Haltbarkeitsgarantie. Der Verwerfungszähler macht diesen Verlust beobachtbar.
/// Kopiert `incident` in den Ring; ist er voll, wird verworfen und gezählt.
pub(crate) fn record(&self, incident: &Incident<'_>) {
    if self.queue.push(IncidentRecord::from_incident(incident)).is_err() {
        self.metrics.incidents_dropped.bump();
    }
}
Nachdem der Speicherthread einen Datensatz in einen ausstehenden Batch verschoben hat, behält er ihn zusammen mit den vorbereiteten Zeilen, bis der Commit bestätigt ist; bei einem Datenbankfehler verwirft er ihn nicht stillschweigend, und eine Wiederholung schreibt den identischen Batch.
Jeder Slot trägt eine Sequenznummer, die Produzenten sagt, ob der Slot frei ist, und dem Konsumenten, ob er voll ist, sodass keine Seite eine Sperre nimmt. Ein solcher Ring lässt sich nicht in sicherem Rust schreiben: Produzenten und Konsument berühren gleichzeitig verschiedene Slots eines Arrays, und nur das Sequenzprotokoll, nicht das Typsystem, beweist, welcher Thread welchen Slot berühren darf. Das Modul crates/store/src/ring.rs hält seine Werte daher in Slots vom Typ UnsafeCell<MaybeUninit<T>>, und jeder unsafe-Block nennt den Schritt des Protokolls, der ihn rechtfertigt:
if diff == 0 {
    // Relaxed: Der CAS entscheidet nur, welcher Produzent `pos` erhält.
    match self.tail.0.compare_exchange_weak(
        pos, pos.wrapping_add(1), Ordering::Relaxed, Ordering::Relaxed,
    ) {
        Ok(_) => {
            // SAFETY: Der CAS hat diesem Thread die Position `pos` gegeben, und
            // `sequence == pos`: Der Slot ist leer; kein anderer Produzent
            // kann `pos` beanspruchen, und der Konsument liest ihn nicht vor
            // dem Release-Store unten.
            unsafe { (*slot.value.get()).write(value) };
            // Release: macht den Wert für den Konsumenten sichtbar.
            slot.sequence.store(pos.wrapping_add(1), Ordering::Release);
            return Ok(());
        }
        Err(current) => pos = current,
    }
} else if diff < 0 {
    return Err(value);
}
Zwei Konventionen des Rings sind Typen, keine Kommentare. Bei einem vollen Ring gibt push Err(value) zurück und reicht den Datensatz zurück, sodass der Aufrufer entscheidet, ob er ihn zählt oder verwirft; ein bloßes false würde ihn verlieren. Der Ring hat einen einzigen Konsumenten: pop nimmt &mut self, und gemeinsam genutzter Code muss zuerst den eindeutigen Consumer beanspruchen, sodass ein zweiter Konsument nicht kompiliert oder zur Laufzeit abgewiesen wird.
Veröffentlichung der Engine per Read-Copy-Update
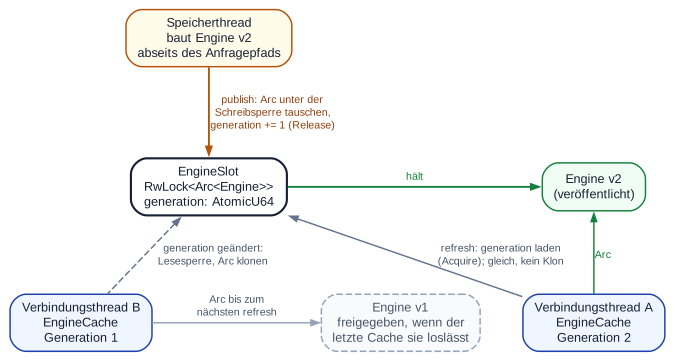
Die Richtlinien-Engine wird abseits des Hot Path neu gebaut, wenn sich Richtlinien ändern. Anfragen dürfen nie eine halb gebaute Engine sehen, und eine Engine darf nie freigegeben werden, solange eine Anfrage sie noch liest. Sibuna veröffentlicht jede Engine als Arc<Engine> in einem EngineSlot, und jede Verbindung liest sie über einen EngineCache:
pub struct EngineSlot {
    current: RwLock<Arc<Engine>>,
    generation: AtomicU64,
}

pub fn publish(&self, engine: Engine) {
    let fresh = Arc::new(engine);
    let previous = {
        let mut current =
            self.current.write().unwrap_or_else(PoisonError::into_inner);
        std::mem::replace(&mut *current, fresh)
    };
    self.generation.fetch_add(1, Ordering::Release);
    // Die alte Engine wird außerhalb der Sperre freigegeben (als letzter Halter).
    drop(previous);
}

pub struct EngineCache {
    generation: u64,
    engine: Option<Arc<Engine>>,
}

pub fn refresh(&mut self, slot: &EngineSlot) -> &Engine {
    let generation = slot.generation();
    if self.generation != generation {
        // Eine Veröffentlichung zwischen Laden und Klonen versieht eine neuere
        // Engine mit einer älteren Generation; der nächste refresh lädt erneut.
        self.generation = generation;
        self.engine = None;
    }
    self.engine.get_or_insert_with(|| slot.load())
}
Die Generation wird mit Release-Ordnung gespeichert, nachdem die Engine an ihrem Platz ist, und mit Acquire-Ordnung geladen: Ein Leser, der eine neue Generation sieht, sieht auch die zuvor gespeicherte Engine. Der im Kommentar genannte Wettlauf ist harmlos. Fällt eine Veröffentlichung zwischen das Laden der Generation durch einen Leser und sein Klonen, so speichert der Leser die neuere Engine unter der älteren Generationsnummer, und seine nächste Aktualisierung bemerkt die Abweichung und lädt erneut. Ein Leser kann für eine Anfrage eine Engine im Rückstand sein; eine halb gebaute Engine kann er nie sehen, weil nur vollständige Engines im Slot gespeichert werden.
Warum ein Cache und nicht einfach eine Sperre? SID 0010 verlangte, die Lesekosten mit 16 Threads zu messen und zwischen RwLock<Arc<Engine>> und einer sperrfreien Alternative in sicherem Rust zu wählen. Das Lesen über die Sperre berührt das Sperrwort und den Referenzzähler, zwei Cache-Zeilen, die jeder Kern beschreibt. Die Generation dagegen wird einmal pro Veröffentlichung geschrieben und sonst nur gelesen, sodass jeder Kern seine Kopie behält:
| Leser | 1 Thread | 16 Threads |
|---|---|---|
nur RwLock-Lese-Guard |
4,2 ns | 752 ns |
RwLock-Lesen und Arc-Klon |
7,6 ns | 833 ns |
Generationsprüfung mit zwischengespeichertem Arc |
0,8 ns | 1,8 ns |
Unter Konkurrenz ist das zwischengespeicherte Lesen mehr als 400-mal billiger als die Sperre, daher nutzt der Anfragepfad den Cache und den RwLock nur auf dem langsamen Pfad einer Aktualisierung. Die Messung ist der ignorierte Test read_cost_under_contention in cmd/sibuna/src/slot.rs. Jede Verwendung auf dem Anfragepfad aktualisiert, sodass eine Anfrage die zu diesem Schritt aktuelle Engine sieht. Die Engine selbst ist klein: 209.052 Bytes, etwa 204 KiB, kompakte Heap-Tabellen (engine_bytes in benchmarks/results/primitives-latest.json), mit Kapazität für 128 Regeln, Regelnamen von 128 Bytes und 8.192 Trie-Knoten.