Teil III: Grundlagen aus der kryptographischen Forschung
Wir leiten die Kostenmodelle hinter Sibunas zwei Proof-of-Work-Stufen her, stellen den Nachweis sequenzieller Arbeit nach Cohen-Pietrzak mit seinem Sicherheitsargument vor und begründen die Authentifizierung von Challenges und Sitzungen mit schlüsselbasierten Hashes. SID 0006 hält die Annahmen und Quellen fest.
Hashcash: Die Mathematik von Stufe eins
Definition und Kosten
Sibunas Rätsel der Stufe eins für die Challenge-Zeichenkette \(C\) und die Schwierigkeit \(b\) Bits lautet: Gesucht ist ein \(N \in \mathbb{N}\), sodass \(\text{SHA-256}(C \parallel \text{":"} \parallel \mathrm{dec}(N))\) \(b\) führende Nullbits hat. Die dezimale Darstellung der Nonce ist Absicht; sie hält das Übertragungsformat zwischen dem WebAssembly-Löser, dem JavaScript-Fallback und dem nativen Verifizierer identisch, ohne einen Schritt binärer Kodierung.
Die Einheit der Schwierigkeit ist ein erwarteter Hash-Versuch, kein Aufruf der Kompressionsfunktion. Eine Eingabe kann mehrere SHA-256-Blöcke belegen. Eine Vorberechnung des Präfixes kann zudem die Arbeit pro Nonce verändern. Für die Übertragung maßgeblich bleibt das Prädikat über den Digest; Implementierungen müssen sich auf die Aussage und die Kodierung der Nonce einigen, nicht auf geschätzte CPU-Kosten.
Für unabhängige ideale Digests ist die Versuchszahl \(X\) geometrisch verteilt mit \(p = 2^{-b}\). Ihr Median ist \(\left\lceil \ln(1/2) / \ln(1-p) \right\rceil\), für kleine \(p\) ungefähr \(2^b \ln 2\), und ihre Varianz ist \((1-p)/p^2\). Der Verifizierer prüft einen einzigen Kandidaten-Digest, statt die Suche auszuführen. Parsen, Authentifizierung der Challenge, Prüfung des Fingerabdrucks, Eintrag in den Verbrauchszustand und die Antwort sind zusätzliche Arbeit. Eine Zeitmessung einer Primitive lässt sich nicht in die Flutkapazität eines Servers umrechnen.
Zwei Grenzen der Suche
Die erste ist die Varianz: Eine lange Suche bedeutet nicht unbedingt einen defekten Worker. Die zweite ist die Parallelität: Unabhängige Nonce-Versuche können gleichzeitig laufen. Mehr Kerne verkürzen die verstrichene Suchzeit, auch wenn die erwartete Gesamtzahl der Versuche gleich bleibt. Der Hardwaredurchsatz ist deshalb für die Zulassungsrichtlinie von Belang. Weder eine behauptete Hashrate noch ein einzelner Benchmark kann den Vorteil jedes Anfragenden begrenzen.
Nachweis sequenzieller Arbeit: Stufe zwei
Warum sequenzielle Arbeit
Eine Konstruktion für sequenzielle Arbeit führt Abhängigkeiten zwischen Berechnungen ein: Ein späteres Label benötigt einen früher erzeugten Wert. Damit geht es um eine andere Größe als die Gesamtarbeit, nämlich um die Tiefe der Berechnung. Unabhängige Rätsel können weiterhin parallel laufen, und die Hash-Latenz der Hardware spielt weiterhin eine Rolle.
Sibuna folgt der hashbasierten Konstruktion, die Cohen und Pietrzak beschrieben haben. Ihr Graph hat bei Tiefe \(n\) genau \(2^{n+1}-1\) Labels, aber eine feste Zahl von Labels ist keine deterministische Browserlatenz: Labels können mehrere Kompressionsblöcke umfassen, Öffnungen können Teilbäume neu berechnen, und das Scheduling fügt Schwankungen hinzu. Sicherheitsaussagen aus Analysen im Orakelmodell dürfen nicht zu einer uneingeschränkten Behauptung über jede konkrete Implementierung oder jeden Gegner gemacht werden.
Die Konstruktion
Sei \(n\) die Tiefe, und betrachten wir den vollständigen Binärbaum, dessen Knoten durch Binärzeichenketten der Länge höchstens \(n\) benannt sind (Wurzel \(\varepsilon\), Kinder \(v0\) und \(v1\), Blätter der Länge \(n\)). Jeder Knoten \(v\) trägt ein 32-Byte-Label \(\ell_v = H(\chi, v, \mathrm{parents}(v))\), wobei \(\chi\) die Challenge-Aussage ist und \(H\) SHA-256 mit einmal absorbiertem \(\chi\) (derselbe Präfix-Trick wie beim Hashcash-Löser):
- Ein innerer Knoten hasht seine beiden Kinder: \(\ell_v = H(\chi, v, \ell_{v0}, \ell_{v1})\);
- ein Blatt \(u = u_1 \dots u_n\) hasht die linken Geschwister seiner Vorfahren, wo immer der Pfad von der Wurzel nach rechts abgebogen ist: \(\ell_u = H(\chi, u, \{\ell_{u_1 \dots u_{i-1} 0} : u_i = 1\})\).
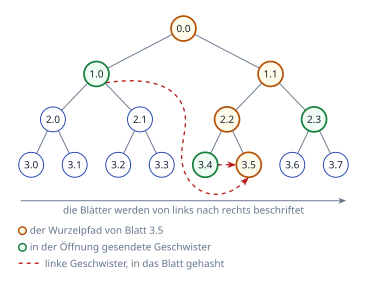
Die Kanten zu linken Geschwistern machen die Berechnung sequenziell: Blatt \(u\) kann erst beschriftet werden, wenn jeder Teilbaum links davon fertig ist. Damit ist eine Postorder-Tiefensuche erzwungen, und das Wurzellabel \(\varphi = \ell_\varepsilon\) hängt der Reihe nach von allen \(2^{n+1} - 1\) Labels ab.
Öffnungen. Nach der Berechnung von \(\varphi\) leitet der Beweiser per Fiat-Shamir \(t\) Blätter ab, \(\gamma_i = H(\chi \parallel \varphi \parallel i) \bmod 2^n\), und sendet für jedes das Blattlabel und die \(n\) Geschwisterlabels entlang seines Pfads zur Wurzel. Der Verifizierer berechnet das Blatt aus den Geschwistern, die seine Eltern sind, neu, hasht den Pfad aufwärts und prüft, dass er bei \(\varphi\) ankommt. Die Kosten des Verifizierers betragen \(O(tn)\) Labelberechnungen mit begrenztem Arbeitsbereich. Eine Labelberechnung kann mehrere Hash-Blöcke umfassen; Labels zu zählen heißt nicht, Kompressionsaufrufe zu zählen.
fn verify_opening(base: &Sha256, n: u8, phi: &Label, gamma: u32, opening: &[Label]) -> bool {
let Some((leaf, siblings)) = opening.split_first() else {
return false;
};
// `siblings` läuft von Tiefe n bis Tiefe 1; umgekehrt passt es zu den Tiefen 1..=n.
let mut hasher = node_hasher(base, n, gamma);
for (d, sibling) in (1..=n).zip(siblings.iter().rev()) {
if turns_right(gamma, n, d) {
hasher.update(sibling);
}
}
if hasher.finalize() != *leaf {
return false;
}
let mut current = *leaf;
for (d, sibling) in (1..=n).rev().zip(siblings) {
let mut parent = node_hasher(base, d - 1, gamma >> (n - d + 1));
if turns_right(gamma, n, d) {
parent.update(sibling);
parent.update(¤t);
} else {
parent.update(¤t);
parent.update(sibling);
}
current = parent.finalize();
}
current == *phi
}
Stichproben, Korrektheit und ihre Grenzen
Betrachten wir ein festes Commitment mit einem unabhängig erkennbaren fehlerhaften Anteil \(\alpha\). Zieht jede Öffnung gleichverteilt und unabhängig, so beträgt die Wahrscheinlichkeit, in \(t\) Öffnungen jede fehlerhafte Stelle zu verfehlen, \((1-\alpha)^t\). Diese elementare Rechnung erklärt, warum mehr Öffnungen helfen. Für sich genommen ist sie kein Sicherheitsbeweis für ein Protokoll sequenzieller Arbeit.
Die zitierte Konstruktion für sequenzielle Arbeit hat eine Sicherheitsanalyse in einem Orakelmodell. Sibunas Domänentrennung, Parameterzuordnung, Kürzung und Implementierung müssen dennoch gegen die Annahmen der Konstruktion geprüft werden. Fiat-Shamir-Stichproben machen Öffnungen aus einem Commitment reproduzierbar; Reproduzierbarkeit allein beweist keine Resistenz gegen Durchprobieren. Wir behaupten nicht bedingungslos, dass Betrug nie billiger ist.
Speicher des Beweisers
Ein naiver Beweiser speichert jedes Label (\(2^{n+1} - 1\) Stück). Sibunas Beweiser hält im ersten Durchlauf einen Stack der Labels der linken Geschwister des aktuellen Pfads (\(n + 1\) Labels) und behält nur die obersten \(m = \min(n, 10)\) Ebenen (\(2^{m+1} - 1\) Labels, höchstens 64 KB). Um ein Blatt zu öffnen, berechnet er den Teilbaum des Vorfahren des Blatts auf Tiefe \(m\) neu, \(2^{n-m+1} - 1\) Hashes, und füllt den Stack aus den behaltenen Ebenen vor. Die Gesamtkosten des Beweisers betragen \(2^{n+1} - 1 + t\,(2^{n-m+1} - 1)\) Hashes, und der gesamte Arbeitsbereich einschließlich des ausgegebenen Nachweises liegt unter 100 KB: Ein Browser-Tab und ein nativer Test teilen denselben Typ Workspace (sibuna_pow::posw::Workspace).
Parameter sind keine Zeitangaben
Sibuna bildet Arbeitsbits mit \(n = b - 3\) auf die Tiefe ab, begrenzt auf das unterstützte Intervall \([4, 24]\). Dies ist eine Konvention für die Arbeitsskala, keine Garantie gleicher Echtzeit zwischen den Algorithmen. Ein Blatt kann mehrere Elternlabels hashen, während Hashcash wiederholt eine Nonce testet. Compiler, Browser, Prozessor und Parameterwahl beeinflussen alle ihre relativen Kosten. Der eingecheckte Primitive-Benchmark misst die Verifikation; er belegt keine Lösungslatenz im Browser.
Die Nachweisgröße beträgt \(32(1 + t(n+1))\) Bytes. Bei Tiefe 13 mit sechzehn Öffnungen sind das \(32(1 + 16 \times 14) = 7200\) Bytes. Mehr Öffnungen vergrößern sowohl den Nachweis als auch die Arbeit des Verifizierers, selbst wenn die dominierenden Kosten für den Aufbau des Baums gleich bleiben.
Eine Konstruktion wählen
Der maßgebliche Vergleich ist ein Ressourcenbudget, nicht der Ruf eines Algorithmus. Wir halten den Speicher des Beweisers, die Arbeit des Verifizierers im schlechtesten Fall, die Nachweisbytes und die Annahmen fest, die für die behauptete Eigenschaft nötig sind. Speicherharte Suche kann nützlich sein, aber ein Verifizierer, der teure Arbeit wiederholen muss, gibt einem Angreifer eine weitere Stelle, an der er die Ressourcen des Servers verbrauchen kann. Öffentlich verifizierbare Verzögerungskonstruktionen dienen einem anderen Vertrauensmodell als ein Gate mit gemeinsamem Geheimnis.
Sibuna behält die billige Hash-Verifikation und eine hashbasierte Option für sequenzielle Arbeit. Letztere erfordert mehr Nachweisbytes und eine sorgfältigere Parameteranalyse. Keine der beiden Entscheidungen erspart es, fehlerhaft geformte Nachweise abzuweisen, bevor die teure Verifikation beginnt.
Symmetrische Authentifizierung: Challenges und Sitzungen
Aussteller gleich Verifizierer
Eine digitale Signatur lässt jeden, der den öffentlichen Schlüssel besitzt, verifizieren; das ist das richtige Werkzeug, wenn Verifizierer selbst keine Tokens ausstellen dürfen. Sibunas Verifizierer ist der Aussteller (oder ein Cluster, der einen Seed teilt). Ein Message Authentication Code, gebaut aus einer Pseudozufallsfunktion, liefert Authentifizierung innerhalb dieser Vertrauensdomäne. Öffentliche Verifikation liefert er nicht: Wer den MAC-Schlüssel besitzt, kann auch Tokens ausstellen. Das Benchmark-Kapitel vergleicht die implementierten Token-Operationen.
Eine zweite Folge ist auf lange Sicht wichtig: Ed25519 beruht auf diskreten Logarithmen in einer Gruppe elliptischer Kurven, die Shors Algorithmus bricht; ein schlüsselbasierter Hash beruht nur auf der Hashfunktion, gegen die Quantenalgorithmen höchstens eine quadratische Beschleunigung bringen. Sibuna behält Ed25519 als Option (--token-scheme ed25519) für Einsätze, die Verifizierer brauchen, die keine Tokens ausstellen können.
Der Schlüsselplan
Aus einem 32-Byte-Master-Seed (aus --secret-file, SIBUNA_SECRET oder einem frischen Zufallswert) werden mit BLAKE3 mit Schlüssel und einer Domänenzeichenkette alle Zweckschlüssel abgeleitet: die Schlüssel für Token, Challenge, Ed25519 und Fingerabdruck sowie der Anforderungsschlüssel, der Anforderungstickets versiegelt (Teil IV).
pub fn derive(seed: &Seed) -> Keys {
    Keys {
        token: subkey(seed, "sibuna/token/v1"),
        challenge: subkey(seed, "sibuna/challenge/v1"),
        ed25519_seed: subkey(seed, "sibuna/ed25519/v1"),
        fingerprint: subkey(seed, "sibuna/fingerprint/v1"),
        requirement: subkey(seed, "sibuna/requirement/v1"),
    }
}

fn subkey(seed: &Seed, purpose: &str) -> [u8; 32] {
    blake3::keyed_hash(seed.as_bytes(), purpose.as_bytes())
}
In einem Cluster ersetzt Keys::bind_node den Challenge-Schlüssel durch BLAKE3 mit diesem Schlüssel über sibuna/challenge-node/v1 und die Knoten-ID. So muss eine Challenge zu dem Knoten zurückkehren, der sie ausgestellt hat, während Sitzungstokens und Anforderungstickets auf jedem Mitglied gültig bleiben.
Domänentrennung verhindert die versehentliche Wiederverwendung über Zwecke hinweg; die Kompromittierung des Master-Seeds kompromittiert jeden abgeleiteten Schlüssel. Ein Cluster muss sich nur auf einen Seed einigen.
Zustandslose Challenges
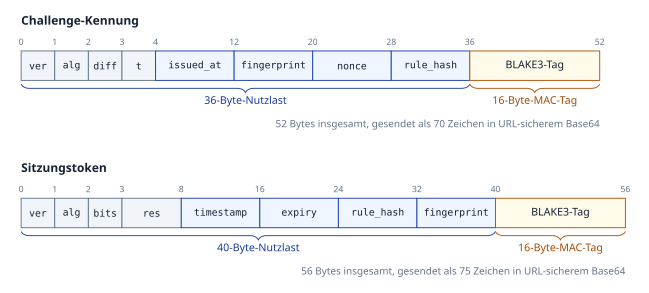
Eine Challenge-Kennung ist ein selbstauthentifizierender Datensatz: Version, Algorithmus, Schwierigkeit, Zahl der Öffnungen, Ausgabezeit, der schlüsselbasierte Fingerabdruck des Clients, eine per PRF abgeleitete Nonce und der Hash der Richtlinienregel, die die Challenge verlangt hat, gefolgt von einem 16-Byte-Tag unter dem Challenge-Schlüssel. Das Ausstellen schreibt nichts. Die Verifikation dekodiert den Datensatz, prüft das Tag in konstanter Zeit, prüft das Alter gegen die Challenge-TTL, prüft den Fingerabdruck gegen den einreichenden Client und untersucht erst dann den Nachweis.
Die Verbrauchsmenge besteht aus 16 Shards mit Robin-Hood-Open-Addressing über die 16-Byte-Tags (Teil V). Der Fingerabdruck ist ein schlüsselbasierter Hash von Clientadresse und User-Agent, längengetrennt, sodass keine zwei Eingaben durch Verkettung kollidieren, und mit Schlüssel, sodass Fingerabdrücke anderer Clients nicht offline berechnet werden können.