제V부: Rust 무할당 엔지니어링
고정 버퍼 하나를 따라 연결을 accept부터 응답까지 추적하고, 여러 연결 스레드가 요청 경로에서 힙 할당 없이 상태를 공유하게 해 주는 동시성 데이터 구조를 살펴봅니다. 메모리 안전성을 지키려면 별도의 장치(읽는 쪽 카운트, 아레나, 디스크립터 테이블, 해제 연쇄)가 필요했을 곳에서는 Rust 소유권이 그 역할을 대신하는 방식을 보여 줍니다.
연결 루프
연결당 스레드 하나, 개수는 제한
accept 워커(--workers, 기본값은 CPU당 하나, 최대 64)는 리스닝 소켓을 공유합니다. 받아들인 연결은 각각 1메가바이트 스택을 가진 전용 스레드에 넘기고, accept 루프는 곧바로 accept로 돌아갑니다. 연결 처리를 마친 스레드는 대기하다가 다음 연결을 맡습니다. 연결마다 스레드를 만들고 끝내면 다른 스레드가 멈췄기 때문입니다(제VIII부, SID 0002). 다른 방식, 즉 accept 스레드에서 연결을 끝까지 처리하는 방식이 첫 설계였습니다. 이 방식은 클라이언트 하나로는 측정 결과가 좋았지만 64개로는 나빴습니다. 그중 60개가 워커가 요청 256개 할당량을 마칠 때까지 기다렸고, 기다리는 클라이언트가 늘 때마다 꼬리 지연이 커졌기 때문입니다. 연결당 스레드를 쓰면 연결 64개에서 p99가 모든 전체 제품 워크로드에서 305 us에서 857 us 사이로, 1밀리초 미만에 머뭅니다(benchmarks/results/product-latest.md, 제VIII부).
연결 스레드 수는 --max-connections(기본값 1,024, 최대 8,192)로 제한됩니다. 한도를 넘으면 accept 루프는 아무것도 생성하지 않고 새 소켓에 503 Service Unavailable로 응답한 뒤 소켓을 닫고, 이를 sibuna_overloaded_total에 집계합니다.
fn accept_loop(server: &Arc<Server>, listener: &TcpListener) {
    while !server.is_stopping() {
        let stream = match listener.accept() {
            Ok((stream, _)) => stream,
            // ... 디스크립터나 메모리가 부족하면 스핀하지 않고 1 ms 물러난다
        };
        let limit = server.max_connections.load(Ordering::Relaxed);
        if server.connections.fetch_add(1, Ordering::Relaxed) >= limit {
            server.connections.fetch_sub(1, Ordering::Relaxed);
            server.metrics.overloaded.bump();
            let text = "Service Unavailable: connection limit reached";
            reject(server, &stream, text);
            continue;
        }
        set_no_delay(&stream);
        let task_server = Arc::clone(server);
        let launched = server.tasks.launch(move || {
            let _counted = Counted(&task_server);
            crate::connection::serve(&task_server, &stream);
        });
        // ... 실행에 실패하면 자리를 돌려주고 과부하로 집계한다
    }
}
Counted는 가드이며, 그 Drop은 스레드가 반환으로 끝나든 패닉으로 끝나든 연결이 차지한 한도의 자리를 돌려줍니다. 503 경로는 소켓에서 자기 쪽을 종료하기 전에 클라이언트가 이미 보낸 데이터를 비워 냅니다. 읽지 않은 바이트가 남은 소켓을 닫으면 리셋으로 응답하게 되고, 그 리셋이 503을 버리기 때문입니다.
스레드는 join할 수 있는 슬롯으로 이루어진 고정 테이블인 TaskPool(cmd/sibuna/src/tasks.rs)에서 가져옵니다. 끝난 스레드는 join될 때까지 스택을 유지하므로 슬롯은 다시 차지될 때 join되며, 새 작업은 커서를 전진시키지 않고 끝난 슬롯 가운데 가장 낮은 슬롯을 가져갑니다. 커서를 쓰면 테이블을 한 바퀴 다 돌아야 끝난 슬롯에 다시 닿으므로 끝난 스레드 수천 개가 메모리에 남고, 메모리는 열린 연결 수가 아니라 처리한 연결 수에 따라 늘어납니다. 두 번째 가드인 Finished는 작업이 끝나면 슬롯을 빈 것으로 표시하므로, 패닉한 연결도 슬롯을 반납합니다.
메모리도 같은 방식으로 제한됩니다. 연결 스레드는 64 KiB 읽기 버퍼와 16 KiB 쓰기 버퍼를 스택에, 40 KiB 프록시 작업 공간을 힙에 두며, 힙 공간은 연결이 시작될 때 한 번만 할당합니다. 따라서 최악의 경우 메모리 사용량은 클라이언트가 열 수 있는 소켓 수에 좌우되지 않고 미리 알 수 있는 값입니다. 유휴 연결 회수기(아래 참조)는 보내기를 멈춘 연결을 닫으므로, 느린 클라이언트는 --idle-timeout을 넘어 스레드를 붙잡을 수 없습니다.
할당자 선택
Rust 1.100은 Allocator API의 핵심과 Vec, ``Box``의 할당자 매개변수를 안정화합니다(릴리스 노트). 우리는 프로세스의 할당자를 교체하지 않고 개별 컬렉션의 할당자를 선택할 수 있습니다. 이 API로 요청 경로의 할당을 더 줄일 수는 없습니다. 준비된 연결의 요청은 이미 메모리를 할당하지 않으며, ``cmd/sibuna/tests/steady_state.rs``와 ``crates/net/tests/steady_state.rs``가 이를 검사합니다. 프록시는 연결마다 세 버퍼를 한 번 할당하고 재사용합니다. 제한기와 사용된 증명 집합도 테이블을 한 번만 할당합니다. 0으로 초기화하는 할당 덕분에 건드리지 않은 페이지는 상주하지 않아도 되며, ``crates/store/tests/resident.rs``가 이를 검사합니다.
할당자 변경을 조사할 때 우리는 먼저 정책 스냅샷 구성과 콘솔 JSON 파싱을 측정합니다. 임시 컬렉션은 요청 경로 밖에서 메모리를 할당하지만 컬렉션의 할당자가 요소의 할당까지 자동으로 관리하지는 않습니다. JSON 트리는 이스케이프된 문자열도 ``Cow<str>``를 통해 소유하며, 소유 형태는 ``String``입니다. Rust 1.100의 ``String``에는 할당자 매개변수가 없습니다. ``Arc::new_in``도 이 릴리스에서는 여전히 불안정합니다(API 문서). 게시한 엔진은 마지막 읽기 사용자가 해제할 때까지 ``Arc``로 공유되므로 재구성 중에 이전 엔진이 아직 사용하는 메모리를 초기화할 수 없습니다. 아레나는 이러한 수명과 파서의 입력 한도를 보존해야 합니다.
우리는 ``cmd/console-ui/src/abi.rs``에 있는 콘솔 WebAssembly 모듈의 기존 전역 할당자 ``WipeOnFree``를 유지합니다. 이 할당자는 재할당 후의 이전 블록을 포함하여 해제하는 블록을 지웁니다. 컬렉션에 ``System``을 직접 선택하면 이 지우기를 우회합니다. 작업 증명 WebAssembly 모듈에는 힙 할당자가 없고, Argon2도 호출자가 소유하는 작업 공간을 이미 재사용합니다. 따라서 측정한 작업 부하가 변경을 정당화할 때까지 기존 할당자와 Rust 1.94 호환성을 유지합니다. 후보는 지우기, 한도가 있는 입력 처리, 할당 없는 요청 경로를 보존하면서 지연 시간이나 상주 메모리를 개선해야 합니다.
연결당 버퍼 하나
요청 경로의 모든 동적 할당은 서비스 거부 공격의 지렛대가 됩니다. 며칠에 걸친 단편화, 스레드 사이의 할당자 락 경합, 그리고 할당이 최대가 되도록 요청을 조작하는 공격자의 증폭이 그렇습니다. Sibuna의 규칙은 절대적입니다. 분류, 검증, 프록시 전달은 힙 할당 없이 동작합니다. 연결 처리기는 소켓의 수명 동안 64 KiB 읽기 버퍼와 16 KiB 쓰기 버퍼를 소유하며, 그 밖의 모든 것은 이 버퍼를 가리키는 슬라이스입니다.
pub fn serve(server: &Server, stream: &TcpStream) {
    let Some(lease) = server.idle.register(stream) else { return };
    // ...
    let mut read_buffer = [0u8; MAX_REQUEST_BYTES]; // 64 KiB
    let mut write_buffer = [0u8; WRITE_BUFFER]; // 16 KiB
    let mut reader = Reader::new(stream, &mut read_buffer[..]);
    let mut peer = PeerText::default();
    peer.format(stream.peer_addr().ok());
    let mut link = Link {
        server,
        stream,
        writer: Writer::new(stream, &mut write_buffer[..]),
        workspace: Workspace::new(),
        cache: EngineCache::new(),
        activity: lease.activity(),
        last: false,
    };
    for served in 0..MAX_REQUESTS_PER_CONNECTION {
        link.last = served + 1 == MAX_REQUESTS_PER_CONNECTION;
        if !serve_one(&mut reader, &mut link, peer.as_bytes()) {
            break;
        }
        lease.touch();
    }
}
read_head는 빈 줄이 나타날 때까지 버퍼를 채우되 마지막 탐색 이후 도착한 바이트만 탐색하며, 16 KiB를 넘는 헤드는 431로 거부합니다. parse_request(crate sibuna-http)는 메서드, 경로, 쿼리, 헤더, 쿠키가 모두 버퍼의 슬라이스인 Request<'a>를 만듭니다. 선언된 본문은 들어갈 수 있는 만큼 채운 뒤 헤드 뒤에서 슬라이스로 잘라 냅니다. 그다음 reader.consume(head_len + body_len)이 리더를 전진시키므로 다음 keep-alive 요청은 깨끗하게 시작합니다. 리더는 공간이 필요할 때에만 읽지 않은 바이트를 앞으로 옮깁니다. chunked 본문은 헤드 뒤에서 제자리에서 디코딩합니다(SID 0009). 각 단계의 프레이밍을 버퍼에서 잘라 내므로 디코딩된 앞부분은 연속된 상태로 남아 검사할 수 있습니다. 내부 경로는 길이로 구분되며 연결을 열어 둡니다. 프록시된 요청도 원본 서버의 응답에 프레이밍이 있고 본문을 모두 버퍼에 담았다면 연결을 열어 둡니다. 프록시가 이를 어떻게 결정하는지는 다음 절에서 봅니다.
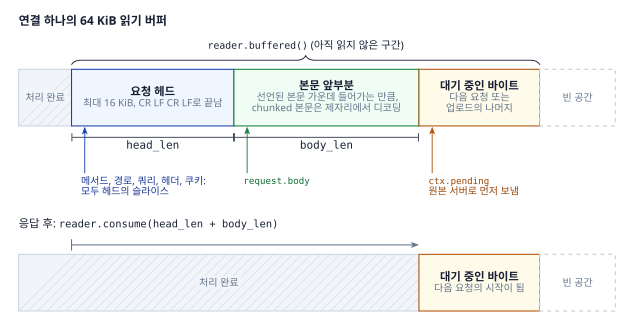
fn serve_one<W: Write>(
    reader: &mut Reader<'_, &TcpStream>,
    link: &mut Link<'_, W>,
    peer: &[u8],
) -> bool {
    let head_len = match read_head(reader) {
        Head::Complete(length) => length,
        Head::TooLarge => { /* 431 "Request head exceeds 16 KB" */ return false; }
        Head::Closed | Head::Failed => return false,
    };
    let framing = {
        let bytes = reader.buffered();
        let head = bytes.get(..head_len).unwrap_or_default();
        let request = match parse_request(head) {
            Ok(request) => request,
            Err(error) => return reject_head(link, error),
        };
        let declared = request.content_length().unwrap_or(0);
        // ... Expect: 100-continue
        if declared == 0 && !request.chunked {
            let upload = Upload::declared(&request);
            let pending = bytes.get(head_len..).unwrap_or_default();
            let keep = dispatch(link, request, pending, upload, 0, peer);
            reader.consume(head_len);
            return keep;
        }
        (declared, request.chunked)
    };
    serve_with_body(reader, link, peer, head_len, framing)
}
프록시 헤드 재작성
헤드는 그대로 전달하지 않습니다. write_request_head(crates/net/src/request.rs, crate sibuna-net)는 요청 줄과 각 헤더를 원본 라이터로 다시 내보내면서 다음을 제거합니다. 홉 단위 필드(Connection, Keep-Alive, Proxy-Connection, Transfer-Encoding, TE, Trailer, Upgrade, 프록시 인가 필드), 요청에 이미 들어 있는 전달 필드나 감사 필드(X-Forwarded-For, X-Real-IP, Forwarded, X-Forwarded-Proto, X-Forwarded-Host, X-Forwarded-Port, X-Sibuna-Status, X-Sibuna-Rule), Expect, Content-Length, 그리고 요청의 Connection 헤더가 지정하는 모든 필드입니다. 그런 다음 감사 필드 집합을 덧붙입니다. 본문 프레이밍은 복사하지 않고 새로 만듭니다.
for header in request.headers() {
    if is_hop_by_hop(header.name) || nominated(request, header.name) {
        continue;
    }
    out.write_all(header.name)?;
    out.write_all(b": ")?;
    out.write_all(header.value)?;
    out.write_all(b"\r\n")?;
}
match upload {
    Upload::None => {}
    Upload::Length(length) => {
        out.write_all(b"Content-Length: ")?;
        write_decimal(out, *length)?;
        out.write_all(b"\r\n")?;
    }
    Upload::Chunked(_) => out.write_all(b"Transfer-Encoding: chunked\r\n")?,
}
Content-Length는 다시 내보냅니다. 연결 버퍼 안에서 끝난 chunked 본문은 제자리에서 디코딩해 길이와 함께 보냅니다. 더 긴 본문은 Transfer-Encoding: chunked로 알리고 읽기 한 번마다 다시 청크로 나눕니다(SID 0009). 읽은 데이터는 프록시의 16 KiB 업로드 버퍼에 들어가 그 자리에서 디코딩되고 정규화된 청크 하나로 나가므로, 원본 서버는 클라이언트의 청크 크기, 확장, 트레일러를 결코 보지 못합니다. 감사 필드 집합은 다음과 같습니다.
Connection: keep-alive
X-Forwarded-For: <client>
X-Forwarded-Proto: <scheme>
X-Real-IP: <client>
X-Sibuna-Status: PASS
X-Sibuna-Rule: session | robots-txt | ip/cidr-trie | ...
버퍼보다 큰 본문은 응답을 스트리밍해 돌려주기 전에 클라이언트에서 원본 라이터로 16 KiB 조각 단위로 릴레이합니다(relay_body). crates/net/src/request.rs의 단위 테스트 proxy_head_rewrite_drops_hop_by_hop_headers_and_injects_audit_fields는 재작성이 위조된 X-Forwarded-For를 제거하고 감사 필드를 주입하는지 확인합니다.
프록시의 버퍼 세 개, 즉 원본 읽기 버퍼(응답 헤드 하나, 16 KiB), 원본 쓰기 버퍼(8 KiB), 업로드 버퍼(16 KiB)는 연결이 한 번 할당해 모든 요청에 재사용하는 Workspace 안에 있습니다. 작업 공간 덕분에 버퍼의 수명은 교환 하나가 아니라 연결 전체와 같아지고, 원본 리더와 라이터는 한 번에 교환 하나 동안만 버퍼를 빌립니다.
원본 응답 릴레이
첫 프록시는 원본 서버가 연결을 닫을 때까지 원본의 바이트를 스트리밍한 뒤 클라이언트 연결을 닫았습니다. 파싱 없이 올바른 프레이밍을 얻지만, 프록시하는 요청마다 새 TCP 연결이라는 대가를 치렀습니다. 부하 생성기를 돌리면 이 대가가 TIME_WAIT 상태의 소켓 수만 개로, 루프백에서는 임시 포트 고갈로 드러났습니다. 이제 프록시는 원본의 헤드(최대 16 KiB)를 읽고 RFC 9112의 규칙에 따라 본문을 분류합니다.
pub enum Framing { None, Length(u64), Chunked, UntilClose }

pub fn parse_response_head(
    head: &[u8],
    head_request: bool,
) -> Option<ResponseHead> {
    let status = status_code(head)?;
    let mut fields = FramingFields {
        keep_alive: head.get(7) == Some(&b'1'),
        ..Default::default()
    };
    for line in crlf_lines(head).skip(1) {
        if line.is_empty() {
            break;
        }
        fields.read_line(line)?; // Transfer-Encoding, Content-Length, Connection
    }
    let mut framing = fields.length.map_or(Framing::UntilClose, Framing::Length);
    if head_request || status / 100 == 1 || status == 204 || status == 304 {
        framing = Framing::None;
    } else if fields.encoded {
        framing =
            if fields.chunked { Framing::Chunked } else { Framing::UntilClose };
    }
    let mut keep_alive = fields.keep_alive;
    if framing == Framing::UntilClose || fields.closing {
        keep_alive = false;
    }
    if fields.nominates_framing {
        return None;
    }
    Some(ResponseHead { status, framing, keep_alive })
}
파서는 프록시가 릴레이해서는 안 되는 것을 거부합니다. 잘못된 상태 줄, 토큰이 아닌 필드 이름, 값 안의 제어 바이트, 서로 충돌하는 길이, 반복되거나 마지막이 아닌 chunked 코딩, Content-Length나 Transfer-Encoding을 지정하는 Connection 필드입니다. 파서의 작업량은 헤드 길이에 선형이며, 결코 패닉하지 않습니다.
헤드는 원본의 Connection 헤더를 Sibuna 자신의 결정으로 바꾼 뒤 클라이언트에 다시 내보내고, 본문은 정확히 릴레이합니다. 길이가 있으면 copy_exact, chunked 코딩이면 청크 단위(크기 줄, 데이터, 트레일러), 레거시 방식이면 copy_remaining을 씁니다. 클라이언트 연결을 닫는 것은 레거시 방식뿐입니다. 모든 릴레이는 하나의 복사 단계 위에 만들어져 있습니다. 소스가 이미 가진 데이터는 모두 전달하고, 아무것도 없을 때에만 대상을 플러시한 뒤 한 번 읽습니다. 따라서 작은 쓰기가 이어지는 스트림은 만들어지는 즉시 전달되고, 대량 전송은 여전히 읽기와 쓰기 한 번마다 버퍼 하나를 가득 옮깁니다.
let keep = client_keep_alive && parsed.framing != Framing::UntilClose;
write_client_head(client, head, keep).map_err(client_head_error)?;
origin.consume(head_length);
match parsed.framing {
    Framing::None => {}
    Framing::Length(length) => copy_exact(origin, client, length, progress)?,
    Framing::Chunked => relay_chunked(origin, client, progress)?,
    Framing::UntilClose => copy_remaining(origin, client, progress)?,
}
client.flush().map_err(|_| ProxyError::ClientFailed)?;
Ok(Relayed { client_keep: keep, origin_reusable: parsed.keep_alive })
필드 여덟 개짜리 원본 헤드를 파싱하는 데 322 ns가 걸리고, 응답이 1 KiB인 keep-alive GET을 루프백으로 프록시하는 데 29.8 us가 걸립니다(2026년 10월 측정, crates/net/src/lib.rs에 측정 방법이 문서화되어 있습니다).
원본 연결 풀
프레이밍을 파싱하면 원본 소켓을 다시 쓸 수 있는지도 알 수 있습니다. Connection: close가 없는 HTTP/1.1 응답(또는 keep-alive가 있는 HTTP/1.0 응답)의 본문을 모두 소비했다면, 소켓은 깨끗한 요청 경계에 놓입니다. 그런 소켓은 유휴 원본 연결 256개짜리 고정 풀에 들어가고, 다음에 프록시하는 요청은 새로 연결하는 대신 그 소켓을 가져갑니다. 풀이 없으면 프록시하는 요청마다 새 원본 연결을 열고, 닫힌 연결마다 로컬 포트를 TIME_WAIT에 붙잡아 둡니다. 부하가 걸리면 루프백 위의 프록시는 곧 임시 포트가 바닥나고 처리량이 급락합니다.
풀을 락 하나로 보호하면 프록시하는 모든 요청이 그 락을 두고 경합합니다. 그래서 풀(crates/net/src/pool.rs)은 스트라이프로 나뉩니다. 소켓 16개짜리 스트라이프 16개이며, 각 스트라이프는 각자의 캐시 라인에 놓인 Mutex<Vec<Arc<TcpStream>>>입니다. 스레드는 처음 쓸 때 라운드 로빈으로 홈 스트라이프를 배정받고, 소켓을 반납하거나 가져갈 때 그 스트라이프를 먼저 쓰며, 새로 연결하기 전에 다른 스트라이프도 살펴봅니다. 이때 다른 스레드가 잡은 락은 기다리지 않습니다.
pub fn take(&self) -> Option<Arc<TcpStream>> {
    if self.is_stopping() {
        return None;
    }
    let home = home_stripe();
    if let Some(socket) =
        self.stripe(home).and_then(|stripe| lock(&stripe.sockets).pop())
    {
        return Some(socket);
    }
    (1..STRIPES).find_map(|offset| {
        let stripe = self.stripe((home + offset) % STRIPES)?;
        try_lock(&stripe.sockets)?.pop()
    })
}
풀에 있던 소켓은 유휴 상태로 있는 동안 원본 서버가 이미 닫았을 수 있습니다. 프록시는 이를 두 가지 방식, 즉 쓰기 실패나 첫 응답 바이트 전의 스트림 끝으로 알아차립니다. 두 경우 모두 아직 클라이언트에 아무것도 전달되지 않았으므로, 소켓을 닫고 새 연결로 한 번 재시도합니다. 다른 풀 소켓으로는 결코 재시도하지 않습니다. 유휴 기간이 지나면 풀의 소켓이 모두 이미 끊겼을 수 있는데, 두 번째 풀 소켓을 가져가던 이 재시도의 첫 버전은 조용한 기간이 지날 때마다 첫 요청에 502로 응답했습니다. 재시도는 본문을 모두 버퍼에 담은 안전한 메서드(GET, HEAD, OPTIONS)에만 허용됩니다. 응답이 없다고 원본 서버가 변경을 커밋하지 않았다는 증거가 되지는 않으며, 조각으로 릴레이한 본문은 다시 보낼 수 없습니다. 두 경우 모두 클라이언트는 502를 받습니다.
let safe = matches!(request.method, Method::Get | Method::Head | Method::Options);
let buffered = exchange.upload.is_buffered(request.body.len());
let retryable = safe && buffered;
for attempt in 0..2 {
    // 재시도는 언제나 새로 연결한다. 유휴 기간이 지나면 풀의 소켓이 모두
    // 끊겼을 수 있고, 끊긴 소켓을 또 쓰면 요청이 실패한다.
    let pooled = if attempt == 0 { pool.take() } else { None };
    // ... 풀에 소켓이 없으면 연결하고, activity에 붙인 뒤 교환한다
    match outcome {
        Ok(relayed) => {
            if relayed.origin_reusable {
                pool.give(origin);
            }
            return Ok(relayed.client_keep && buffered);
        }
        Err(error) => {
            drop(origin);
            let stale = was_pooled
                && retryable
                && matches!(
                    error,
                    ProxyError::UpstreamClosed | ProxyError::UpstreamWriteFailed
                );
            // ... 그 밖의 오류는 즉시 보고한다
        }
    }
}
단위 테스트는 고정된 바이트 문자열을 같은 함수로 릴레이하고, 연결 헤더를 제외하면 출력이 바이트 단위로 같은지 확인합니다(crates/net/src/relay/tests.rs). 데몬의 종단 간 테스트는 클라이언트 소켓 하나로 프록시 요청 두 개를 보내고, 스텁 원본 서버가 붙이는 순번 헤더로 두 번째 요청이 풀의 원본 연결을 재사용했는지 확인합니다. crates/net/tests/의 벡터 테스트는 기록된 프록시 시나리오(원시 클라이언트 요청과 미리 준비한 원본 응답)를 재생하고 원본 서버와 클라이언트가 받는 모든 바이트를 비교합니다.
유휴 기한
모든 클라이언트 연결은 소켓을 IdleTable(crates/net/src/idle.rs)에 등록하고 Lease를 받습니다. 리스의 Activity는 연결에서 바이트가 마지막으로 움직인 시각을 담습니다. 데몬은 요청을 하나 처리할 때마다 이를 갱신하고, 프록시는 원본에서 읽을 때마다, 그리고 업로드 16 KiB마다 갱신하며 진행 중인 교환의 원본 소켓을 붙여 둡니다. 회수기 스레드는 가장 짧은 타임아웃의 4분의 1마다(200 ms에서 1초 사이) 깨어나, 타임아웃보다 오래 조용했던 모든 연결을 붙어 있는 원본 소켓과 함께 종료합니다. 그러면 어느 쪽에서든 막혀 있던 스레드가 스트림 끝을 보고 슬롯을 놓아줍니다.
따라서 기한은 응답이 얼마나 긴지가 아니라 연결이 얼마나 오래 조용했는지를 잽니다. 계속 움직이는 큰 다운로드는 결코 끊기지 않습니다. 업로드 바이트는 신뢰할 수 없는 쪽에서 오므로 16 KiB마다 한 번만 시각을 갱신합니다. 이는 클라이언트에게 유휴 기간마다 최소 16 KiB를 요구하는 셈으로, 최소 전송 속도 기반 요청 타임아웃이 제공하는 느린 본문 공격 방어와 같습니다.
테이블에는 슬롯마다 작은 락이 하나 있고 테이블 전체 락은 없습니다. 위에서 말한 이유로 테이블은 각 클라이언트 소켓의 try_clone과 붙어 있는 각 원본 소켓의 Arc를 담습니다. Lease는 Drop에서 연결 등록을 해제하며, 회수된 슬롯은 그때까지 리스가 소유하므로, 옛 연결이 새 연결이 차지한 슬롯을 해제하는 일은 결코 일어나지 않습니다.
업그레이드된 연결
검증된 101 뒤에는 WebSocket 업그레이드를 양방향으로 릴레이합니다. 각 방향은 고정 버퍼 하나를 가진 전용 스레드에서 실행됩니다. 연결 자신의 스레드는 원본에서 클라이언트로 가는 바이트를, 128 KiB 스택을 가진 scoped 스레드는 클라이언트에서 원본으로 가는 바이트를 나릅니다. 스레드 하나가 poll(2)로 두 방향을 모두 처리할 수도 있지만 Rust 표준 라이브러리는 이를 노출하지 않습니다. 소켓 타임아웃을 건 스레드 두 개를 쓰면 릴레이에 unsafe가 필요 없습니다. 따라서 업그레이드된 연결은 스레드 두 개를 차지하므로, 모든 연결이 업그레이드되면 연결 스레드 수가 --max-connections의 두 배에 이를 수 있습니다.
두 방향은 유휴 기한 하나(--websocket-idle-timeout, 기본값 300초)를 공유합니다. 어느 방향으로 바이트가 움직이든 같은 시각 하나를 갱신합니다. 소켓 대기마다 남은 시간과 같은 타임아웃을 두며, 타임아웃이 난 대기는 공유 시각을 다시 읽고 나머지 시간만큼 다시 기다리거나 릴레이를 끝냅니다. 한 방향이 스트림 끝에 이르면 다른 소켓의 보내는 쪽을 종료합니다(half close). 한 방향이 실패하면 두 소켓을 모두 종료해 다른 방향도 끝나게 합니다. 업그레이드를 프록시하기 전에 연결은 캐시한 정책 엔진을 놓아주므로, 몇 시간 동안 살아 있을 수 있는 연결이 옛 엔진을 살려 두지 않습니다.
중지
Running::stop과 Running의 Drop은 모두 정해진 순서로 데몬을 중지합니다. 중지 플래그를 설정하고 리스너에 연결해 모든 accept 워커를 깨우고, 워커를 join하고, 등록된 모든 클라이언트 소켓과 붙어 있는 원본 소켓을 종료하고(IdleTable::shutdown), 원본 연결 풀을 멈추고, 모든 연결 스레드를 join하고, 회수기를 join한 뒤, 풀의 소켓을 닫습니다.
SIGINT와 SIGTERM을 받으면 평범한 Rust 코드를 거쳐 이 절차가 실행됩니다. 데몬은 스레드를 띄우기 전에 두 시그널을 블록하고(이후의 모든 스레드는 이 마스크를 물려받습니다) 스레드 하나를 sigwait 전용으로 둡니다. 이 스레드는 요청을 기록하고 메인 스레드를 즉시 깨웁니다. 시그널 처리기 안에서 실행되는 코드는 없고, 플래그를 폴링하는 스레드도 없습니다. 시그널 모듈(cmd/sibuna/src/signals.rs)에는 데몬의 유일한 unsafe 코드가 있습니다. std가 감싸지 않는 몇 가지 C 라이브러리 함수의 선언입니다.
측정한 내용
표는 Ryzen 9 5950X 한 대에서 리버스 프록시 모드로 실행한 Shield를 보여 줍니다. 데몬은 CPU 네 개에 고정하고, wrk는 다른 CPU 여덟 개에서 스레드 두 개와 연결 64개로 실행했으며, 5초씩 세 번 실행한 중앙값입니다. 행은 benchmarks/results/product-latest.md에서 옮겨 왔으며, 전체 기록은 제VIII부에 있습니다.
| 워크로드 | 상태 | req/s | p50 / p99 (us) | 요청당 CPU 시간(us) |
|---|---|---|---|---|
| 세션으로 허용, 프록시됨 | 200 | 138,965 | 438 / 857 | 28.57 |
| 챌린지(중간 페이지) | 200 | 195,188 | 162 / 328 | 13.73 |
| 정적 경로 허용, 프록시됨 | 200 | 145,673 | 415 / 746 | 27.27 |
| WAF 거부(세션 있음) | 403 | 209,507 | 151 / 306 | 12.17 |
wrk는 요청 64개를 계속 진행 중으로 유지하므로, CPU가 병목인 프록시 경로에서는 요청이 CPU 네 개를 기다리며 줄을 서고, 여기서 p99는 요청 하나의 비용이 아니라 스케줄러의 꼬리입니다. 반면 정해진 속도로 보내고 각 요청을 원래 보내려던 시각부터 재는 개방 루프 생성기는 같은 제공 부하에서 지연을 측정합니다. 리버스 프록시 모드에서 허용된 요청의 p99는 초당 요청 10,000개에서 65 us, 100,000개에서 100 us입니다. 150,000개를 제공하면 CPU 네 개가 포화되어 초당 134,344개 요청을 처리하고, 큐 대기는 수 초로 늘어납니다(benchmarks/results/latency-latest.md). 예열된 keep-alive 연결은 모든 결정을 힙 할당 없이 처리합니다. cmd/sibuna/tests/steady_state.rs는 데몬의 할당을 세며, crates/net/tests/steady_state.rs는 프록시한 keep-alive 요청 500개 동안 할당을 하나도 찾지 못합니다.
할당 없는 동시성 상태
sibuna-store의 모든 저장소는 만들어질 때 고정 용량을 한 번 할당하며, 그 뒤로는 할당하지도 전역 락을 기다리며 멈추지도 않습니다. 백그라운드 청소기가 필요한 저장소도 없습니다. 만료된 상태는 그 자리에서 회수됩니다.
락과 샤딩
Sibuna 테이블의 임계 구역은 명령어 수십 개 길이로, 커널 futex 왕복보다 훨씬 짧습니다. 테이블은 키 해시로 샤드 16개에 나뉘므로 두 연산이 경합할 확률은 \(1/16\)이며, 각 샤드는 각자의 캐시 라인에 놓이므로 이웃한 락끼리 거짓 공유가 일어나지 않습니다.
테이블은 std::sync::Mutex를 사용합니다. 경합이 없으면 compare-and-swap 한 번, 보유자가 실행 중이면 짧은 스핀, 그다음 futex 대기입니다. 대안은 대기 루프에 스핀 루프 힌트를 넣은 두 상태 원자적 스핀 락입니다. SID 0010은 둘 사이에서 측정으로 고르도록 요구했습니다. 스핀 락은 경합 없는 연산마다 약 1나노초를 아끼지만, 경합이 생기면 뒤처집니다.
| 워크로드 | Mutex |
스핀 락 |
|---|---|---|
| 사용 완료 집합, 스레드 16개 | 10.8 M/s | 8.6 M/s |
| 사용 완료 집합, 스레드 64개(CPU 수보다 많음) | 11.2 M/s | 6.9 M/s |
| 요청이 몰리는 주소 여섯 개에 대한 GCRA, 스레드 16개 | 44.9 M/s | 19.3 M/s |
| 요청이 몰리는 주소 여섯 개에 대한 GCRA, 스레드 64개 | 37.4 M/s | 6.5 M/s |
엣지 서버는 CPU 수보다 많은 연결 스레드를 실행하며, 보유자가 선점된 스핀 락은 모든 대기자가 자기 시간 조각을 태우게 만듭니다. 그래서 뮤텍스를 유지합니다. 오염된(poisoned) 락은 오류를 전파하지 않고 그대로 진입합니다. 어떤 연산도 샤드를 잡은 동안 패닉하지 않으며, 설령 패닉하더라도 샤드는 구조적으로 유효한 상태로 남습니다.
Robin Hood 사용 완료 집합
사용 완료 집합에는 받아들여진 증명만 들어갑니다(제III부). 집합에는 샤드 16개가 있고, 각 샤드는 Option<Entry> 슬롯 4,096개짜리 개방 주소 배열이며, 항목은 { tag: [u8; 16], expires_at: u64, dist: u8 }입니다. Robin Hood 삽입(Celis, 1986)은 들어오는 키보다 자기 홈에 더 가까운 점유자를 밀어내므로 탐사 길이의 편차가 작게 유지됩니다. 조회는 찾는 키가 자기 홈에서 떨어진 거리보다 자기 홈에 더 가까이 있는 항목을 만나는 즉시 멈춥니다.
fn insert(
    &mut self,
    tag: &Tag,
    expires_at: u64,
    now: u64,
) -> Result<(), SpendError> {
    if !self.can_insert(tag, now) {
        return Err(SpendError::Full);
    }
    let mut carry = Entry { tag: *tag, expires_at, dist: 0 };
    let mut idx = Self::home(tag);
    while carry.dist < MAX_PROBE {
        let slot = &mut self.entries[idx];
        let Some(e) = slot else {
            *slot = Some(carry);
            return Ok(());
        };
        // 만료된 점유자를 덮어써도 안전한 것은 새 거리가 더 작지 않을 때뿐이다.
        // 그래야 이 슬롯을 지나 탐사하는 키가 여전히 조기 종료 검사를
        // 통과한다.
        if e.is_expired(now) && carry.dist >= e.dist {
            *e = carry;
            return Ok(());
        }
        if carry.dist > e.dist {
            std::mem::swap(&mut carry, e);
            // 밀려난 만료 항목은 그냥 버린다.
            if carry.is_expired(now) {
                return Ok(());
            }
        }
        idx = (idx + 1) % SHARD_CAPACITY;
        carry.dist += 1;
    }
    Err(SpendError::Full)
}
미묘한 부분은 만료된 슬롯 규칙입니다. 만료된 항목은 자기 홈에서 적어도 그만큼 먼 키로만 제자리에서 덮어쓸 수 있습니다. 그렇지 않으면 그 슬롯을 지나 탐사하는 나중 키가 일찍 멈춰 사라집니다. 밀려난 만료 항목은 그냥 버립니다. 청소 스레드는 필요 없습니다. 삽입은 먼저 아무것도 바꾸지 않고 밀어내기 경로를 모의 실행하여(can_insert), 횟수가 제한된 밀어내기가 살아 있는 태그를 잃지 않고 성공할 수 있는지 확인합니다.
슬롯은 Option<Entry>입니다. 빈 슬롯에는 읽을 태그가 없으므로, 읽는 쪽이 확인을 잊을 수 있는 occupied 플래그가 없고, match는 두 경우를 모두 처리할 때까지 컴파일되지 않습니다. 오류 타입도 마찬가지로 정확합니다. 사용 완료 집합은 두 가지 방식(DoubleSpend와 Full)으로 실패할 수 있으며, SpendError는 정확히 그 둘만 나타냅니다.
GCRA: 정수 하나로 하는 속도 제한
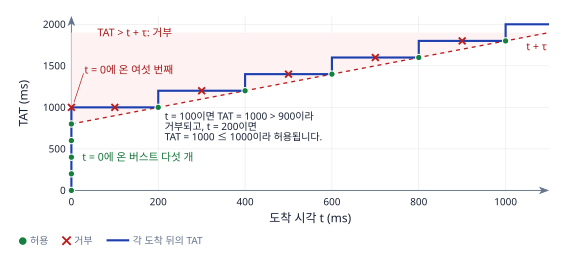
Generic Cell Rate Algorithm(ATM Forum, 1996)은 누출 버킷의 가상 스케줄링 형태입니다. 클라이언트마다 이론적 도착 시각(TAT) 하나를 저장합니다. 윈도 \(W\)당 양의 한도 \(N\)에 대해 방출 간격 \(T = \max(1, \lceil W / N \rceil)\), 버스트 허용치 \(\tau = (N - 1) T\)로 두면 다음과 같습니다.
fn arrive(
    cells: &mut [Cell; SLOTS_PER_SHARD],
    key: u64,
    now_ms: u64,
    limits: Limits,
) -> Decision {
    let interval = limits.emission_interval();
    let tau = limits.burst_tolerance();
    let Some(cell) = locate(cells, key, now_ms, tau) else {
        return Decision {
            limited: true,
            capacity_exhausted: true,
            retry_after_ms: interval,
            remaining: 0,
        };
    };
    let tat = cell.tat_ms.max(now_ms);
    let horizon = now_ms.saturating_add(tau);
    if tat > horizon {
        return Decision {
            limited: true,
            capacity_exhausted: false,
            retry_after_ms: tat - tau - now_ms,
            remaining: 0,
        };
    }
    cell.tat_ms = tat.saturating_add(interval);
    // ... remaining = min(rate, floor((t + tau - TAT) / T) + 1)
}
샤드의 check는 락을 잡고, 락으로 보호된 셀을 넘겨 arrive를 호출합니다. check가 반환되면 가드가 락을 풉니다. 셀은 16바이트(키와 TAT)이며, 16슬롯 탐사 윈도을 가진 512슬롯 샤드 16개에 있어 모두 합쳐 약 128 KiB입니다. TAT가 \(t - \tau\)보다 오래된 셀은 이미 다 빠진 상태이므로 그 자리에서 회수됩니다. Retry-After 헤더도 같은 산술로 계산합니다. 탐사 윈도이 가득 차면 활성 할당량 상태를 쫓아내는 대신 새 클라이언트를 거부하며, 결정이 그 사실을 알립니다(capacity_exhausted). 그래서 호출자는 포화로 인한 거부를 차단으로 격상하지 않습니다. 설정된 속도가 0이면 요청을 거부합니다. 제한기 하나가 여러 규칙을 처리합니다. 셀 키는 규칙의 범위를 시드로 한 클라이언트 주소의 Wyhash이므로, 서로 다른 범위의 같은 클라이언트는 독립된 예산을 가집니다.
버전이 있는 차단 테이블
차단에는 원자적 버전, 키, 만료 필드를 가진 슬롯 4,096개를 쓰며, 차단된 주소의 키 기반 해시로 8슬롯 탐사 윈도의 개방 주소 방식을 씁니다. 쓰는 쪽은 뮤텍스로 다른 쓰는 쪽과 직렬화되며, 갱신마다 앞뒤로 버전을 증가시킵니다. 읽는 쪽은 락을 잡지 않고, 안정된 짝수 버전만 받아들이며, 동시 변경이 있으면 재시도합니다.
pub fn ban(&self, banned: &[u8], until: u64, now: u64) {
    let key = slot_key(banned);
    let _writers = self.lock_writers();
    let victim = &self.slots[self.victim(key, now)];
    // 키와 만료 시각은 논리적으로 한 값이다. 교체하는 동안 버전을 홀수로
    // 두어, 읽는 쪽이 옛 키와 다음 키의 만료 시각을 섞지 못하게 한다.
    victim.version.fetch_add(1, Ordering::SeqCst);
    victim.until.store(until, Ordering::SeqCst);
    victim.key.store(key, Ordering::SeqCst);
    victim.version.fetch_add(1, Ordering::SeqCst);
}

fn read_slot(&self, slot: &Slot) -> (u64, u64) {
    loop {
        let before = slot.version.load(Ordering::SeqCst);
        if before & 1 != 0 {
            std::hint::spin_loop();
            continue;
        }
        let key = slot.key.load(Ordering::SeqCst);
        let until = slot.until.load(Ordering::SeqCst);
        if before == slot.version.load(Ordering::SeqCst) {
            return (key, until);
        }
    }
}
순차 일관성은 옛 식별자와 새 만료 시각이 섞이는 것을 막습니다. 모든 접근이 하나의 전체 순서에 속하므로 논증이 단순해집니다. 읽는 쪽은 뮤텍스를 잡지 않지만 쓰는 쪽을 기다릴 수 있으므로 wait-free는 아닙니다. 이 원자적 연산에는 실제 비용이 있으며, 공짜라고 가정하지 않고 HTTP 하니스에서 간접적으로 측정합니다. 탐사 윈도이 가득 차면 만료된 슬롯을, 없으면 가장 먼저 만료되는 슬롯을 덮어씁니다. clear는 모든 차단을 풀지만 키는 그대로 둡니다. 비운 슬롯은 탐사 연쇄에서 뒤에 있는 충돌 키를 숨길 수 있기 때문입니다.
MPSC 인시던트 링
Shield 운영 구성이 요청을 거부하거나 허니팟이 작동하면, 인시던트는 약 1.3 KB짜리 고정 레코드(클라이언트 주소, User-Agent, 메서드, 경로, 범주, 페이로드이며, 각각 용량에서 잘림)에 복사되어 크기가 제한된 다중 생산자 단일 소비자 링(Vyukov의 시퀀스 표식 설계, 슬롯 512개, BoundedQueue<IncidentRecord, 512>)에 들어갑니다. 생산자는 연결 스레드이고 소비자는 저장소 스레드입니다. 링이 가득 차면 응답을 막는 대신 가장 새로운 레코드를 버립니다. 이는 영속성 보장이 아니라 명시적인 손실 정책입니다. 버린 레코드를 세는 카운터로 그 손실을 관찰할 수 있습니다.
/// `incident`를 링에 복사한다. 링이 가득 차면 버리고 버린 횟수를 센다.
pub(crate) fn record(&self, incident: &Incident<'_>) {
    if self.queue.push(IncidentRecord::from_incident(incident)).is_err() {
        self.metrics.incidents_dropped.bump();
    }
}
레코드를 대기 중인 배치로 옮긴 뒤, 저장소 스레드는 커밋이 확인될 때까지 준비된 행과 함께 레코드를 보관합니다. 데이터베이스 오류가 나도 조용히 버리지 않으며, 재시도는 똑같은 배치를 씁니다.
각 슬롯에는 시퀀스 번호가 있어, 생산자에게는 슬롯이 비었는지를, 소비자에게는 슬롯이 찼는지를 알려 주므로 어느 쪽도 락을 잡지 않습니다. 이런 링은 안전한 Rust로 작성할 수 없습니다. 생산자와 소비자가 한 배열의 서로 다른 슬롯을 동시에 건드리며, 어떤 스레드가 어떤 슬롯을 건드려도 되는지는 타입 시스템이 아니라 시퀀스 프로토콜만이 증명하기 때문입니다. 그래서 crates/store/src/ring.rs 모듈은 값을 UnsafeCell<MaybeUninit<T>> 슬롯에 담고, 각 unsafe 블록은 자신을 정당화하는 프로토콜 단계를 밝힙니다.
if diff == 0 {
    // Relaxed: CAS는 어느 생산자가 위치 `pos`를 차지할지만 정한다.
    match self.tail.0.compare_exchange_weak(
        pos, pos.wrapping_add(1), Ordering::Relaxed, Ordering::Relaxed,
    ) {
        Ok(_) => {
            // SAFETY: CAS로 이 스레드가 위치 `pos`를 얻었고,
            // `sequence == pos`는 슬롯이 비었음을 뜻한다. 다른 생산자는
            // `pos`를 차지할 수 없고, 소비자는 아래의 Release 저장 전에는
            // 이 슬롯을 읽지 않는다.
            unsafe { (*slot.value.get()).write(value) };
            // Release: 쓴 값을 소비자에게 게시한다.
            slot.sequence.store(pos.wrapping_add(1), Ordering::Release);
            return Ok(());
        }
        Err(current) => pos = current,
    }
} else if diff < 0 {
    return Err(value);
}
링의 두 가지 규약은 주석이 아니라 타입입니다. 링이 가득 차면 push는 Err(value)를 반환해 레코드를 되돌려 주므로, 호출자가 셀지 버릴지 정합니다. false만 반환한다면 레코드를 잃습니다. 링에는 소비자가 하나뿐이며, pop은 &mut self를 받고, 공유 코드는 먼저 유일한 Consumer를 차지해야 하므로, 두 번째 소비자는 컴파일되지 않거나 실행 중에 거부됩니다.
Read-Copy-Update 엔진 게시
정책 엔진은 정책이 바뀔 때 핫 패스 밖에서 다시 만들어집니다. 요청은 절반만 만들어진 엔진을 결코 보아서는 안 되고, 요청이 아직 읽고 있는 엔진을 해제해서도 안 됩니다. Sibuna는 각 엔진을 EngineSlot 안의 Arc<Engine>으로 게시하며, 각 연결은 EngineCache를 통해 이를 읽습니다.
pub struct EngineSlot {
    current: RwLock<Arc<Engine>>,
    generation: AtomicU64,
}

pub fn publish(&self, engine: Engine) {
    let fresh = Arc::new(engine);
    let previous = {
        let mut current =
            self.current.write().unwrap_or_else(PoisonError::into_inner);
        std::mem::replace(&mut *current, fresh)
    };
    self.generation.fetch_add(1, Ordering::Release);
    // 옛 엔진은 락 밖에서 버린다(이것이 마지막 보유자였다면).
    drop(previous);
}

pub struct EngineCache {
    generation: u64,
    engine: Option<Arc<Engine>>,
}

pub fn refresh(&mut self, slot: &EngineSlot) -> &Engine {
    let generation = slot.generation();
    if self.generation != generation {
        // 위의 읽기와 이 복제 사이에 게시가 일어나면 새 엔진에 옛 세대 번호가
        // 붙는다. 그러면 다음 갱신이 다시 읽으면 된다.
        self.generation = generation;
        self.engine = None;
    }
    self.engine.get_or_insert_with(|| slot.load())
}
세대는 엔진이 자리 잡은 뒤 release 순서로 저장되고 acquire 순서로 읽힙니다. 새 세대를 본 읽는 쪽은 그 전에 저장된 엔진도 봅니다. 주석에 적힌 경쟁 상태는 무해합니다. 읽는 쪽이 세대를 읽은 뒤 복제하기 전에 게시가 일어나면, 읽는 쪽은 더 새로운 엔진을 더 오래된 세대 번호 아래에 캐시하게 되고, 다음 갱신 때 불일치를 알아차려 다시 읽습니다. 읽는 쪽은 요청 하나 동안 엔진 하나만큼 늦을 수는 있어도, 절반만 만들어진 엔진을 볼 수는 없습니다. 슬롯에는 완성된 엔진만 저장되기 때문입니다.
왜 그냥 락을 쓰지 않고 캐시를 쓸까요? SID 0010은 스레드 16개로 읽기 비용을 측정해 RwLock<Arc<Engine>>과 안전한 Rust로 만든 락 프리 대안 중에서 고르도록 요구했습니다. 락을 거쳐 읽으면 락 워드와 참조 카운트를 건드리는데, 이 둘은 모든 코어가 쓰기를 하는 캐시 라인 두 개입니다. 반면 세대는 게시할 때 한 번 쓰이고 그 밖에는 읽히기만 하므로, 각 코어가 자기 사본을 유지합니다.
| 읽기 방식 | 스레드 1개 | 스레드 16개 |
|---|---|---|
RwLock 읽기 가드만 |
4.2 ns | 752 ns |
RwLock 읽기와 Arc 복제 |
7.6 ns | 833 ns |
캐시된 Arc로 세대 확인 |
0.8 ns | 1.8 ns |
경합 상황에서 캐시를 통한 읽기는 락보다 400배 넘게 저렴하므로, 요청 경로는 캐시를 쓰고 RwLock은 갱신의 느린 경로에서만 씁니다. 측정은 cmd/sibuna/src/slot.rs에 있는, 기본적으로 실행되지 않는(ignored) 테스트 read_cost_under_contention입니다. 요청 경로에서 쓸 때마다 갱신하므로, 요청은 각 단계 시점의 최신 엔진을 봅니다. 엔진 자체는 작습니다. 압축된 힙 테이블 209,052바이트, 약 204 KiB이며(benchmarks/results/primitives-latest.json의 engine_bytes), 규칙 128개, 128바이트 규칙 이름, 트라이 노드 8,192개를 담을 용량이 있습니다.